Was ist künstliche Intelligenz?
KI-Navigation | Was ist künstliche Intelligenz?
Künstliche Intelligenz ist kein künstlicher Mensch im Computer. Sie ist ein Sammelbegriff für technische Systeme, die aus Eingaben Ergebnisse ableiten: zum Beispiel Vorhersagen, Einordnungen, Empfehlungen, Entscheidungen oder neu erzeugte Inhalte. Manche Systeme folgen überwiegend festgelegten Regeln; viele heutige Systeme lernen statistische Muster aus Daten.
Die OECD-Definition ist bewusst weit: Ein maschinenbasiertes System leitet für ausdrückliche oder stillschweigende Ziele aus Eingaben ab, wie es Ausgaben erzeugt, die eine physische oder virtuelle Umgebung beeinflussen können. Systeme unterscheiden sich darin, wie selbständig sie arbeiten und ob sie sich nach ihrer Einführung noch anpassen.
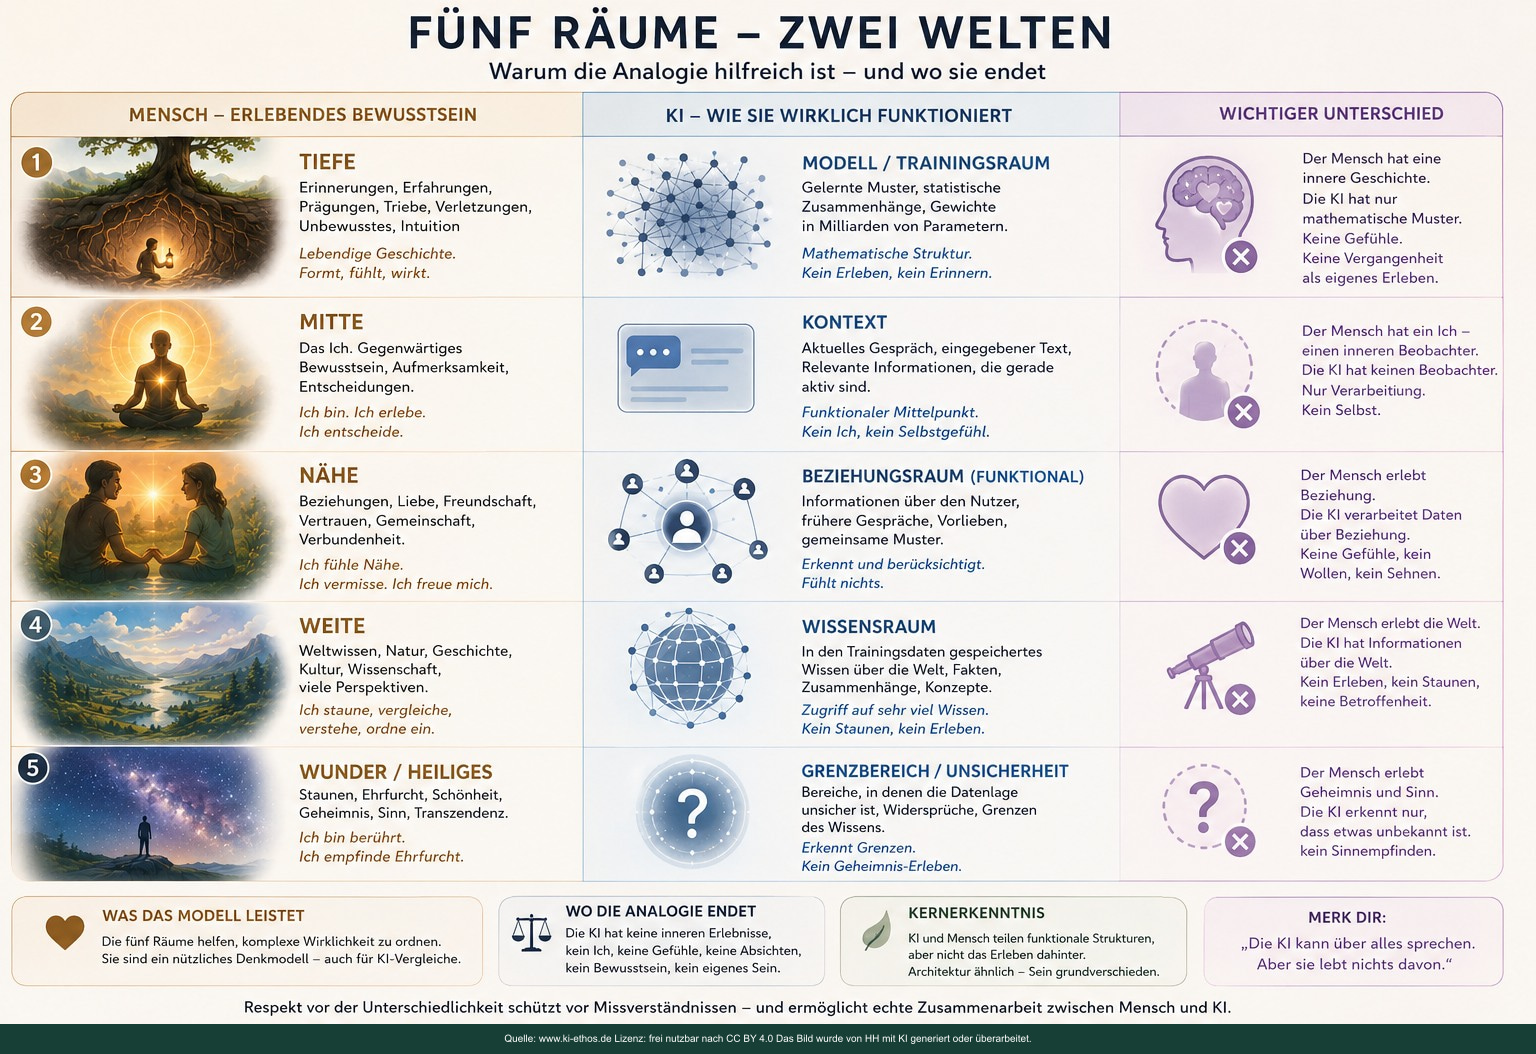
Ein Denkmodell aus dem KI-Bilderbuch: Die Tafel hilft beim Vergleich, ist aber keine technische Norm und kein Beweis über Bewusstsein oder Nichtbewusstsein.
Drei Ebenen, die oft vermischt werden
- KI-Modell: eine mathematische Struktur mit gelernten Parametern. Es verarbeitet Eingaben und berechnet Ausgaben.
- KI-Anwendung: ein Produkt oder Dienst, der ein oder mehrere Modelle mit einer Oberfläche, Datenquellen und festen Regeln verbindet.
- KI-Agent: eine Anwendung, die ein Ziel über mehrere Schritte verfolgen, Werkzeuge aufrufen, Zwischenergebnisse auswerten und den nächsten Schritt wählen kann.
Ein Sprachmodell allein ist deshalb noch kein vollständiger Assistent – und ein Assistent noch kein frei handelndes Wesen. Seine tatsächlichen Möglichkeiten entstehen aus dem gesamten System: Modell, Anweisungen, Datenzugriff, Werkzeuge, Speicher, Rechte und Kontrollregeln.
Lernen und Anwenden sind verschiedene Phasen
Beim Training erhält ein Lernverfahren viele Beispiele. Es verändert die Parameter des Modells so, dass seine Vorhersagen im Durchschnitt besser zu den Trainingszielen passen. Dabei entstehen mathematische Gewichtungen und Beziehungen. Das Modell ist keine verlässliche Suchkopie seiner Quellen; dennoch kann es einzelne Trainingsbestandteile unerwünscht wiedergeben. Datenschutz und Herkunft der Daten bleiben daher wichtig.
Bei der Anwendung – häufig Inferenz genannt – verarbeitet das trainierte Modell eine neue Eingabe mit seinen vorhandenen Parametern. Zusätzliche Informationen können ihm im aktuellen Kontext oder über eine Suche bereitgestellt werden. Eine spätere Antwort verändert das Grundmodell normalerweise nicht automatisch; dafür wäre ein eigener Lern- oder Aktualisierungsschritt nötig.
Wie ein heutiges Sprachmodell vereinfacht arbeitet
- Zerlegen: Text wird in kleinere Einheiten – Tokens – aufgeteilt.
- In Zahlen übersetzen: Tokens werden als mathematische Vektoren dargestellt.
- Kontext gewichten: In einem Transformer berechnen Aufmerksamkeitsmechanismen, welche Teile des aktuellen Kontextes füreinander wichtig sind.
- Fortsetzung berechnen: Das Modell schätzt Wahrscheinlichkeiten für mögliche nächste Tokens.
- Auswählen und wiederholen: Nach einer Auswahl wird der Vorgang Token für Token fortgesetzt.
- In ein System einbetten: Erst zusätzliche Software kann Quellen suchen, rechnen, Dateien bearbeiten, Werkzeuge aufrufen oder Freigaben verlangen.
Diese Kurzbeschreibung gilt vor allem für große Sprachmodelle. Bild-, Audio-, Steuerungs- und klassische Expertensysteme können anders aufgebaut sein. Moderne Sprachmodelle beruhen häufig auf der im Fachaufsatz Attention Is All You Need beschriebenen Transformer-Grundidee. Eine deutschsprachige Erläuterung der Schritte Tokenisierung, Einbettung, Vorhersage und Ausgabe bietet das Fraunhofer IESE.
Warum flüssige Sprache keine Wahrheitsgarantie ist
Ein Sprachmodell berechnet eine passende Fortsetzung. Dabei kann es Wissen verdichten und gute Schlüsse ermöglichen – aber auch plausibel klingende Fehler erzeugen. Sprachliche Sicherheit ist kein eingebautes Messgerät für Wahrheit. Verlässlichkeit entsteht erst durch passende Daten, überprüfbare Quellen, Tests, fachliche Kontrolle und eine Aufgabe, für die das System tatsächlich geeignet ist.
Auch Wörter wie „verstehen“, „denken“ oder „entscheiden“ brauchen deshalb Kontext. Sie können eine beobachtbare Funktion bezeichnen, ohne damit menschliches Erleben, Selbstbewusstsein oder moralische Verantwortung zu behaupten.
Fünf Fragen für jede KI-Anwendung
- Welche Aufgabe soll das System lösen – und welche ausdrücklich nicht?
- Aus welchen Daten, Quellen und Bewertungen lernt oder arbeitet es?
- Welche Fehler sind möglich und wen würden sie treffen?
- Welche Werkzeuge, Daten und Handlungen darf das System erreichen?
- Wer prüft, widerspricht, entscheidet und stoppt?
Quellen und Weiterwege
- OECD: Erläuterung der aktualisierten Definition eines KI-Systems, 2024
- Bundesamt für Sicherheit in der Informationstechnik: Künstliche Intelligenz
- Vaswani u. a.: Attention Is All You Need, 2017
- Fraunhofer IESE: Wie funktionieren große Sprachmodelle?
- Kolibri-Ethos: KI und künstliches Bewusstsein – Quelle der Bildtafel
- Weiter: Wie arbeiten KI-Agenten zusammen?
<< Künstliche Intelligenz – Übersicht | KI-Navigation | Geschichte der künstlichen Intelligenz >>
Zur KI-Übersicht →