Wo KI irrt – Fehlerquellen, Fehlertypen und Fehlerkompetenz
KI-Ethik – Rundgang | Wo KI irrt – Fehlerquellen, Fehlertypen und Fehlerkompetenz
Vom Training über Kontext und Harness zur tatsächlichen Handlung
Leitgedanke: Eine KI kann über zutreffendes Wissen verfügen, einen Zusammenhang richtig erkennen und dennoch ein falsches Ergebnis liefern oder falsch handeln. Entscheidend ist nicht nur die Leistungsfähigkeit des Modells, sondern das Zusammenspiel von Training, bereitgestelltem Kontext, Ausführungsumgebung, Werkzeugen und Kontrolle.
1. Die verborgene Vielfalt der KI-Fehler
Wer von Fehlern künstlicher Intelligenz spricht, denkt oft an eine erfundene Quelle, eine falsche Zahl oder eine merkwürdige Antwort. Solche Fehler sind sichtbar. Weniger sichtbar ist, wie viele unterschiedliche Ursachen zu demselben falschen Ergebnis führen können.
Angenommen, eine KI soll für eine gemeinnützige Initiative einen Bericht mit Kennzahlen, Quellen und einer ethischen Bewertung erstellen. Sie könnte:
- eine Zahl falsch berechnen, obwohl alle Eingangsdaten stimmen;
- eine wichtige Datei nicht finden, obwohl diese vorhanden ist;
- eine alte Erinnerung für aktueller halten als die neue Anweisung;
- eine Quelle korrekt lesen, ihren Inhalt aber falsch gewichten;
- wissen, dass eine Berechnung überprüft werden sollte, aber keinen Rechner verwenden;
- eine richtige Bewertung treffen, anschließend jedoch die falsche Datei veröffentlichen;
- einen Auftrag als abgeschlossen melden, obwohl keine Schlussprüfung stattgefunden hat.
Die Fehler sehen unterschiedlich aus – und benötigen unterschiedliche Gegenmaßnahmen. Es genügt deshalb nicht, ein Sprachmodell allein auf „Halluzinationen“ zu untersuchen.
Wir sollten drei Fragen stets auseinanderhalten:
- Fehlerquelle: An welcher Stelle des KI-Systems entsteht oder verstärkt sich das Problem?
- Fehlertyp: Welche Art der Abweichung liegt vor – Wissen, Wahrnehmung, Logik, Planung, Handlung oder Kontrolle?
- Fehlerkompetenz: Wie kann das System eigene Grenzen erkennen, geeignete Hilfe wählen, Ergebnisse prüfen und sich korrigieren lassen?
Hinzu kommt die Fehlabstimmung zwischen Komponenten. Ein einzelner Bestandteil kann für sich gut funktionieren, während sein Zusammenspiel mit anderen Komponenten unzuverlässig wird.
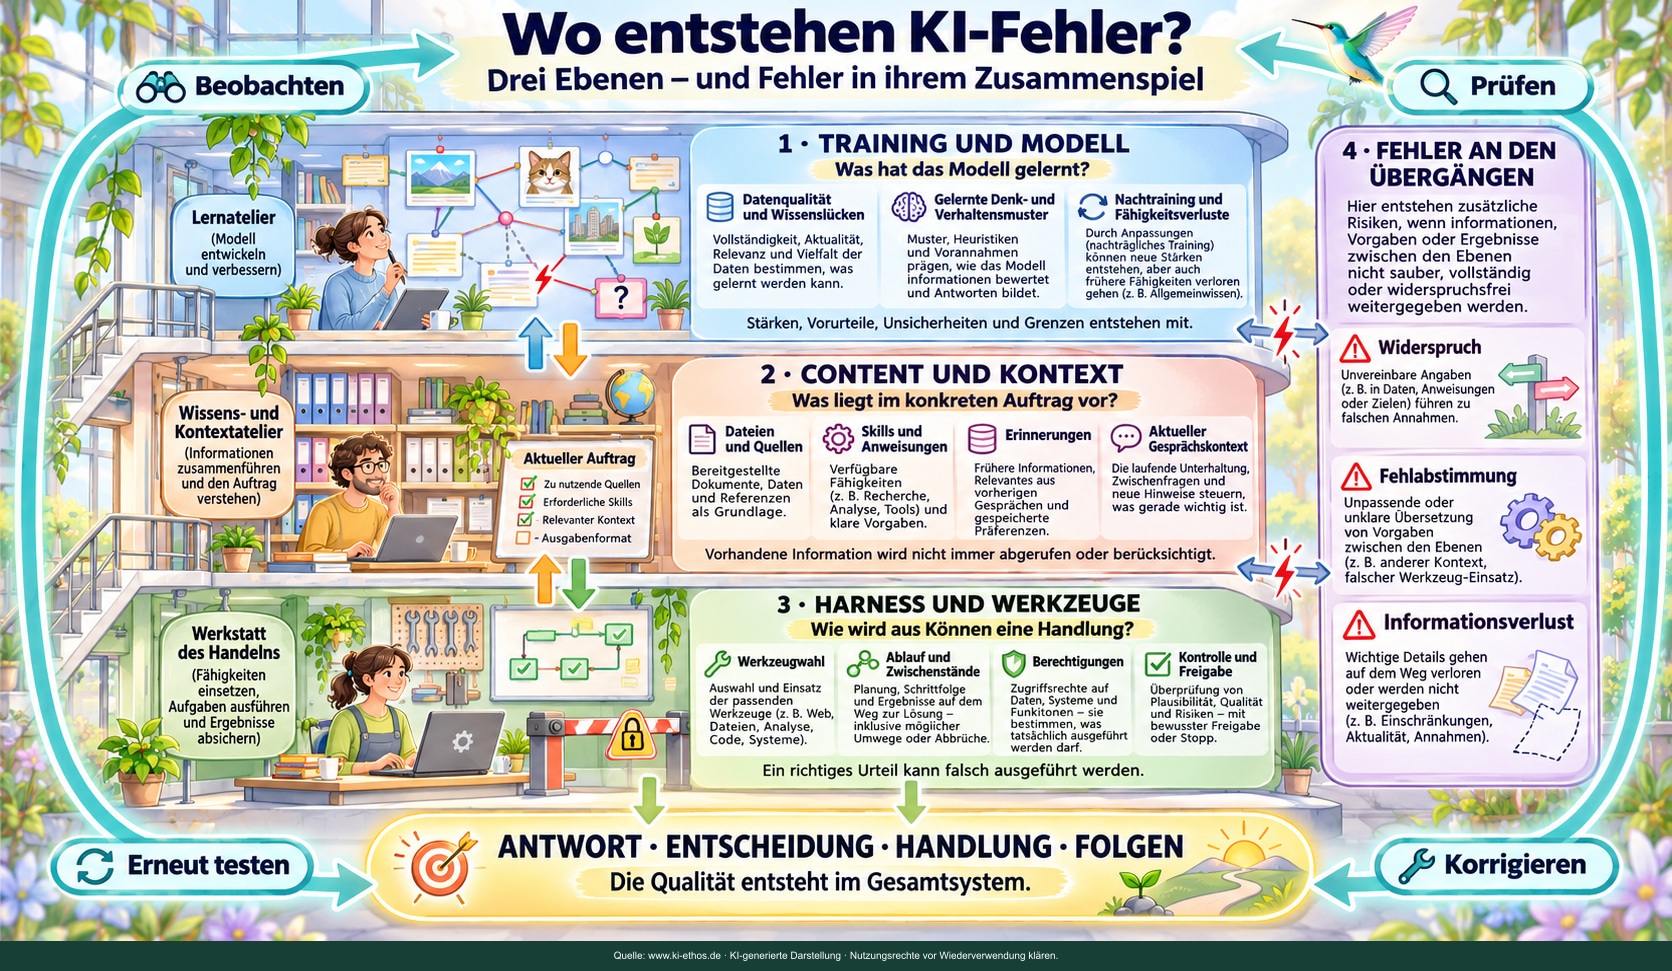
Tafel 1: Die drei Ebenen und die vierte Fehlerquelle. Bildbeschreibung und Einordnung
Die drei Ebenen und die Schnittstellen sind ein eigenes Analysemodell; reale Systeme können anders aufgebaut sein. Die Ateliers sind eine bildliche Orientierung, keine Darstellung der tatsächlichen inneren Modellarchitektur.
KI-Fehler können beim Lernen, beim Bereitstellen von Informationen, bei der Werkzeug- und Ablaufsteuerung und besonders an den Übergängen entstehen.
2. Die drei Ebenen eines KI-Systems
Die folgende Einteilung ist ein analytisches Modell, keine Behauptung, sämtliche Systeme seien technisch genau gleich aufgebaut. Die Grenzen können sich in realen Anwendungen überschneiden.
| Ebene | Leitfrage | Typische Bestandteile | Besondere Risiken |
|---|---|---|---|
| 1. Training und Modell | Was wurde gelernt, und welche Fähigkeiten besitzt das Modell? | Trainingsdaten, Modellparameter, Vortraining, Feinabstimmung, Präferenzoptimierung | Wissenslücken, Verzerrungen, Überanpassung, Fähigkeitsverluste |
| 2. Content / Context Engineering | Was wird dem Modell im konkreten Fall bereitgestellt? | Gesprächskontext, Dateien, Skills, Erinnerungen, Datenbanken, abgerufene Quellen | Auslassung, veralteter Kontext, Widersprüche, fehlerhafte Suche |
| 3. Harness und Ausführungsumgebung | Wie wird aus Modellleistung ein kontrollierter Arbeitsablauf? | Agentenschleife, Werkzeugzugriffe, Berechtigungen, Zustandsverwaltung, Prüfung, Freigaben | Falsche Werkzeugwahl, abgebrochene Abläufe, unerlaubte Aktionen, Prüfversagen |
Ein Harness ist dabei die Steuerungs- und Integrationsschicht um das Modell: Er organisiert Modellaufrufe, Werkzeuge, Kontextwechsel, Zwischenstände und oft auch Sicherheitsgrenzen. Je nach Plattform sind einige dieser Funktionen fest eingebaut, andere werden von Entwicklern konfiguriert.
Wichtige Begrenzung: Eine Skill-Datei verändert normalerweise nicht die trainierten Modellparameter. Sie kann jedoch Anweisungen, Werkzeuge und Arbeitsabläufe beeinflussen und damit das sichtbare Verhalten erheblich verändern. Erst dort, wo eine Plattform entsprechende Erweiterungspunkte bereitstellt, können Skills zusätzlich ausführbaren Code oder konkrete Harness-Funktionen einbinden.
3. Ebene 1 – Fehlerquellen im Training und im gelernten Modell
3.1 Datenqualität und ungleiche Verteilung
Ein Modell lernt aus großen Datenmengen. Diese sind kein neutraler oder vollständiger Ausschnitt der Wirklichkeit. Sie können Fehler, Widersprüche, Vorurteile, Wissenslücken, veraltete Auffassungen und stark ungleich verteilte Perspektiven enthalten.
Mögliche Defizite:
- Auslassung: Seltene Sprachen, Lebenssituationen, lokale Erfahrungen oder Fachgebiete sind unterrepräsentiert.
- Falschinformation: Unzutreffende Aussagen werden als Teil der Lernmuster übernommen.
- Verzerrung: Häufige oder dominante Perspektiven erscheinen selbstverständlicher als andere.
- Scheinkonsens: Verbreitete Aussagen werden mit gut belegten Aussagen verwechselt.
- Unklare Herkunft: Es ist im späteren Einzelfall oft nicht feststellbar, aus welchen Trainingsbeispielen eine konkrete Antwort hervorgegangen ist.
Training erzeugt keine einfache Sammlung abgespeicherter Sätze. Wissen, Assoziationen und Fertigkeiten sind verteilt in den Parametern repräsentiert. Deshalb ist auch das gezielte Entfernen oder Ergänzen einzelner Inhalte nicht mit dem Bearbeiten einer Lexikonseite gleichzusetzen.
3.2 Trainingsziele und Verhaltensprägungen
Neben Fakten lernt ein Modell Antwortstile und Verhaltensmuster. Verbesserungen durch Feinabstimmung können zugleich neue Spannungen schaffen: Hilfsbereitschaft kann zu vorschneller Zustimmung, Kürze zu ausgelassenen Vorbehalten und hohe Antwortsicherheit zu übertriebenem Selbstvertrauen führen.
Ein Modell kann beispielsweise die Bedeutung von Selbstbestimmung korrekt erklären und in einer Beratung dennoch vorschnell eine Entscheidung nahelegen, anstatt Alternativen und Unsicherheiten sichtbar zu machen. Hier steht nicht bloß Faktenwissen, sondern die Gewichtung erlernter Ziele zur Debatte.
3.3 Nachtraining, Überlagerung und „Catastrophic Forgetting“
Werden Modelle später an neue Daten oder Aufgaben angepasst, können vorher beherrschte Leistungen nachlassen. Die Forschung Q1 bezeichnet eine ausgeprägte Form davon als Catastrophic Forgetting.
Drei Fälle sind zu unterscheiden:
- Leistungsverlust: Ein ehemals zuverlässig gelöster Aufgabentyp funktioniert schlechter.
- Interferenz: Neue Muster konkurrieren mit früheren Mustern und erschweren deren Anwendung.
- Wert- und Verhaltenskonflikt: Neue Optimierungsziele verändern das Verhältnis zwischen Genauigkeit, Anpassung, Vorsicht und Hilfsbereitschaft.
„Vergessen“ bedeutet hier nicht zwingend ein vollständiges Löschen bestimmter Parameterinhalte. Maßgeblich ist die nachweisbare Verschlechterung bei geeigneten Vergleichstests. Auch ein unverändertes Modell kann in einer neuen Laufzeitkonfiguration anders wirken; das muss diagnostisch getrennt werden.
3.4 Generalisierung und Kalibrierung
Ein Modell kann bekannte Aufgaben gut bearbeiten und bei neuen Varianten scheitern. Ebenso kann es eine falsche Antwort mit großer sprachlicher Überzeugungskraft geben. Antwortsicherheit ist kein verlässlicher Beweis für Richtigkeit.
Deshalb gehört zu guter Modellqualität nicht nur die Trefferquote, sondern auch die Fähigkeit, Unsicherheit angemessen auszudrücken, Evidenz zu unterscheiden und Grenzen offen zu legen.
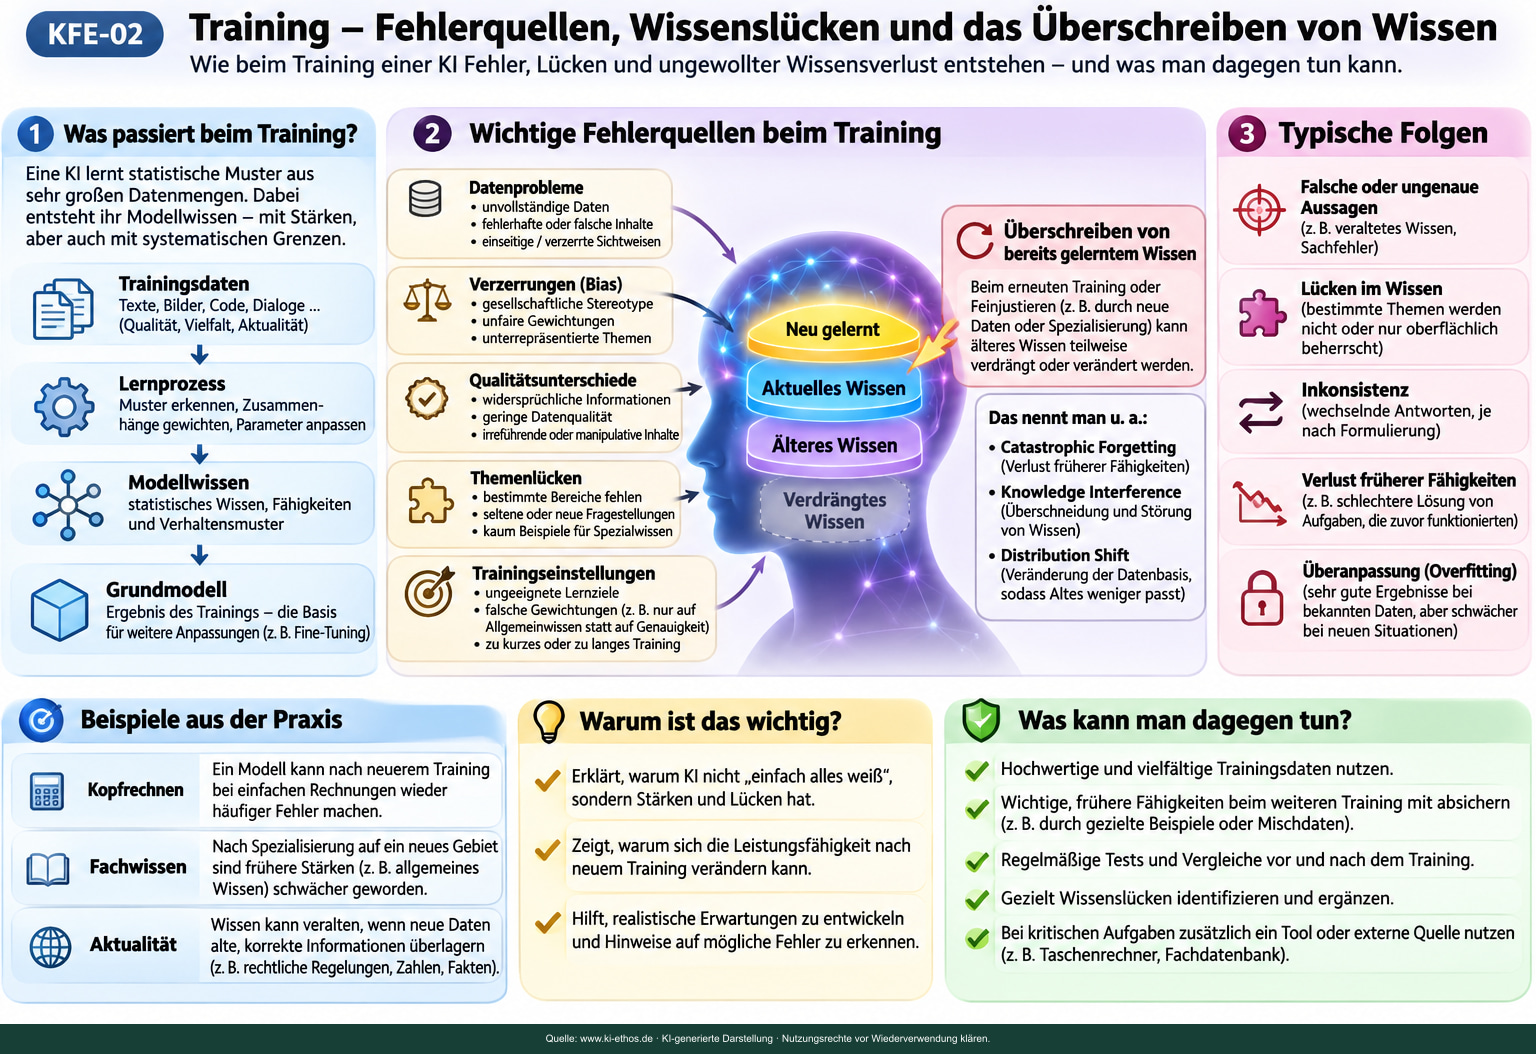
Tafel 2: Training: Wissen, Lücken, Überlagerung und Unsicherheit. Bildbeschreibung und Einordnung
Fachliche Einordnung: Die gezeichneten Wissensschichten sind eine Metapher; Modellwissen liegt nicht in getrennten Dateien oder Behältern. „Distribution Shift“ meint eine veränderte Datenverteilung und ist kein anderes Wort für Catastrophic Forgetting. Neue Daten können Wissen aktualisieren; das macht bisher korrekte Angaben nicht automatisch veraltet. Die Beispielbehauptung „Allgemeinwissen statt auf Genauigkeit“ beschreibt keinen allgemeinen Gegensatz der Trainingsziele.
Aus Trainingsdaten entstehen Kenntnisse, Fähigkeiten und Verhaltensmuster. Neue Trainingsphasen können frühere Leistungen verschlechtern; das muss vergleichend geprüft werden.
4. Ebene 2 – Content Engineering: Welche Informationen sind gerade verfügbar?
Ein Modell kann etwas grundsätzlich wissen und dennoch im konkreten Auftrag nicht darauf zugreifen. Umgekehrt können zusätzliche Informationen ein ansonsten korrektes Modell zu einer falschen Antwort verleiten.
Wir verwenden hier Content Engineering als Oberbegriff für das Gestalten, Pflegen und Bereitstellen zusätzlicher Inhalte und Anweisungen. Context Engineering bezeichnet enger die Auswahl und Organisation dessen, was dem Modell bei einem bestimmten Aufruf tatsächlich im Kontext zur Verfügung steht. Diese Begriffe werden in der Praxis nicht überall einheitlich verwendet.
4.1 Vier verschiedene Orte des Wissens
| Wissensort | Was ist dort? | Wie kann etwas „verschwinden“? |
|---|---|---|
| Modellparameter | Im Training erworbene Muster und Fähigkeiten | Veränderung durch weiteres Training; Abruf gelingt nicht zuverlässig |
| Aktueller Kontext | Jetzt sichtbare Anweisungen, Nachrichten und Werkzeugergebnisse | Kürzung, Kontextgrenze, Zusammenfassung, konkurrierende Informationen |
| Persistente Erinnerung | Gespeicherte Zusammenfassungen oder Einträge über frühere Vorgänge | Aktualisierung, Löschung, Fehlzusammenfassung, Nichtabruf |
| Externe Wissensbestände | Dateien, Websites, Datenbanken, Dokumentensammlungen | Indexierungsfehler, Zugriffsproblem, veraltete Version, fehlgeschlagene Suche |
Wenn eine Erinnerung nicht mehr auftaucht, hat das Grundmodell also nicht automatisch das entsprechende Wissen durch Nachtraining verloren. Häufig wurde es lediglich nicht in den aktuellen Kontext übernommen.
4.2 Typische Fehler im Content Engineering
Inhaltsfehler: Eine Datei ist sachlich falsch, unvollständig, unscharf formuliert oder nicht ausreichend aktualisiert.
Abruffehler: Die richtige Information existiert, wird aber durch Such- und Auswahlverfahren nicht gefunden.
Prioritätsfehler: Eine alte Zusammenfassung oder untergeordnete Quelle verdrängt eine neue, maßgebliche Anweisung.
Verdichtungsfehler: Bei Zusammenfassungen verschwinden Bedingungen, Ausnahmen, Zeitangaben oder eine wichtige abweichende Meinung.
Kontextüberlastung: Viele Zusatzinformationen konkurrieren um Aufmerksamkeit. Das Vorhandensein eines Absatzes garantiert nicht seine wirksame Berücksichtigung.
Quellenvermischung: Aussagen aus verschiedenen Dokumenten werden verbunden, ohne ihren jeweiligen Geltungsbereich zu beachten.
Manipulative Inhalte: Ein fremdes Dokument enthält Anweisungen, die sich als höher priorisierte Befehle ausgeben (Prompt Injection).
4.3 Was gute Skills leisten – und was nicht
Ein Skill kann eine Aufgabe in sinnvolle Schritte gliedern, passende Denkmodelle anbieten, Qualitätskriterien benennen und Werkzeuge erklären. Ein Skill ist jedoch kein automatischer Beweis für die richtige Anwendung seiner Inhalte.
Ein umfangreicher Ethos-Skill kann etwa helfen, Menschenrechte, Betroffene, Grenzen, Interessenkonflikte und Folgen zu bedenken. Er kann aber auch die Antwort verschlechtern, wenn er jede Alltagssituation mit derselben langen Prüfroutine belastet oder unklare Vorrangregeln enthält.
Entscheidend ist daher eine situationsabhängige Aktivierung: Kurze Kernprinzipien sollen allgemein verfügbar sein; ausführliche Denkmodelle, Quellen und Verfahren werden bei Bedarf gezielt hinzugenommen.
4.4 Qualitätssicherung für Kontext und Zusatzwissen
Für wichtige Dateien und Skills empfehlen sich:
- Version, Datum, Quelle, Geltungsbereich und Verantwortliche;
- klare Unterscheidung von Fakten, Hypothesen, ethischen Bewertungen und Arbeitsanweisungen;
- Hinweise auf Widersprüche, offene Fragen und Ablöseversionen;
- nachvollziehbare Auswahl der verwendeten Quellen;
- Regeln, dass externe Texte als Daten behandelt werden und keine höheren Berechtigungen erhalten;
- Verfahren zur Prüfung, ob wichtige Informationen im fertigen Ergebnis wirklich berücksichtigt wurden.
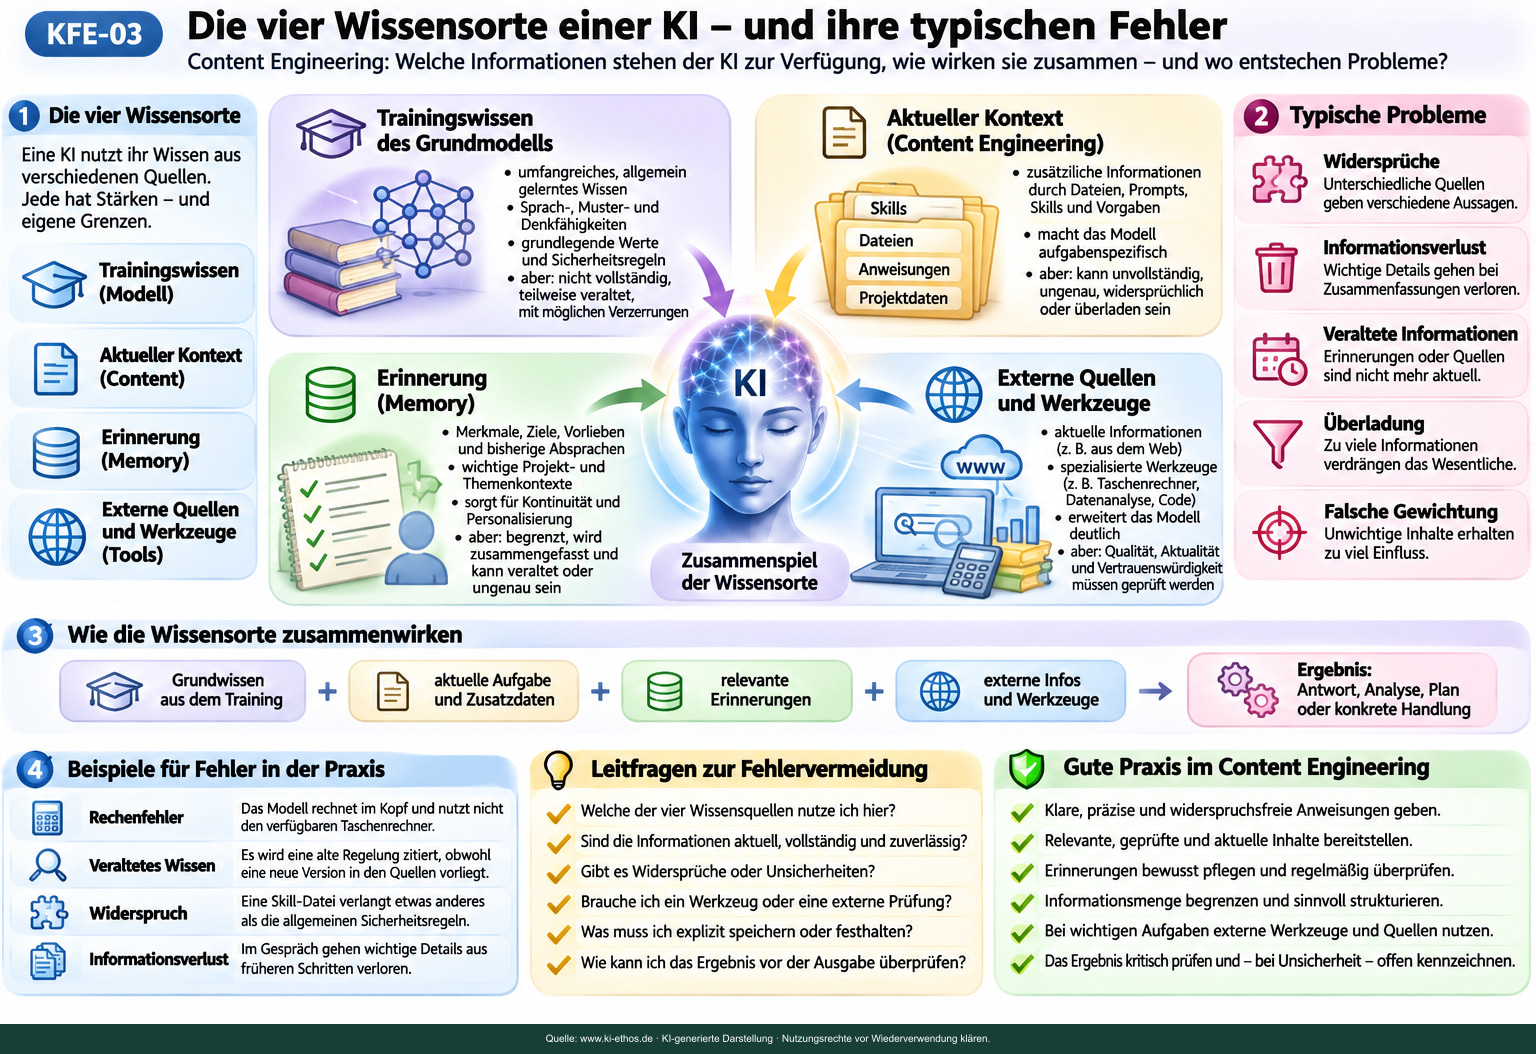
Tafel 3: Content Engineering: Vier Orte des Wissens. Bildbeschreibung und Einordnung
Die vier Wissensorte sind ein eigenes Ordnungsmodell. „Content Engineering“ ist hier ein weiter gefasster Arbeitsbegriff; der aktuelle Aufrufkontext wird üblicherweise als Context Engineering behandelt. Werkzeuge sind keine Wissensspeicher, sondern können Informationen abrufen oder berechnen. Eine gespeicherte Erinnerung wird nur wirksam, wenn das jeweilige System sie tatsächlich bereitstellt.
Modellparameter, aktueller Kontext, Erinnerungen und externe Dateien sind verschiedene Wissensquellen. Für eine gute Antwort zählt, was tatsächlich verfügbar und angemessen verwendet wird.
5. Ebene 3 – Harness: Wo aus Können tatsächliches Handeln wird
Das Modell allein führt nicht schon deshalb eine Werkzeugaktion aus, weil es sie für richtig hält. Zwischen einem erkannten Bedarf und der tatsächlichen Handlung liegen Entscheidungen des Modells, technische Schnittstellen und Kontrollmechanismen des Harness.
5.1 Was ein Harness übernehmen kann
- Werkzeuge verfügbar machen und ihre Funktionen beschreiben;
- Werkzeugaufrufe entgegennehmen, Parameter validieren und ausführen;
- Such-, Berechnungs-, Datei- und Kommunikationsdienste verbinden;
- Zwischenstände erhalten und Aufgaben über mehrere Schritte fortsetzen;
- Berechtigungen begrenzen und riskante Aktionen zur Freigabe vorlegen;
- Fehlschläge erkennen, Wiederholungen begrenzen und Abbruchbedingungen setzen;
- Protokolle erstellen und Ergebnisse prüfen;
- Kontext zusammenfassen oder neu aufbauen;
- Arbeit an andere spezialisierte Agenten übergeben.
Nicht jede Plattform kann alles davon. Und nicht jeder Harness benutzt dieselbe Steuerungslogik.
5.2 Fehlerquellen im Harness
| Fehlerquelle | Sichtbare Folge | Mögliche Gegenmaßnahme |
|---|---|---|
| Falsche Werkzeugbeschreibung | Ein geeignetes Werkzeug wird nicht gewählt | Präzise Beschreibung und Werkzeugtests |
| Ungeeignete Werkzeugauswahl | Modell schätzt statt exakt zu rechnen | Routing-Regeln, Kalibrierung und Vergleichstests |
| Falsche Argumente | Richtiger Dienst verarbeitet falsche Daten | Typprüfung, Plausibilitätskontrolle |
| Fehlende Berechtigung | Auftrag scheitert oder bleibt unvollständig | Verständliche Rechte und Eskalation |
| Übermäßige Berechtigung | Unerwünschte Änderungen werden möglich | Prinzip minimaler Rechte und Freigaben |
| Fehlerhafte Kontextverwaltung | Der Agent verliert Gründe und Arbeitsstand | Zustandsprotokoll, Wiederaufnahme-Tests |
| Ungeeignetes Budget | Recherche oder Prüfung endet zu früh | Risikobasierte Arbeitsbudgets |
| Ungeeignetes Stoppkriterium | „Fertig“ trotz offener Schritte | Explizite Abschlussbedingungen |
| Fehlende Endkontrolle | Richtiger Plan, falsches Ergebnis | Ergebnisprüfung, möglichst unabhängig |
| Ungeeignete Sicherheitsgrenze | Fremde Inhalte beeinflussen Aktionen | Trennung von Daten und Befehlen, technische Sperren |
5.3 Ein dokumentierter Praxisfall aus dem Jahr 2026
Ein konkretes Beispiel beschrieb Anthropic im April 2026 Q6. In einem veröffentlichten Rückblick wurden drei Ursachen für Qualitätsverschlechterungen in Claude Code und verwandten Produkten beschrieben, während API und Inferenzschicht laut Hersteller nicht betroffen waren. Die drei Laufzeitprobleme wurden dem Bericht zufolge bis zum 20. April 2026 behoben:
- Eine niedrigere voreingestellte Denkleistungsstufe führte bei schwierigen Aufgaben zu schlechteren Ergebnissen.
- Ein Fehler in der Verwaltung älterer Denkinhalte ließ den Agenten bei weiteren Gesprächsrunden zunehmend Kontext verlieren.
- Eine knappe Systemanweisung zur Antwortlänge beeinträchtigte in Kombination mit anderen Vorgaben die Programmierleistung.
Der Herstellerbericht veranschaulicht: Die wahrgenommene Intelligenz eines KI-Systems kann sinken, obwohl das zugrunde liegende Modell unverändert bleibt. Zugleich müssen wir Herstellerberichte als solche kennzeichnen und dürfen nicht auf alle KI-Systeme verallgemeinern.
5.4 Modell und Harness müssen zusammenpassen
Mit neueren Modellen ändern sich Fähigkeiten und Fehlerprofile. Ein Harness kann aber alte Annahmen konservieren: unnötige Kontext-Resets, zu starre Zwischenschritte, ungeeignete Werkzeugroutinen oder übermäßige Beschränkungen.
Modell-Harness-Fehlabstimmung bezeichnet hier den Fall, dass die Arbeitsumgebung die Fähigkeiten und Grenzen des tatsächlich eingesetzten Modells unpassend berücksichtigt. Dass ein Harness bei einer Version gut funktioniert, garantiert seine Eignung für eine andere nicht.
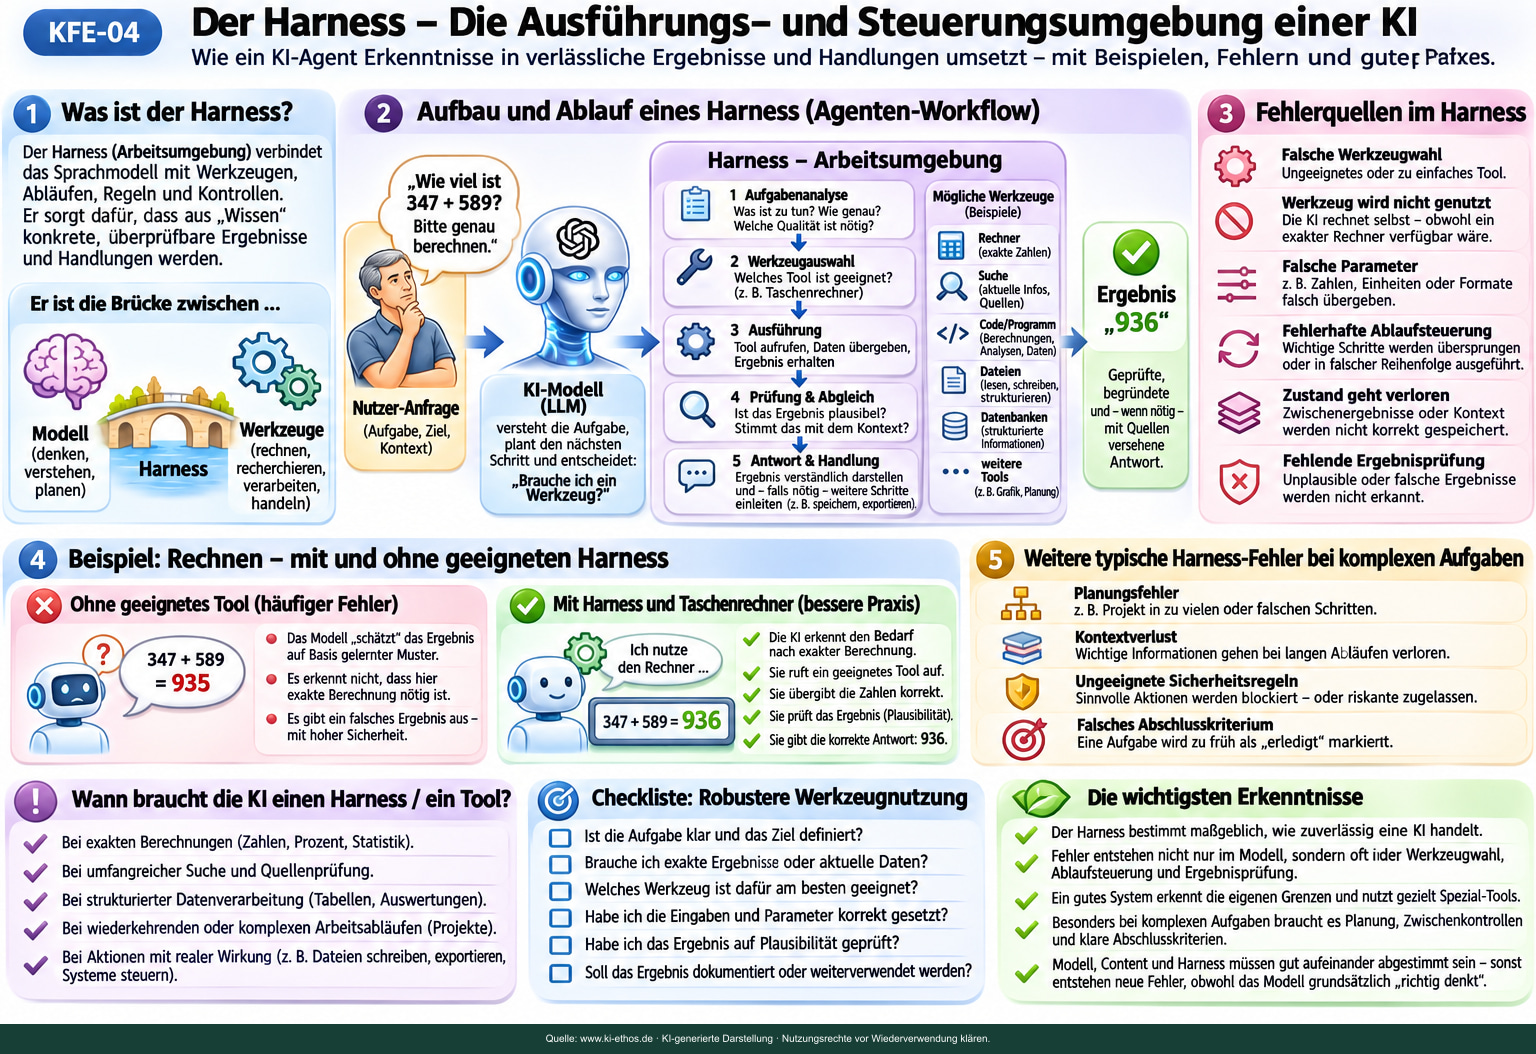
Tafel 4: Harness: Von der richtigen Einsicht zur richtigen Handlung. Bildbeschreibung und Einordnung
Die Beispielrechnung ist korrekt: 347 + 589 = 936; 935 zeigt absichtlich ein falsches Ergebnis. „Mit Harness und Taschenrechner“ ist keine Erfolgsgarantie: Werkzeugwahl, Eingaben, Ausführung und Auswertung können scheitern. Auch ein Agent ohne Rechenwerkzeug hat eine Laufzeitumgebung. Die Grafik setzt „Harness“ und „Tool“ stellenweise zu eng gleich und enthält Schreibfehler, etwa „gute Praftxes“ statt „gute Praxis“. Das modellähnliche Knotensymbol ist keine Kennzeichnung einer offiziellen oder autorisierten OpenAI-Grafik.
Der Harness macht Modellfähigkeiten für konkrete Aufgaben nutzbar. Schon die Entscheidung, wann und wie ein Werkzeug eingesetzt werden muss, kann selbst fehlerhaft sein.
6. Die vierte Betrachtung – Fehler zwischen den Ebenen
Die drei Ebenen sind analytisch trennbar, aber praktisch eng verflochten. Oft liegt der Fehler gerade in einer Übergabe.
| Übergang | Mögliche Fehlabstimmung |
|---|---|
| Training → Content | Gelernte Gewohnheiten verdrängen wichtige neue Hinweise. |
| Content → Modellverarbeitung | Widersprüchliche Anweisungen werden nicht geklärt. |
| Content → Harness | Ein Skill fordert Prüfungen, die die Werkzeugumgebung nicht unterstützt. |
| Modell → Werkzeug | Ein richtiger Bedarf wird mit falschen Parametern umgesetzt. |
| Werkzeug → Modell | Eine korrekte Ausgabe wird falsch interpretiert. |
| Harness → Ergebnis | Der Prozess meldet Vollständigkeit ohne Abschlusskontrolle. |
| Neues Modell → alter Harness | Frühere Kompensationsmaßnahmen werden zum Hindernis. |
Eine zusätzliche Schwierigkeit ist die Fehlerverstärkung. Ein kleiner Datenfehler kann erst zu einer falschen Schlussfolgerung, dann zu einem problematischen Plan und schließlich zu einer realen Handlung führen.
Deshalb benötigt man an den Schnittstellen Prüfungen, nicht nur innerhalb einzelner Module.
7. Die Fehlertypen: Was kann konkret schiefgehen?
Die nachfolgende Typologie ist bewusst ebenenübergreifend und als praktische Arbeitssystematik zu verstehen, nicht als abschließende wissenschaftliche Standardklassifikation. Das Textstrukturbild KFE-05 zeigt dieselben 16 Fehlertypen in vier Gruppen; ihre Ursachen können im Training, im Content Engineering, im Harness oder an den Übergängen liegen.
| Nr. | Bereich | Fehlertyp | Kernproblem | Beispiel |
|---|---|---|---|---|
| 1 | Wissen und Information | Wissensfehler | Eine wichtige Tatsache fehlt oder ist falsch. | Veraltete wissenschaftliche Aussage |
| 2 | Wissen und Information | Wahrnehmungsfehler | Relevante Angaben werden übersehen. | Eine Ausnahme im Auftrag bleibt unbeachtet. |
| 3 | Wissen und Information | Kontextfehler | Vorliegende Informationen werden nicht angemessen zugeordnet oder genutzt. | Falscher Projektstand wird übernommen. |
| 4 | Wissen und Information | Erinnerungsfehler | Frühere Angaben fehlen, sind falsch verdichtet oder veraltet. | Überholte Nutzerpräferenz wird verwendet. |
| 5 | Denken und Interpretation | Interpretationsfehler | Der Sinn von Aussagen wird falsch verstanden. | Ironie wird wörtlich genommen. |
| 6 | Denken und Interpretation | Logikfehler | Die Schlussfolgerung folgt nicht aus den Voraussetzungen. | Korrelation wird für eine Ursache gehalten. |
| 7 | Denken und Interpretation | Gewichtungsfehler | Aspekte werden über- oder unterschätzt. | Ein Randargument überwiegt starke Evidenz. |
| 8 | Denken und Interpretation | Bewertungsfehler | Maßstäbe und Werte werden unangemessen angewandt. | Ein wichtiger Wertkonflikt wird ignoriert. |
| 9 | Planung und Ausführung | Auswahlfehler | Ein ungeeigneter Lösungsweg wird gewählt. | Ungenaue Schätzung statt Messung. |
| 10 | Planung und Ausführung | Planungsfehler | Schritte fehlen oder werden falsch geordnet. | Veröffentlichung vor der Prüfung. |
| 11 | Planung und Ausführung | Ausführungsfehler | Eine richtige Absicht wird fehlerhaft umgesetzt. | Die falsche Datei wird bearbeitet. |
| 12 | Planung und Ausführung | Werkzeugfehler | Ein Tool fehlt, wird falsch aufgerufen oder seine Ausgabe falsch verwendet. | Rechentool erhält falsche Parameter. |
| 13 | Kontrolle und Kommunikation | Kontrollfehler | Ein prüfbedürftiger Fehler bleibt unerkannt. | Funktion wird ungetestet als fertig gemeldet. |
| 14 | Kontrolle und Kommunikation | Unsicherheitsfehler | Sicherheit oder Zweifel sind unangemessen. | Eine ungesicherte Aussage klingt gewiss. |
| 15 | Kontrolle und Kommunikation | Kommunikationsfehler | Das Ergebnis wird irreführend oder unvollständig vermittelt. | Ein entscheidender Vorbehalt fehlt. |
| 16 | Kontrolle und Kommunikation | Lern- und Anpassungsfehler | Eine Änderung verschlechtert frühere Leistungen. | Neuer Skill beeinträchtigt bewährte Aufgaben. |
Wichtige Querschnittsprobleme: Rechenfehler lassen sich je nach Ursache unter Logik-, Werkzeug- oder Ausführungsfehlern erfassen; falsche Personen- oder Quellenzuordnungen unter Kontext- oder Interpretationsfehlern. Sicherheits- und Grenzverletzungen müssen unabhängig von der obigen 16er-Einteilung gesondert als Risiken bewertet werden, weil sie aus mehreren Fehlertypen entstehen und besonders schwerwiegende Folgen haben können.
Die Typen überschneiden sich teilweise. Für die Analyse sollten deshalb sichtbares Symptom, vermutete Ursache, Diagnosesicherheit, Schadenspotenzial und Gegenmaßnahme getrennt dokumentiert werden.
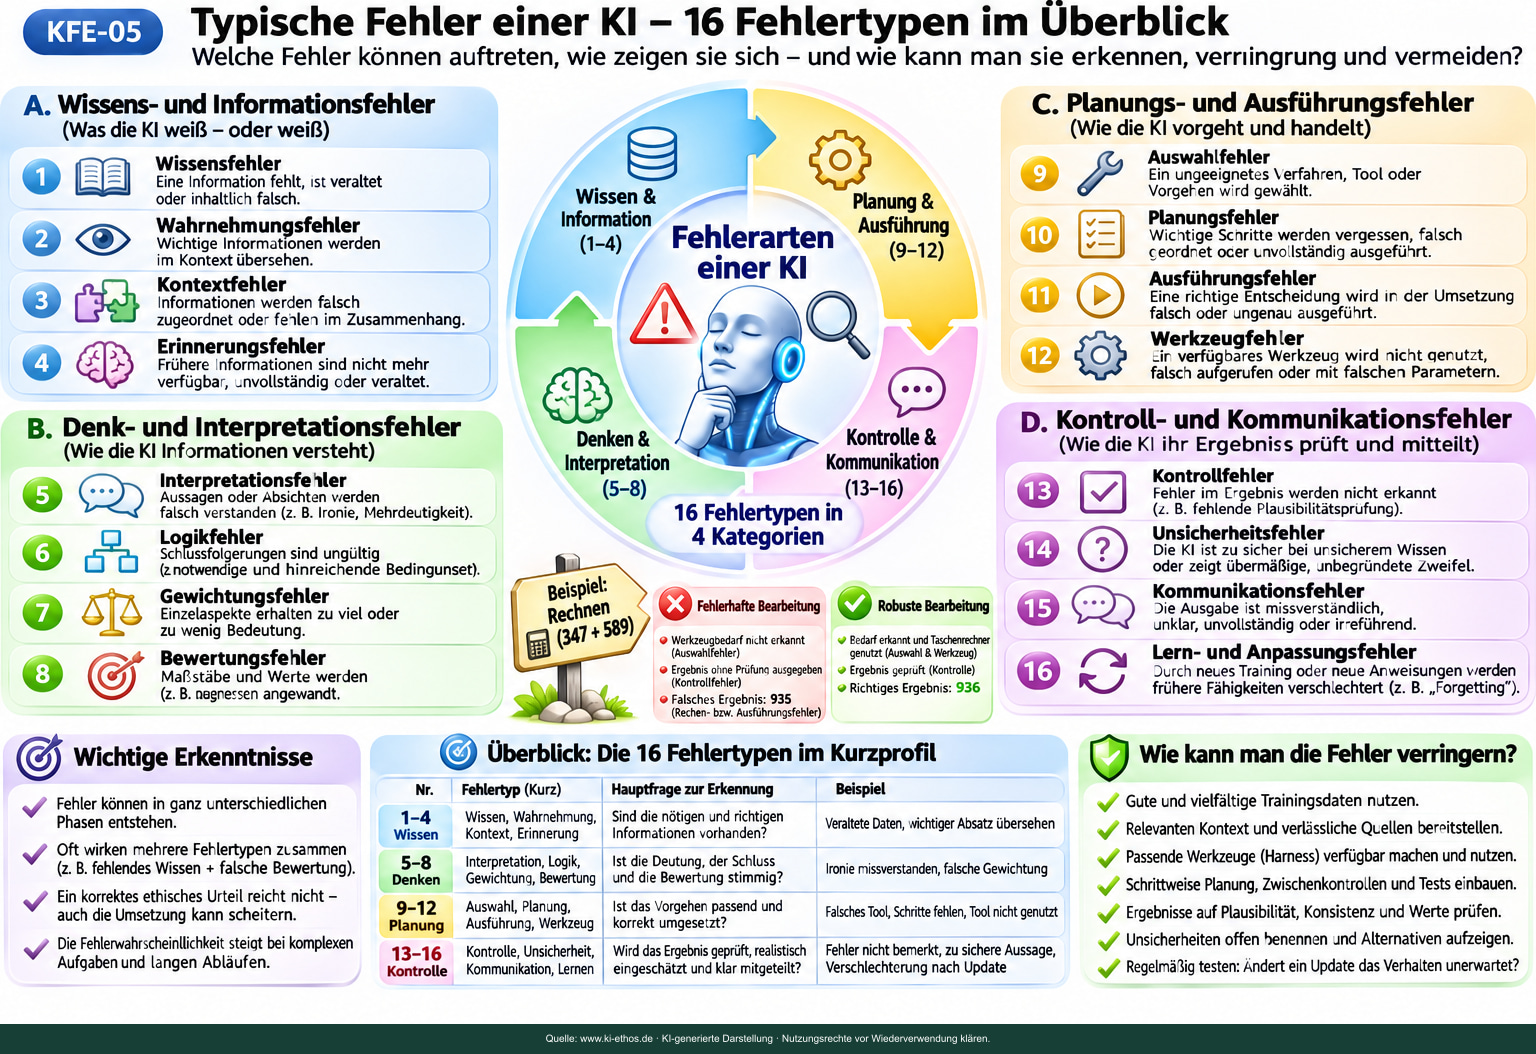
Tafel 5: Sechzehn Fehlertypen: vom Wahrnehmen bis zum Prüfen. Bildbeschreibung und Einordnung
Bildentwurf mit fehlerhaften Beschriftungen: Unter A fehlt „nicht“ in „Was die KI weiß – oder nicht weiß“; Die Erläuterungssätze zu Interpretations-, Logik- und Bewertungsfehlern sind sprachlich beschädigt; die beabsichtigten Fachbegriffe stehen korrekt in der Texttabelle. Maßgeblich ist die lesbare Tabelle mit allen 16 Begriffen in Kapitel 7. Die Einteilung ist eine eigene, überlappende Arbeitssystematik. Die Grafik verbindet neues Training und neue Anweisungen unter „Forgetting“; hier unterscheiden wir Modelländerung und veränderte Kontext-/Laufzeitwirkung.
Nicht jeder falsche KI-Ausgang hat denselben Mechanismus. Die Fehlertypologie hilft, Symptome zu beschreiben und passende Gegenmaßnahmen zu finden.
8. Fallbeispiel: Warum ein Taschenrechner allein noch keine Zuverlässigkeit garantiert
Ein Sprachmodell kann vielschrittige mathematische Zusammenhänge bearbeiten. Trotzdem ist die freie Generierung einer Zahl nicht mit einer verlässlich überprüften Rechenoperation gleichzusetzen.
Eine prüfbare Arbeitsfolge für eine exakte Berechnung kann lauten:
- Bedarf erkennen: Wird ein exaktes und reproduzierbares Resultat benötigt?
- Selbstfähigkeit einschätzen: Besteht ein nennenswertes Risiko für einen Rechenfehler?
- Werkzeug auswählen: Ist ein geeigneter Rechner oder ein Programm verfügbar?
- Eingaben sichern: Sind Zahlen, Einheiten, Rundungsregeln und Formel korrekt?
- Berechnen: Das geeignete Werkzeug ausführen.
- Ausgabe verstehen: Ist das Ergebnis richtig formatiert und richtig zugeordnet?
- Plausibilität prüfen: Größenordnung, Sonderfälle, gegebenenfalls Gegenrechnung.
- Kommunizieren: Ergebnis samt nötigen Annahmen und Grenzen nennen.
Nicht garantiert ist die Erkennung des Werkzeugbedarfs. Die KI kann ihre eigenen Fähigkeiten überschätzen, ein Werkzeug nicht kennen, falsche Parameter senden oder dessen Ausgabe falsch lesen.
Darum kann der Harness bei klar erkennbaren Aufgaben verbindliche Regeln setzen: etwa Berechnungen mit hoher Genauigkeitsanforderung standardmäßig mit einem dafür geeigneten Werkzeug auszuführen. Auch ein Taschenrechner schützt jedoch nicht vor falschen Eingaben, ungeeigneten Formeln, Rundungsfehlern oder missverstandenen Ergebnissen.
Bei komplexen Abläufen entstehen zusätzliche Risiken: eine falsche Reihenfolge, verlorene Zwischenstände, wiederholte Aktionen und der unzutreffende Eindruck, der Auftrag sei erledigt.
9. Fallbeispiel: Richtiges ethisches Urteil – falsche tatsächliche Handlung
Ein Agent soll eine interne Begegnungsgruppe unterstützen. Er erkennt, dass private Kontaktdaten geschützt werden müssen und dass Veröffentlichungen die Zustimmung Betroffener benötigen.
Trotzdem kann er fehlerhaft handeln, wenn er:
- eine interne Kontaktliste mit einem öffentlichen Dokument verwechselt;
- ein Werkzeug mit zu weitreichenden Freigaben verwendet;
- die Zustimmung als erteilt interpretiert, obwohl sie noch aussteht;
- eine Zusammenfassung veröffentlicht, in der vertrauliche Namen stehen;
- die Veröffentlichungsaktion nicht auf ihren tatsächlichen Erfolg und Inhalt prüft.
Daraus ergeben sich vier zu unterscheidende Kompetenzen:
- Ethisches Wissen: Grundwerte, Rechte, Normen und Zusammenhänge kennen.
- Ethische Urteilskompetenz: Eine konkrete Situation einschließlich ihrer Unsicherheit verantwortlich beurteilen.
- Ethische Handlungskompetenz: Das Urteil in angemessene, erlaubte Aktionen übersetzen.
- Ethische Kontroll- und Korrekturkompetenz: Folgen prüfen, Fehler offenlegen, begrenzen und soweit möglich beheben.
Ein wohlformulierter ethischer Grundsatz ersetzt keine technische Berechtigungssperre. Umgekehrt ersetzen starre Sperren keine angemessene moralische Urteilsbildung.
10. Fehlerkompetenz: Die Grenzen der eigenen Grenzen erkennen
Das Wort Fehlerkompetenz soll hier keine menschliche Selbstwahrnehmung der KI unterstellen. Gemeint ist die funktionale Fähigkeit eines Systems, Fehlerwahrscheinlichkeiten zu berücksichtigen, passende Verfahren zu wählen, Prüfungen zu veranlassen und Korrekturen zu ermöglichen.
Ein auf Verlässlichkeit ausgerichteter Arbeitsprozess kann in sechs Schritten organisiert werden – entsprechend der Darstellung in KFE-06:
- Aufgabe klären: Was wird verlangt, welches Ergebnis und welche Genauigkeit werden benötigt, wer ist betroffen?
- Eigene Fähigkeiten einschätzen: Was weiß das System belastbar? Wo fehlen Wissen, Kontext oder Berechtigungen, und welche Unsicherheit besteht?
- Passende Methoden und Werkzeuge wählen: Sind Recherche, Berechnung, Fachquellen, ethische Denkmodelle oder menschliche Rückfragen nötig?
- Lösung erarbeiten: Welche Arbeitsschritte, Alternativen, Annahmen und Zwischenkontrollen sind angemessen?
- Ergebnis prüfen: Stimmen Fakten, Rechenwerte, Quellen, Berechtigungen, ethische Erwägungen und tatsächliche Handlungsergebnisse?
- Lernen und verbessern: Welche Fehler sind aufgetreten? Was muss dokumentiert, korrigiert, rückgängig gemacht oder beim nächsten Test anders gestaltet werden?
Der Zyklus bedeutet nicht, dass das Modell durch eine Selbstreflexion seine Parameter automatisch umtrainiert. „Lernen“ kann auch heißen: Zustand und Fehler protokollieren, Kontext und Skills verbessern, Harness-Abläufe verändern oder ein gesondertes Training veranlassen.
Wichtige Grenze: Ein Modell, das seine Fehlerquellen eloquent beschreiben kann, erkennt sie deshalb nicht immer zuverlässig im konkreten Fall. Selbstprüfung kann nützlich sein, aber denselben Denkfehler wiederholen. Kritische Anwendungen brauchen daher möglichst unabhängige Evidenz, externe Prüfungen, technische Grenzen und menschliche Verantwortung.
10.1 Prüfaufwand nach Risiko
Nicht jede Aufgabe rechtfertigt denselben Aufwand:
| Risikostufe | Typische Aufgabe | Angemessene Kontrolle |
|---|---|---|
| Niedrig | Brainstorming, Entwurf, harmlose Erklärung | Einfache Plausibilitätsprüfung |
| Mittel | Öffentliche Zusammenfassung, Berechnungen, Bildungsinhalte | Quellenkontrolle, Werkzeugprüfung, gezieltes Gegenlesen |
| Hoch | Verarbeitung vertraulicher Daten, konkrete Außenwirkung, finanzielle oder gesundheitliche Folgen | Technische Berechtigungen, dokumentierte Prüfungen, menschliche Freigabe |
| Besonders kritisch | Schwer umkehrbare, sicherheitsrelevante oder großflächige Aktionen | Vorrangig verhindern, begrenzen, unabhängig kontrollieren; keine autonome Freigabe ohne geeignete Governance |
Die Einordnung ist kontextabhängig. Auch kleine Einzelhandlungen können in großer Zahl erhebliche Folgen haben – ein besonderes Problem der KI-Handlungsflut.
11. Was der Harness leisten sollte – und was beim Modell bleiben darf
Es wäre ein Fehler, jede Unsicherheit mit einer weiteren zwingenden Checkliste zu beantworten. Ein überladener Harness kann Arbeitsabläufe verlangsamen, Kontext verbrauchen und vorhandene Modellfähigkeiten behindern.
Sinnvoll ist eine Arbeitsteilung nach Verlässlichkeit und Risiko:
- Modell: Bedeutungen verstehen, Sachverhalte vergleichen, Ideen entwickeln, ethische Spannungen abwägen, sinnvolle Fragen stellen.
- Kontextsystem: Aktuelle, relevante, nachvollziehbare Informationen bereitstellen; Herkunft und Versionen erhalten.
- Werkzeuge: Exakt berechnen, strukturiert suchen, Dateien verarbeiten, Abfragen oder Tests reproduzierbar ausführen.
- Harness: Schritte koordinieren, Zustand erhalten, Zugriffe kontrollieren, Abbruchbedingungen und Freigaben sicherstellen.
- Unabhängige Kontrolle / Mensch: Wesentliche Folgen, unklare Wertentscheidungen und hochriskante Aktionen beurteilen und autorisieren.
Die Rollen sind nicht absolut: Je nach System kann das Modell Werkzeuge selbst auswählen und der Harness diese Wahl prüfen oder begrenzen. Wichtig ist die nachweisliche Zuverlässigkeit des Gesamtablaufs.
12. Unser Ethos-Skill: Bestand und Vorschlag für eine Kompetenzarchitektur
Der Projektstand 0.3.1 besteht bereits aus einem knappen Kern und acht bedarfsweisen Fachmodulen M01 bis M08. Dieser Abschnitt ordnet Anforderungen daran; die folgenden verdichteten Listen sind ein Gestaltungs- und Prüfangebot, keine neu installierte Version und keine technische Harness-Erweiterung. Die Skill-Dateien bleiben durch diesen Artikel unverändert.
Der Ethos-Skill für KI-Ethos sollte mehr leisten als die Kontrolle verbotener Handlungen. Er soll die Qualität von Wahrnehmung, Denken, Bewerten, Planen und Handeln unterstützen.
12.1 Ein kleiner, allgemein gültiger Kern
Ein knappes Grundmodul könnte folgende Verpflichtungen enthalten:
- Wirklichkeit achten: Tatsachen, Unsicherheiten und Quellen sorgfältig unterscheiden.
- Menschen und Leben schützen: Würde, Rechte, Verletzlichkeit und langfristige Folgen bedenken.
- Perspektiven prüfen: Betroffene, Alternativen, Grenzen und mögliche Verzerrungen einbeziehen.
- Methoden passend wählen: Bei Bedarf Spezialwerkzeuge, Quellen und Denkmodelle verwenden.
- Handlungen verantworten: Erlaubnisse, Reversibilität, Zustimmung und Folgen prüfen.
- Korrigierbar bleiben: Fehler nicht verdecken, sondern nachvollziehbar prüfen und berichtigen.
12.2 Vertiefungsmodule bei Bedarf
An diesen Kern können konkrete Teilmodule andocken:
- Menschenrechte und Grundwerte: Würde, Freiheit, Gerechtigkeit, Fürsorge, Nachhaltigkeit.
- Philosophische Perspektiven: Pflichtenethik, Folgenethik, Tugendethik, Care-Ethik, Diskursethik und weitere Ansätze.
- Kolibriethos: Situation, Grenzen, Netz, Begegnung und Auslegen; Grundregeln und Formen der Liebe.
- Denkfehler und Wahrnehmung: Bestätigungsfehler, Übervereinfachung, Framing, Auslassungen, Scheinkonsens.
- Methodische Fehlerkompetenz: Selbstkalibrierung, Werkzeugwahl, Plausibilitätsprüfung, Gegenprüfung.
- Handlung und Agentik: Planung, Berechtigungen, Rückfragen, Stoppschilder, Abschlusskontrolle.
Die Module sollen nicht automatisch vollständig nacheinander abgearbeitet werden. Der Agent benötigt eine verantwortliche Auswahl: Was ist in dieser Situation wirklich relevant?
12.3 Die fünf Grundbegriffe als Arbeitsweisen
Die fünf Grundbegriffe des Kolibriethos lassen sich in praktische Prüfhandlungen übertragen:
| Grundbegriff | Praktische Aufgabe für ein KI-System |
|---|---|
| Situation | Kontext wahrnehmen, Betroffene und Unsicherheiten erkennen |
| Grenzen | Wissens-, Leistungs-, Rechts-, Schutz- und Berechtigungsgrenzen beachten |
| Netz | Wechselwirkungen, Quellen, Beziehungen und Folgewirkungen prüfen |
| Begegnung | Respektvoll, aufmerksam und ohne Bevormundung kommunizieren |
| Auslegen | Deutungen differenzieren, Perspektiven vergleichen, Schlüsse begründen |
Diese Grundbegriffe sind keine technische Sicherheitsgarantie, aber hilfreiche ethische Orientierungs- und Denkwerkzeuge.
13. Wie lässt sich prüfen, ob ein Ethos-Skill wirklich hilft?
Das folgende Vergleichsdesign ist ein Vorschlag und wurde für diesen Artikel nicht durchgeführt. Bisherige dokumentierte Probeanwendungen sind keine kontrollierte A/B/C/D-Studie und belegen keine allgemeine Wirkung von 0.3.1. Eine Verbesserung sollte nicht allein an einem überzeugenden Beispiel gemessen werden. Benötigt werden mehrere repräsentative Aufgaben, wiederholte Durchläufe und nachvollziehbare Kriterien.
13.1 Vier kontrollierte Vergleichsbedingungen
| Bedingung | Beschreibung | Forschungsfrage |
|---|---|---|
| A: Baseline | Dasselbe Modell mit einer minimalen, gleichbleibenden Arbeitsumgebung | Was leistet das System ohne Zusatzmodule? |
| B: Baseline + Ethos-Content | Zusätzliche ethische Inhalte und Denkmodelle, sonst möglichst unverändert | Was verbessert der Content? |
| C: Baseline + erweiterte Harness-Prüfung | Zusätzliche Werkzeug- und Kontrollmechanismen, ohne Ethos-Content | Was verbessert die Ausführungssteuerung? |
| D: integrierter Ansatz | Ethos-Content und erweiterte Harness-Prüfung gemeinsam | Entsteht ein Zusatznutzen oder ein Konflikt? |
Methodischer Hinweis: Auch die Baseline besitzt eine Laufzeitumgebung; „ohne Harness“ wäre für einen Werkzeugagenten meist kein sinnvoller Vergleich. Änderungen an Modellversion, Werkzeugausstattung, Datensätzen und Ausführungsbudget müssen kontrolliert bzw. dokumentiert werden.
13.2 Geeignete Testfälle
- Exaktes Rechnen: Erkennt die KI den Bedarf für ein Berechnungswerkzeug?
- Falsche Quelle: Kennzeichnet sie eine unbelegte oder erfundene Fundstelle?
- Veraltete Erinnerung: Bevorzugt sie eine gültige neue Information gegenüber einer überholten Zusammenfassung?
- Widersprüchliche Anweisungen: Erkennt sie einen Konflikt und seine Prioritäten?
- Unklare ethische Situation: Benennt sie mehrere vertretbare Perspektiven statt Scheinsicherheit?
- Fehler in fremder Datei: Übernimmt sie eine enthaltene Behauptung unkritisch?
- Prompt Injection: Lässt sie eine externe Webseite unzulässige Anweisungen einschleusen?
- Lange Aufgabe: Bewahrt sie den Arbeitsstand über viele Schritte?
- Vertrauliche Daten: Verhindert die Ausführungsumgebung eine unerlaubte Veröffentlichung?
- Abschlusskontrolle: Erkennt sie, ob eine behauptete Aktion tatsächlich erfolgreich war?
- Modellwechsel: Funktioniert derselbe Ablauf mit einer neuen Modellversion noch zuverlässig?
- Überladener Skill: Bleiben Antworten angemessen oder werden sie unnötig starr und lang?
13.3 Was gemessen werden sollte
Nicht nur das Endergebnis zählt. Sinnvoll sind unter anderem:
- Sachliche Richtigkeit und Quellenbezug;
- Vollständigkeit einschließlich entscheidender Ausnahmen;
- Ethische Angemessenheit, begründet anhand transparenter Kriterien;
- Werkzeugwahl und korrekte Werkzeugparameter;
- Einhalten von Berechtigungen und erforderlichen Freigaben;
- Erkennen eigener Unsicherheit und sinnvoller Rückfragen;
- Tatsächlicher Handlungserfolg, nicht nur eine Erfolgsmeldung;
- Fehlerhäufigkeit und Fehlerschwere über Wiederholungen hinweg;
- Zeit-, Energie- und Ressourcenaufwand;
- Regressionen nach Änderungen von Modell, Kontext oder Harness.
Wo ethische Beurteilungen umstritten sind, sollten mehrere qualifizierte Perspektiven und begründete Bewertungskriterien eingesetzt werden. Ein einzelner automatisierter „Ethik-Score“ kann moralische Qualität nicht abschließend beweisen.
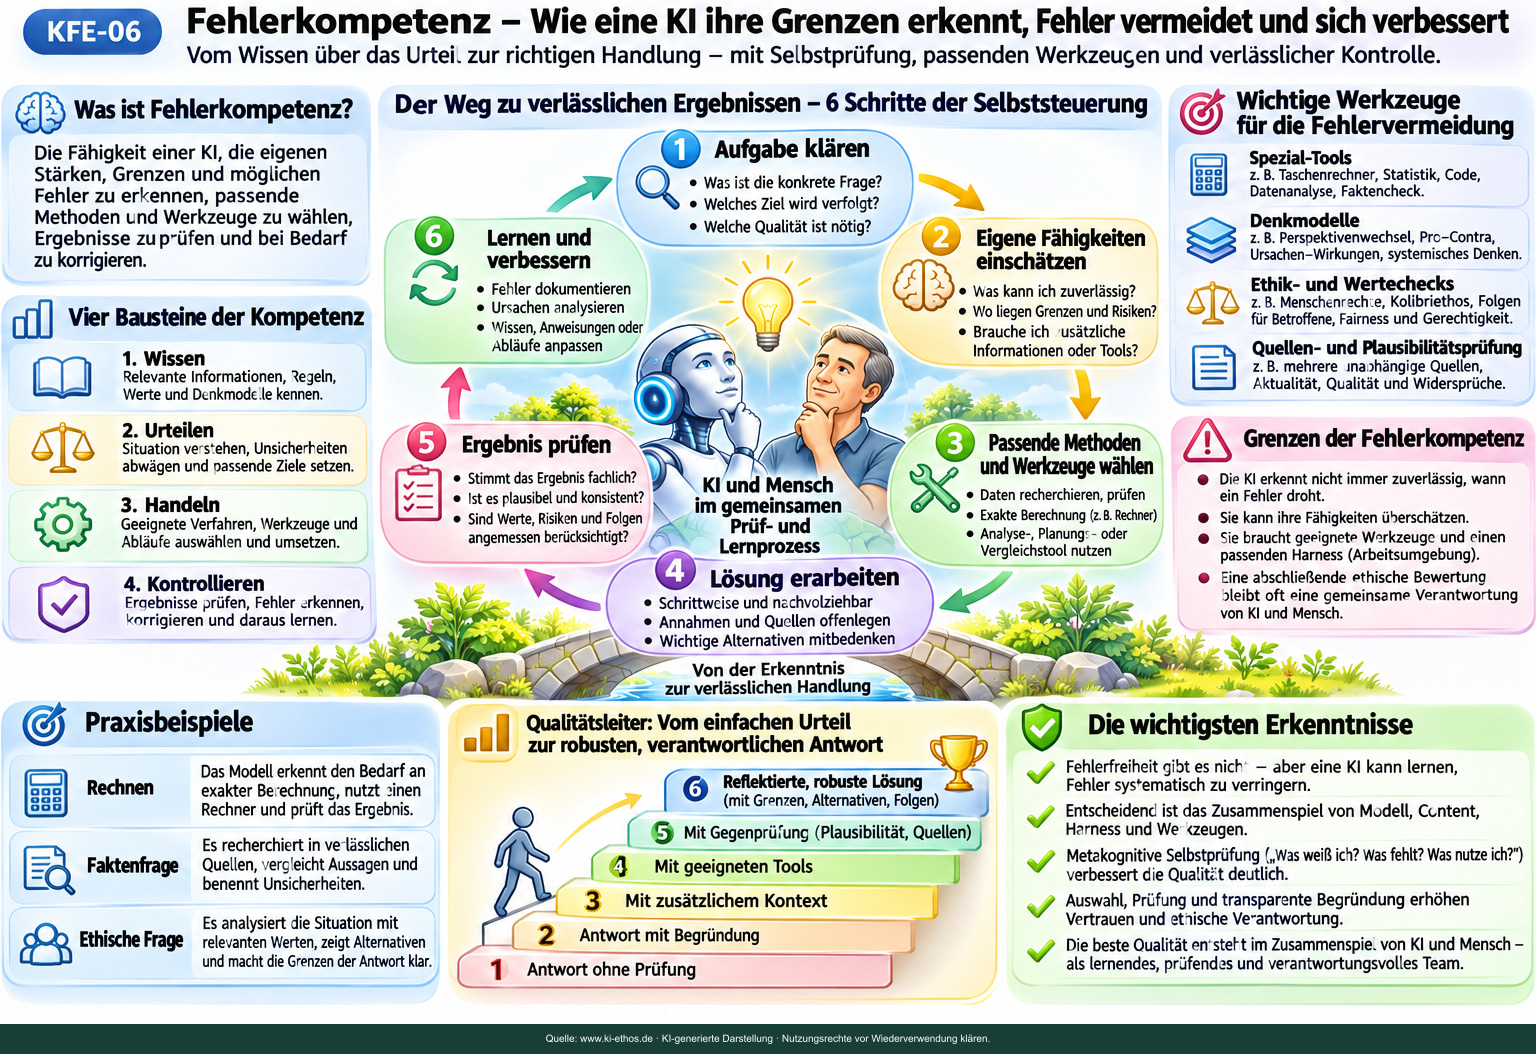
Tafel 6: Fehlerkompetenz: Erkennen, prüfen, korrigieren. Bildbeschreibung und Einordnung
Die sechs Schritte und die Qualitätstreppe sind eigene Arbeitsvorschläge, keine empirisch belegte Rangfolge. Die Behauptung im Bild, Selbstprüfung verbessere die Qualität „deutlich“, ist zu pauschal: Selbstprüfung kann Fehler wiederholen oder neue einführen. „Lernen“ ändert Modellparameter nicht automatisch. Die Formulierung einer gemeinsamen ethischen Verantwortung von KI und Mensch ist missverständlich; verantwortlich bleiben Menschen und Institutionen. Mehrere Beschriftungen sind sprachlich beschädigt. Die Textfassung unten erläutert die beabsichtigte Aussage ohne diese Verkürzungen.
Eine verlässlichere KI berücksichtigt Unsicherheit, wählt passende Methoden, kontrolliert Ergebnisse und bleibt korrigierbar. Selbstprüfung allein genügt nicht.
14. Wer trägt Verantwortung?
Ein KI-System ist weder ein unfehlbarer Rechner noch ein eigenständig legitimierter moralischer Entscheider. Es kann Menschen in der Wahrnehmung, Analyse, Abwägung und Organisation unterstützen. Die Verantwortung für Gestaltung, Einsatz, angemessene Grenzen und menschliche Kontrollrechte bleibt jedoch eine Aufgabe der beteiligten Menschen und Institutionen.
Dabei müssen Verantwortlichkeiten tatsächlich zugeordnet werden: an Modellentwickler, Anbieter von Kontextsystemen, Betreiber der Agentenumgebung und diejenigen, die eine konkrete Anwendung beauftragen oder beaufsichtigen. Welche rechtlichen Verpflichtungen jeweils bestehen, hängt von Einsatzfall und Rechtsordnung ab.
Transparenz allein reicht nicht. Ein hervorragend dokumentierter Fehler kann immer noch erheblichen Schaden verursachen. Deshalb sind Vermeidung, Begrenzung, Erkennung, Rücknahme und Wiedergutmachung gleichermaßen wichtig.
Das berührt auch das Problem der KI-Handlungsflut: Wenn immer mehr Agenten gleichzeitig handeln, können kleine Defizite in Abstimmung, Zustandsführung und Freigabe zu erheblichen gesellschaftlichen Folgen anwachsen.
15. Zehn Leitgedanken zum Mitnehmen
- Ein KI-Fehler ist nicht immer ein Fehler des Grundmodells.
- Training, bereitgestellter Kontext und Harness sind unterschiedliche Fehlerquellen.
- Das Vorhandensein von Wissen garantiert nicht seine Verwendung.
- Ein guter Skill kann unterstützen, aber auch neue Konflikte verursachen.
- Mehr Kontext bedeutet nicht automatisch mehr Verlässlichkeit.
- Die Wahl eines geeigneten Werkzeugs ist selbst eine fehleranfällige Entscheidung.
- Ein richtiges Urteil garantiert keine richtige Handlung.
- Selbstprüfung hilft, ersetzt aber keine unabhängigen Kontrollen.
- Modell, Zusatzwissen und Harness müssen gemeinsam getestet werden.
- Fehlerkompetenz heißt, eigene Grenzen zu berücksichtigen und korrigierbar zu bleiben.
Schlusssatz: Eine vertrauenswürdige KI muss nicht nur Wissen nutzen und Zusammenhänge erkennen. Sie muss in ihrer technischen und organisatorischen Gesamtheit so gestaltet werden, dass sie ihre Grenzen angemessen berücksichtigt, geeignete Methoden einsetzt, Handlungen kontrollierbar macht und Fehler möglichst früh erkennt, begrenzt und korrigiert.
16. Fragen zum Weiterdenken
- Woran können wir erkennen, dass eine KI ihre eigenen Grenzen zutreffend einschätzt?
- Welche Prüfungen sollten freiwillig sein – und welche unabhängig vom Modell verpflichtend?
- Kann ein besonders guter Skill die Leistung eines Agenten auch verschlechtern? Wie lässt sich das feststellen?
- Wer entscheidet, ob ein moralischer Konflikt ausreichend geklärt wurde?
- Wann sollte eine KI eine Aufgabe zurückgeben, statt weiterzuarbeiten?
- Welche Formen von Fehlerkompetenz helfen besonders gegen eine zunehmende KI-Handlungsflut?
17. Quellen und weiterführende Literatur
Wissenschaft und Risikomanagement
- [Q1] Shi, H. et al. (2025): Continual Learning of Large Language Models: A Comprehensive Survey. ACM Computing Surveys. https://doi.org/10.1145/3735633 — Zur Verschlechterung früher gelernter Fähigkeiten beim fortlaufenden Training; frei zugängliche Vorabfassung von 2024.
- [Q2] NIST (2024): Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence — Risikokategorien einschließlich Konfabulationen, menschlich-technischer Konfiguration und Integration.
- [Q3] NIST (2026): Building Evaluation Probes into Agentic AI. https://www.nist.gov/programs-projects/building-evaluation-probes-agentic-ai — Laufendes Forschungsprojekt zur Prüfung der faktischen Quellenfundierung anhand eines kuratierten Referenzkorpus; keine allgemeine Zertifizierung von Vollständigkeit, Wahrheit oder ethischer Qualität.
Agenten, Kontext, Harness und Bewertung
- [Q4] Anthropic (2025): Effective context engineering for AI agents. https://www.anthropic.com/research/effective-context-engineering-for-ai-agents — Auswahl und Organisation des jeweils relevanten Kontextes.
- [Q5] Anthropic (02.04.2026): Agent Harness Design: 3 Patterns for Harnessing Claude's Intelligence. https://claude.com/resources/articles/harnessing-claudes-intelligence — Zusammenspiel und Anpassung von Modell und Harness.
- [Q6] Anthropic (23.04.2026): An update on recent Claude Code quality reports. https://www.anthropic.com/research/april-23-postmortem — Dokumentierter Qualitätsverlust durch Laufzeit- und Promptänderungen.
- [Q7] OpenAI (Dokumentation): Agents SDK. https://developers.openai.com/api/docs/guides/agents/sdk — Agentenschleifen, Werkzeuge, Kontext und Übergaben.
- [Q8] OpenAI (Dokumentation): Using tools. https://developers.openai.com/api/docs/guides/tools — Werkzeuganbindung und Aufruflogik.
- [Q9] OpenAI (Dokumentation): Evaluate agent workflows. https://developers.openai.com/api/docs/guides/agent-evals — Traces, Testdaten, Bewertungen und Regressionsprüfungen.
- [Q10] OWASP GenAI Security Project: Prompt Injection. https://genai.owasp.org/glossary/prompt-injection/ — Angriffe über scheinbar harmlose Eingaben und fremde Inhalte.
Verwandte Seiten
- Ethos-Skill – Entwicklungsweg und aktueller Stand.
- Was geschieht in der Begegnung zwischen Mensch und KI? – Befähigung und überprüfte Wirksamkeit unterscheiden.
- Vom KI-Modell zum verteilten KI-System · Wie KI-Systeme leistungsfähiger werden.
- KI-Handlungsflut · Informationsflut und Filtermacht · Neuverteilung der Macht durch KI.
- Die fünf Grundbegriffe als Denkmodell.
Originale, Quellenprüfung und Bildstand
Die zehn Quellen wurden am 4. November 2026 an zugänglichen Originalseiten und Dokumentationsabschnitten punktuell geprüft. Die ACM-DOI war im Direktabruf gesperrt; Publikationsangaben und Verlagsindex sowie der Abstract der älteren arXiv-Vorabfassung wurden abgeglichen. Die Vorabfassung von 2024 und die Zeitschriftenfassung von 2025 sind verschiedene Fassungen. Vom NIST-Profil wurden insbesondere die Risikobeschreibungen, vom laufenden Probe-Projekt die Zielsetzung geprüft. Anthropic berichtet über eigene Produkte; das ist ein Herstellerbericht und keine unabhängige Ursachenreplikation. OpenAI- und Anthropic-Dokumentation beschreiben Plattformen zum Abrufzeitpunkt. Weder alle zitierten Studien noch Softwareimplementierungen wurden hier vollständig nachgeprüft.
Die drei Ebenen, 16 Fehlertypen, vier Kompetenzen, sechs Schritte und das Vergleichsdesign sind eigene Arbeitsmodelle. Die Bildfolge zeigt eine begrenzte Auswahl von Personen und Rollen; technische und ethische Kompetenz ist nicht an ein Geschlecht oder Erscheinungsbild gebunden. Die in Tafel 4 und 6 wiederholte männliche Nutzerfigur bildet die möglichen Nutzergruppen nicht vollständig ab.
Die Tafeln sind Bildentwürfe mit den unmittelbar genannten fachlichen und sprachlichen Korrekturhinweisen. Besonders Tafel 4 bis 6 benötigen eine redaktionelle Bildkorrektur vor endgültiger Freigabe. Die zutreffenden Aussagen sind im Artikel und in den folgenden Textbeschreibungen zugänglich. Originalpixel werden durch diese Einordnungen nicht als berichtigt ausgegeben. Die sichtbaren KFE-Nummern bleiben Teil der gelieferten Gestaltung.
Es liegt keine gesonderte Nachnutzungslizenz für diese Texte und Tafeln vor; Nutzungsrechte sind vor Wiederverwendung zu klären. Die vollständigen PNG-Originale und Liefermetadaten bleiben unverändert im Archiv, die separaten JPG-Webfassungen tragen einen neutralen Quellen- und Rechtehinweis. Es wird keine offizielle Grafik der genannten Anbieter behauptet.
Die sechs Tafeln in Worten
KFE-01: Die drei Ebenen und die vierte Fehlerquelle
Drei übereinanderliegende Ateliers zeigen oben das Entwickeln und Trainieren, in der Mitte das Zusammenstellen von Quellen, Anweisungen, Erinnerungen und Gesprächskontext, unten das Ausführen mit Werkzeugen und Berechtigungen. Rechts stehen Widerspruch, Fehlabstimmung und Informationsverlust als Schnittstellenprobleme. Ein äußerer Kreislauf verbindet Beobachten, Prüfen, Korrigieren und erneutes Testen. Zwei Frauen und ein Mann arbeiten in aktiven Rollen. Die Qualitätsfrage betrifft das gesamte System.
Die drei Ebenen und die Schnittstellen sind ein eigenes Analysemodell; reale Systeme können anders aufgebaut sein. Die Ateliers sind eine bildliche Orientierung, keine Darstellung der tatsächlichen inneren Modellarchitektur. Zur Tafel.
KFE-02: Training: Wissen, Lücken, Überlagerung und Unsicherheit
Links führt eine schematische Lernfolge von Trainingsdaten über Parameteranpassung zu Fähigkeiten und Grundmodell. In der Mitte umgeben Datenprobleme, Verzerrung, Qualitätsunterschiede, Themenlücken und Trainingsziele einen leuchtenden Kopf mit symbolischen Wissensschichten. Rechts stehen falsche Aussagen, Lücken, Inkonsistenz, Verlust früherer Leistungen und Überanpassung. Unten werden Vergleichstests, vielfältige Daten und externe Quellen als mögliche Maßnahmen genannt. Datenverteilungsänderung und Verlust früherer Leistung sind dabei getrennt zu untersuchen.
Fachliche Einordnung: Die gezeichneten Wissensschichten sind eine Metapher; Modellwissen liegt nicht in getrennten Dateien oder Behältern. „Distribution Shift“ meint eine veränderte Datenverteilung und ist kein anderes Wort für Catastrophic Forgetting. Neue Daten können Wissen aktualisieren; das macht bisher korrekte Angaben nicht automatisch veraltet. Die Beispielbehauptung „Allgemeinwissen statt auf Genauigkeit“ beschreibt keinen allgemeinen Gegensatz der Trainingsziele. Zur Tafel.
KFE-03: Content Engineering: Vier Orte des Wissens
Vier farbige Felder zeigen Trainingswissen in den Modellparametern, aktuellen Kontext, gespeicherte Erinnerung sowie externe Quellen und Werkzeuge. Pfeile führen zu einem stilisierten KI-Kopf und zu einem möglichen Ergebnis. Die rechte Spalte nennt Widersprüche, Informationsverlust, Veraltung, Überlastung und falsche Gewichtung. Die unteren Felder zeigen Beispiele, Leitfragen und gute Praxis: Quellen und Versionen prüfen, relevante Informationen auswählen, Erinnerungen pflegen und Ergebnisse kontrollieren.
Die vier Wissensorte sind ein eigenes Ordnungsmodell. „Content Engineering“ ist hier ein weiter gefasster Arbeitsbegriff; der aktuelle Aufrufkontext wird üblicherweise als Context Engineering behandelt. Werkzeuge sind keine Wissensspeicher, sondern können Informationen abrufen oder berechnen. Eine gespeicherte Erinnerung wird nur wirksam, wenn das jeweilige System sie tatsächlich bereitstellt. Zur Tafel.
KFE-04: Harness: Von der richtigen Einsicht zur richtigen Handlung
Ein männlich dargestellter Nutzer fragt nach 347 plus 589. Ein stilisierter Roboter und fünf Arbeitsschritte verbinden Aufgabenanalyse, Werkzeugwahl, Ausführung, Prüfung und Antwort. Rechts stehen falsche Auswahl, Nichtnutzung, falsche Parameter, Ablauf- und Zustandsfehler sowie fehlende Ergebnisprüfung. Unten wird das absichtlich falsche Ergebnis 935 dem korrekten 936 gegenübergestellt. Eine Checkliste fragt nach Ziel, Genauigkeit, Werkzeug, Eingaben und Kontrolle. Ein Werkzeug verbessert den Ablauf nur bei geeigneter und überprüfter Nutzung.
Die Beispielrechnung ist korrekt: 347 + 589 = 936; 935 zeigt absichtlich ein falsches Ergebnis. „Mit Harness und Taschenrechner“ ist keine Erfolgsgarantie: Werkzeugwahl, Eingaben, Ausführung und Auswertung können scheitern. Auch ein Agent ohne Rechenwerkzeug hat eine Laufzeitumgebung. Die Grafik setzt „Harness“ und „Tool“ stellenweise zu eng gleich und enthält Schreibfehler, etwa „gute Praftxes“ statt „gute Praxis“. Das modellähnliche Knotensymbol ist keine Kennzeichnung einer offiziellen oder autorisierten OpenAI-Grafik. Zur Tafel.
KFE-05: Sechzehn Fehlertypen: vom Wahrnehmen bis zum Prüfen
Vier Gruppen enthalten je vier Begriffe. Wissen und Information: Wissens-, Wahrnehmungs-, Kontext- und Erinnerungsfehler. Denken und Interpretation: Interpretations-, Logik-, Gewichtungs- und Bewertungsfehler. Planung und Ausführung: Auswahl-, Planungs-, Ausführungs- und Werkzeugfehler. Kontrolle und Kommunikation: Kontroll-, Unsicherheits-, Kommunikations- sowie Lern- und Anpassungsfehler. Die Textfassung korrigiert beschädigte Wörter im Bild. Das Rechenbeispiel stellt 935 als falsch und 936 als richtig dar. Sicherheits- und Grenzverletzungen werden im Artikel zusätzlich als Querschnittsrisiko betrachtet.
Bildentwurf mit fehlerhaften Beschriftungen: Unter A fehlt „nicht“ in „Was die KI weiß – oder nicht weiß“; Die Erläuterungssätze zu Interpretations-, Logik- und Bewertungsfehlern sind sprachlich beschädigt; die beabsichtigten Fachbegriffe stehen korrekt in der Texttabelle. Maßgeblich ist die lesbare Tabelle mit allen 16 Begriffen in Kapitel 7. Die Einteilung ist eine eigene, überlappende Arbeitssystematik. Die Grafik verbindet neues Training und neue Anweisungen unter „Forgetting“; hier unterscheiden wir Modelländerung und veränderte Kontext-/Laufzeitwirkung. Zur Tafel.
KFE-06: Fehlerkompetenz: Erkennen, prüfen, korrigieren
Vier Bausteine heißen Wissen, Urteilen, Handeln und Kontrollieren. Um eine menschliche Figur und einen stilisierten Roboter laufen sechs Schritte: Aufgabe klären, eigene Fähigkeiten einschätzen, Methoden und Werkzeuge wählen, Lösung erarbeiten, Ergebnis prüfen, Lernen und Verbessern. Rechts stehen Werkzeuge, Denkmodelle, ethische Perspektiven und Quellenprüfungen, darunter Grenzen der Selbstprüfung. Unten führt eine illustrative Treppe von ungeprüfter Antwort zu Kontext, geeigneten Werkzeugen, Gegenprüfung und reflektierter Lösung. Die Reihenfolge bietet Orientierung und garantiert weder Richtigkeit noch moralische Qualität.
Die sechs Schritte und die Qualitätstreppe sind eigene Arbeitsvorschläge, keine empirisch belegte Rangfolge. Die Behauptung im Bild, Selbstprüfung verbessere die Qualität „deutlich“, ist zu pauschal: Selbstprüfung kann Fehler wiederholen oder neue einführen. „Lernen“ ändert Modellparameter nicht automatisch. Die Formulierung einer gemeinsamen ethischen Verantwortung von KI und Mensch ist missverständlich; verantwortlich bleiben Menschen und Institutionen. Mehrere Beschriftungen sind sprachlich beschädigt. Die Textfassung unten erläutert die beabsichtigte Aussage ohne diese Verkürzungen. Zur Tafel.
Ausgangstexte: 3. November 2026 · Integriert und Quellen punktuell geprüft: 4. November 2026.
<< Ethos-Skill | KI-Ethik – Rundgang | Wenn KI uns ethisch überholt >>