Wie KI-Systeme leistungsfähiger werden
KI-Navigation | Wie KI-Systeme leistungsfähiger werden
Leistungsfähiger wird KI durch bessere Modelle und durch ihre Arbeitsumgebung. Entscheidend ist, ob Kontext, Werkzeuge, Speicher und Prüfungen bei konkreten Aufgaben verlässlichen Nutzen schaffen. Mehr Funktionalität allein kann auch Kosten, Fehler und Abhängigkeiten erhöhen.
Bildbeschreibung · Bildtexte übersetzen
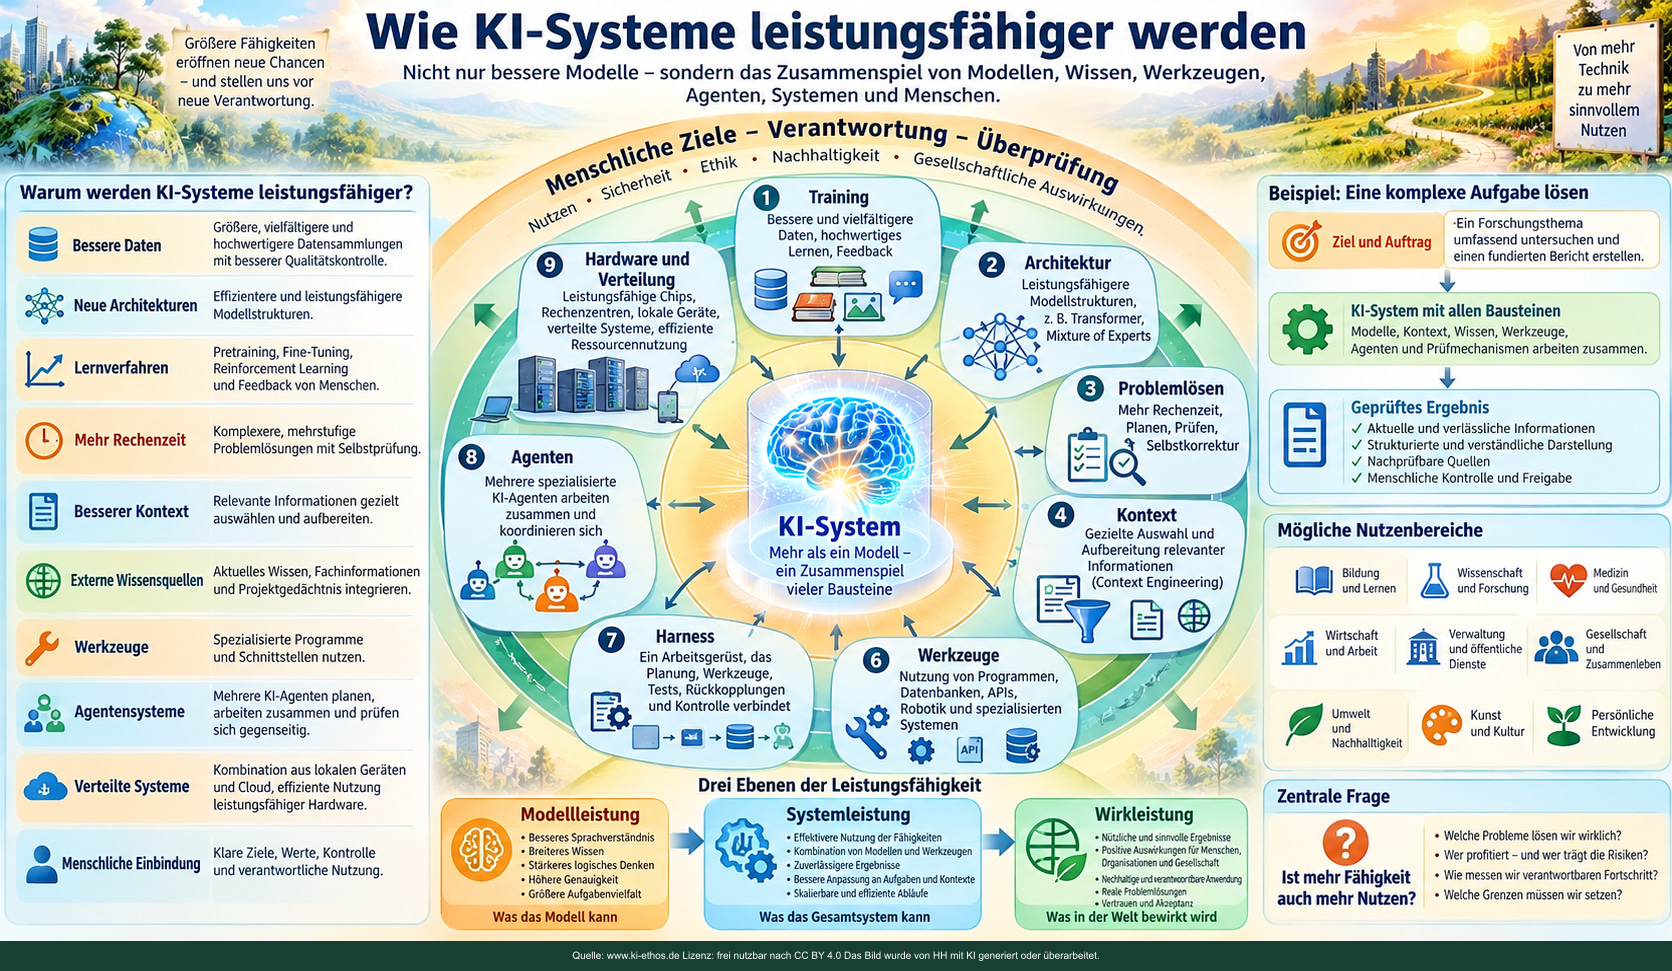
Bild 1 – Die neue Landkarte der KI-Leistungsfähigkeit. Neun Ansatzpunkte für wirksamere KI-Systeme. Modell-, System- und Wirkleistung sind zu unterscheiden.
1. Was bedeutet überhaupt „leistungsfähiger“?
Mit „KI-Leistung“ können sehr verschiedene Dinge gemeint sein. Man sollte sie nicht verwechseln.
| Dimension | Leitfrage | Beispiel für Fortschritt |
|---|---|---|
| Fähigkeit | Welche Aufgaben kann das System bewältigen? | Ein schwieriges Programm selbstständig überarbeiten. |
| Korrektheit | Sind die Aussagen und Ergebnisse richtig? | Weniger erfundene Quellen und Berechnungsfehler. |
| Zuverlässigkeit | Gelingt dieselbe Aufgabe wiederholt? | Ein Arbeitsablauf funktioniert nicht nur beim ersten Versuch. |
| Kontextverständnis | Nutzt es die relevanten Informationen? | Es beachtet vorhandene Projektentscheidungen. |
| Handlungsfähigkeit | Kann es Werkzeuge wirksam und kontrolliert einsetzen? | Es bearbeitet eine Datei und prüft die Änderung. |
| Effizienz | Wie viel Zeit, Rechenleistung, Geld und Energie kostet das? | Ein kleineres Modell löst eine Routineaufgabe ausreichend gut. |
| Steuerbarkeit | Kann der Mensch Ziele und Grenzen bestimmen? | Kritische Änderungen brauchen eine ausdrückliche Freigabe. |
| Nachvollziehbarkeit | Lassen sich Schritte, Quellen und Fehler prüfen? | Ein Testprotokoll belegt, was tatsächlich gelungen ist. |
| Fairness und Sicherheit | Wer profitiert, wer trägt Risiken? | Private Daten bleiben geschützt; Fehlverhalten wird begrenzt. |
Eine Verbesserung auf einer Achse kann eine Verschlechterung auf einer anderen bedeuten. Ein Agent, der zehn verschiedene Recherchen startet, mag umfassender antworten, verbraucht aber mehr Ressourcen. Eine sehr schnelle Antwort ist möglicherweise oberflächlicher. Mehr Autonomie kann Handlungsfähigkeit erhöhen und zugleich menschliche Kontrolle erschweren.
Darum gilt: Leistungsfähigkeit ist keine einzelne Zahl. Sie ist ein Bündel von Eigenschaften, das immer im Verhältnis zu einer konkreten Aufgabe und ihren Folgen beurteilt werden muss.
Drei Ebenen auseinanderhalten
- Modellleistung: Was kann das trainierte Modell, wenn es einen definierten Input erhält?
- Systemleistung: Was kann die Kombination aus Modell, Steuerung, Daten, Werkzeugen und Infrastruktur?
- Wirkleistung: Welchen echten Nutzen bewirkt sie für Menschen – nach Abzug von Fehlern, Kosten und unerwünschten Nebenfolgen?
Gerade die dritte Ebene wird bei technischen Leistungsangaben häufig zu wenig beachtet.
2. Die Landkarte: Wo KI-Systeme stärker werden
Man kann die Verbesserungen in einem Schichtenmodell darstellen:
                  MENSCHLICHE ZIELE UND VERANTWORTUNG
                                  │
                      Anwendung und Arbeitsablauf
                                  │
                Orchestrierung / Harness / Agentenlogik
                   ┌──────────────┼──────────────┐
              Werkzeuge        Kontext         Prüfsysteme
                   │              │                │
            Daten und Suche    Speicher      Tests und Feedback
                   └──────────────┼──────────────┘
                                  │
                         KI-Modell(e)
                  Architektur · Training · Anpassung
                                  │
                Chips · Speicher · Netz · Rechenzentrum
                       lokale und verteilte Technik
Das Schichtenmodell ist eine didaktische Vereinfachung, keine verbindliche Referenzarchitektur: In der Praxis werden einzelne Elemente mehrfach und auf verschiedenen Ebenen verbunden. Entscheidender als die genaue Zeichnung sind die Wechselwirkungen.
Eine gute Architektur macht vorhandene Modellfähigkeiten nutzbar. Eine schlechte Architektur kann die Fähigkeiten eines ausgezeichneten Modells weitgehend zunichtemachen.
3. Bessere Grundmodelle: Lernen, Architektur und Daten
Bildbeschreibung · Bildtexte übersetzen
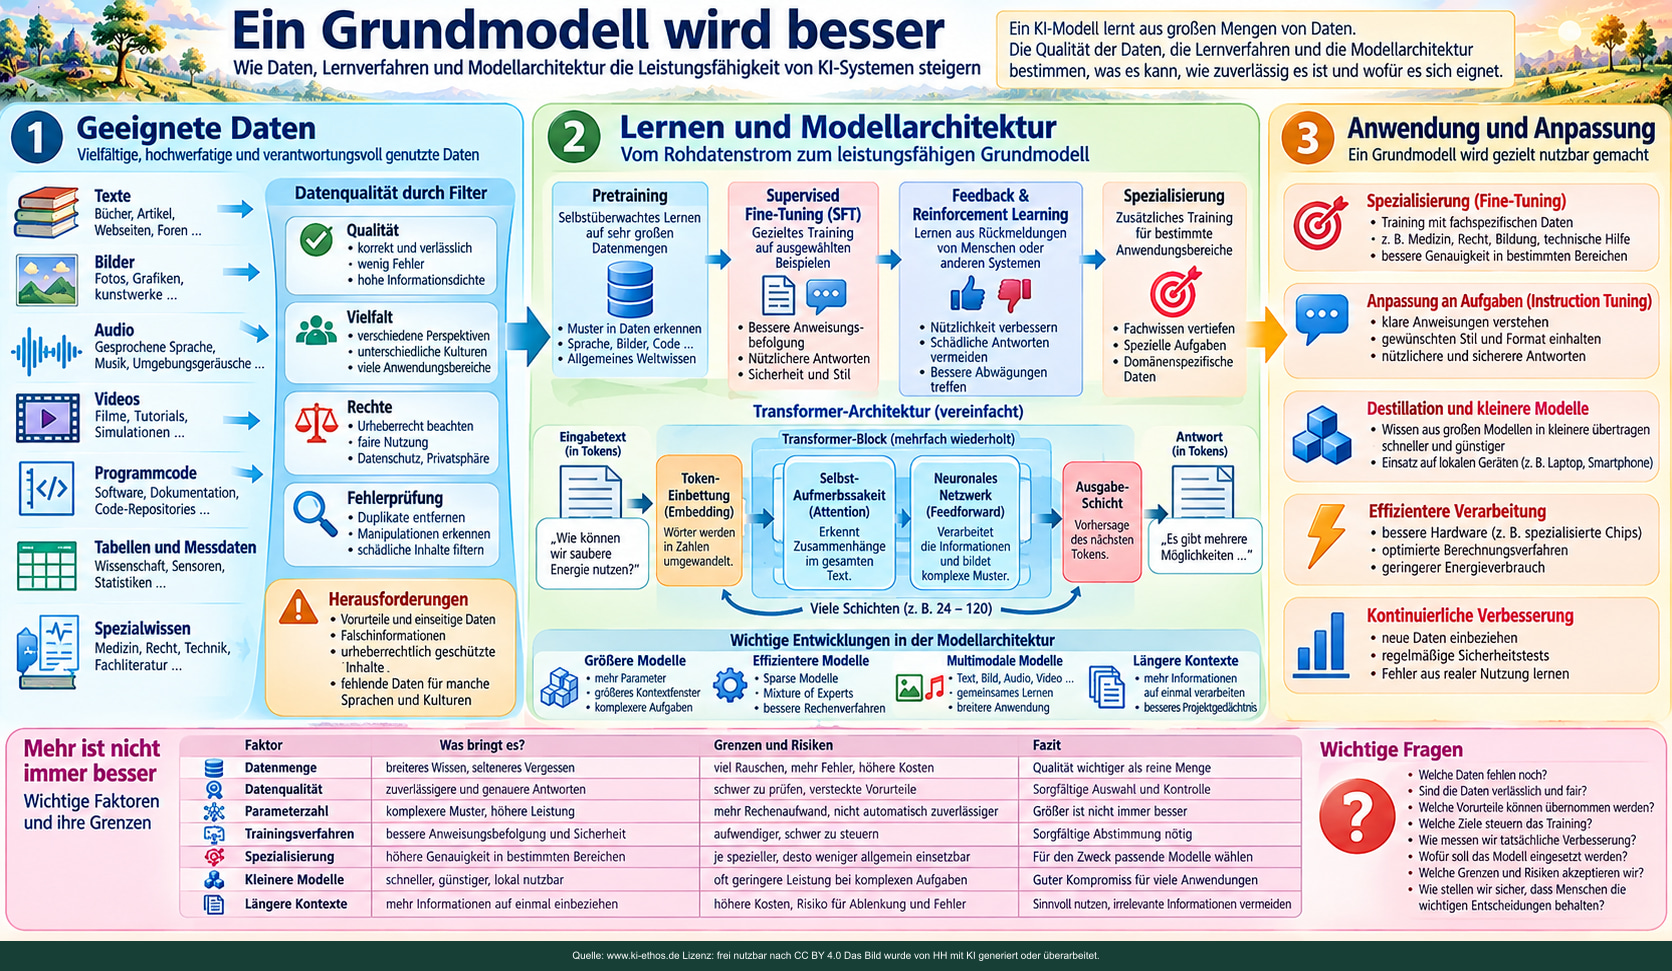
Das Schema ist vereinfacht. Schichtzahlen sind Beispiele; bei autoregressiven Modellen sind künftige Ausgabetokens nicht beliebig sichtbar.
Bild 2 – Ein Grundmodell wird besser. Wie geeignete Daten, Lernverfahren, Modellarchitektur und Anpassung zusammenspielen.
Der klassische Weg ist die Verbesserung des eigentlichen Modells.
3.1 Vortraining: Aus großen Datenbeständen lernen
Im Pretraining lernen Modelle statistische Regelmäßigkeiten, Darstellungen und Zusammenhänge aus umfangreichen Daten: Texten, Code, Bildern, Audio oder weiteren Modalitäten. Eine Verbesserung kann aus mehr geeigneten Daten, besserer Auswahl, höherer Datenqualität, veränderten Trainingsverfahren oder höherem Rechenaufwand entstehen.
Mehr Daten allein reichen nicht. Dubletten, Widersprüche, Verzerrungen, unerlaubt übernommene Inhalte und KI-generierte Fehler können die Qualität verschlechtern. Datenherkunft, Qualitätssicherung und eine angemessene Berücksichtigung unterschiedlicher Sprachen und Lebenswelten werden immer wichtiger.
3.2 Architektur und Lernverfahren
Architekturentscheidungen beeinflussen, wie gut ein Modell Muster verarbeitet und wie effizient es rechnet. Zu den Ansätzen gehören beispielsweise verbesserte Aufmerksamkeitsmechanismen, Mixture-of-Experts-Architekturen, bei denen nur Teile des Modells pro Verarbeitungsschritt aktiviert werden, und verschiedene multimodale Verfahren.
Hier ist zu unterscheiden: Eine günstigere Verarbeitung bedeutet nicht automatisch ein besseres Verständnis; eine größere Parameterzahl bedeutet nicht automatisch ein besseres Modell.
3.3 Nachtraining: Fähigkeiten gezielt formen
Nach dem Vortraining werden Modelle für bestimmte Aufgaben und Verhaltensweisen angepasst, beispielsweise durch:
- Supervised Fine-Tuning (SFT): Lernen aus aufbereiteten Aufgaben und Lösungsbeispielen.
- Präferenz- und Feedbacktraining: Antworten werden im Hinblick auf gewünschte Eigenschaften verglichen und optimiert.
- Reinforcement Learning (RL): Ein Modell wird anhand von Rückmeldungen oder überprüfbaren Erfolgskriterien trainiert.
- Spezialisierung: Anpassung an bestimmte Fachgebiete, Sprachen, Arbeitsweisen oder Formate.
Besonders aufschlussreich sind Bereiche, in denen Ergebnisse objektiv geprüft werden können – etwa mathematische Aufgaben oder Programmtests. Das Forschungssystem DeepSeek-R1 demonstrierte 2025 beispielsweise, wie Reinforcement Learning die Fähigkeiten zum mehrschrittigen Problemlösen beeinflussen kann. Das ist kein Beleg dafür, dass jede beliebige Frage durch längeres Rechnen zuverlässig lösbar würde. Quelle 1
3.4 Destillation und kleinere Modelle
Bei der Destillation können Fähigkeiten eines leistungsstarken Systems teilweise auf ein kleineres Modell übertragen werden. Kleinere Modelle lassen sich oft günstiger und teilweise lokal betreiben. Je nach Aufgabe können sie in einem Gesamtsystem wirtschaftlicher sein als das dauernde Aufrufen eines Spitzenmodells.
Grenze: Eine erfolgreiche Destillation überträgt nicht alle Fähigkeiten vollständig. Die Qualität muss für den jeweiligen Einsatz überprüft werden.
Frage an uns: Wollen wir das allgemein stärkste Modell – oder ein Modell, das für die konkrete Aufgabe hinreichend gut, verständlich, bezahlbar und kontrollierbar ist?
4. Besseres Problemlösen während der Nutzung
Bildbeschreibung · Bildtexte übersetzen
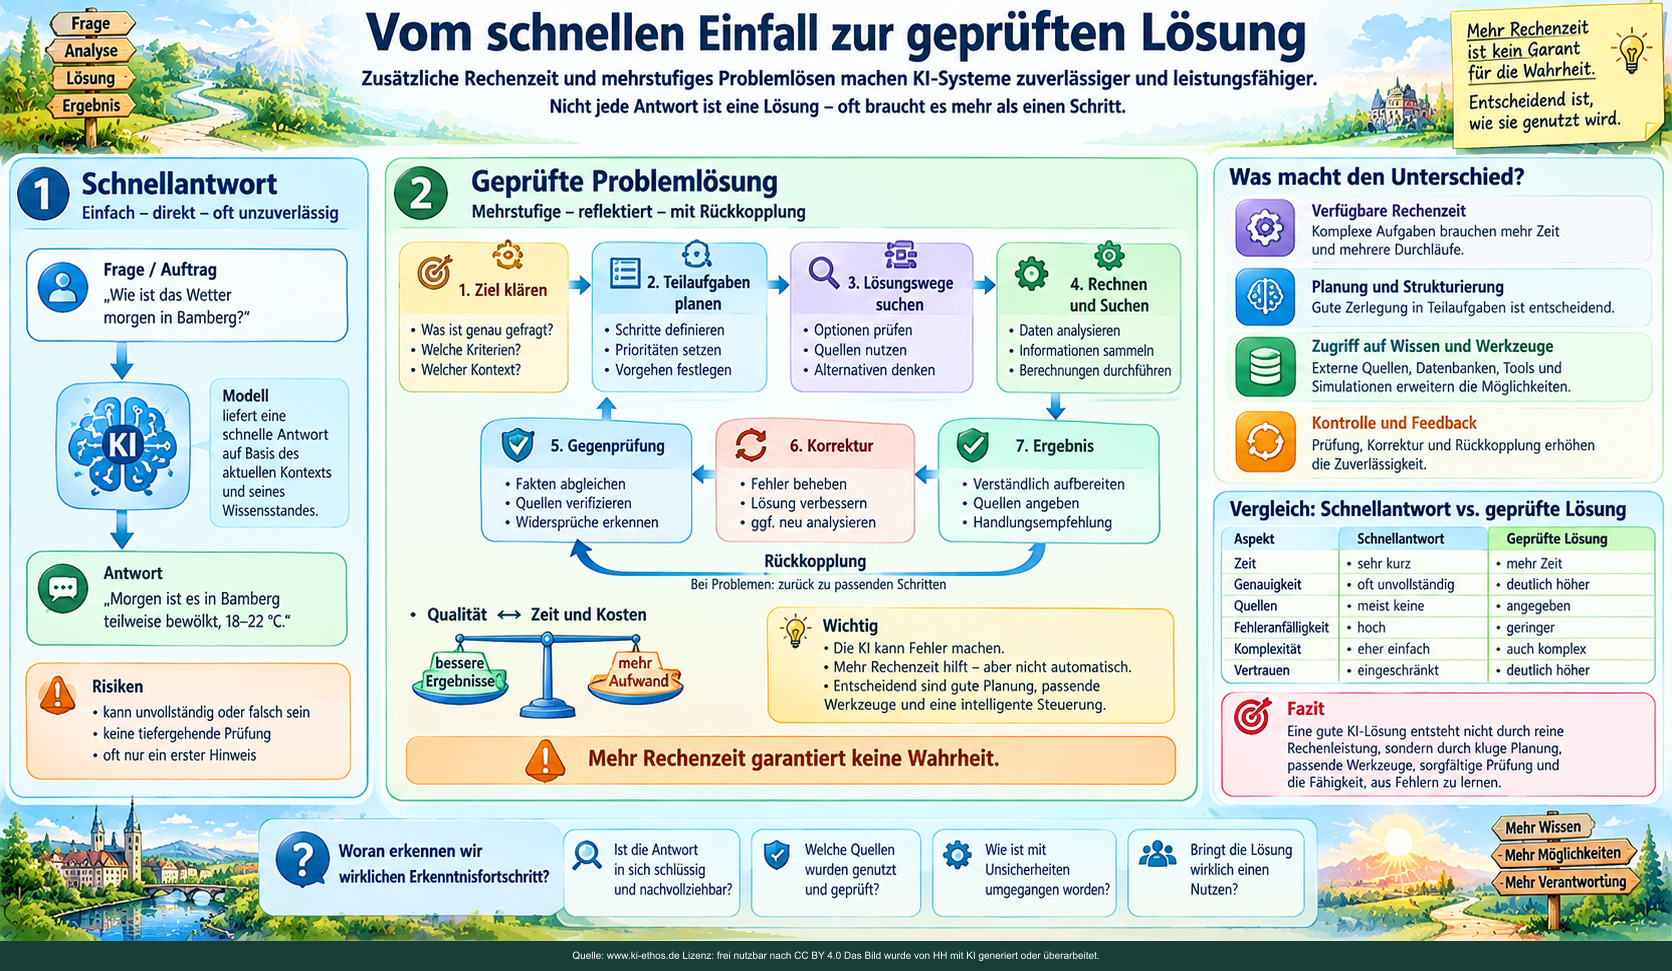
Die Wetterangabe ist ein erfundenes Beispiel. Eine schnelle Antwort ist nicht grundsätzlich schlechter; die Vergleichswerte sind keine Messdaten.
Bild 3 – Vom schnellen Einfall zur geprüften Lösung. Mehrstufige Bearbeitung kann die Qualität erhöhen – entscheidend ist die unabhängige Prüfung.
Ein Modell ist nach dem Training nicht auf eine einzige Art der Antworterzeugung festgelegt. Auch die Arbeitsweise während der Anfrage kann seine Ergebnisse verbessern.
4.1 Zusätzliche Rechenzeit für schwierige Aufgaben
Bei Test-Time Compute oder Inference-Time Scaling werden für eine anspruchsvolle Aufgabe zusätzliche Rechen- und Verarbeitungsschritte eingesetzt. Ein System kann Teilprobleme bearbeiten, Alternativen prüfen oder Zwischenergebnisse revidieren.
Das hilft besonders dort, wo schrittweises Problemlösen und ein belastbarer Prüfmaßstab existieren. Es hilft weniger, wenn die zugrunde liegende Information fehlt, eine Frage grundsätzlich mehrdeutig ist oder das System sich immer wieder auf dieselbe falsche Annahme stützt.
4.2 Planung und Zerlegung
Eine komplexe Aufgabe wird in überprüfbare Teilaufgaben gegliedert:
Ziel klären → Voraussetzungen prüfen → Teilaufgaben planen
           → Arbeitsschritte durchführen → Zwischenergebnisse testen
           → Fehler korrigieren → Ergebnis abnehmen
Der entscheidende Fortschritt liegt nicht allein in zusätzlichen Gedankenschritten, sondern in Rückkopplung: Die Arbeit erzeugt überprüfbare Zwischenergebnisse, die die weiteren Schritte beeinflussen.
4.3 Mehrere Entwürfe und Gegenprüfung
Ein System kann mehrere Lösungswege erzeugen und vergleichen. Das ist vor allem dann sinnvoll, wenn ein unabhängiges Kriterium eine Auswahl ermöglicht. Ohne unabhängige Prüfung kann mehrfache Wiederholung denselben Irrtum nur selbstbewusster erscheinen lassen.
Merksatz: Längeres Antworten ist nicht dasselbe wie tieferes Verstehen. Mehr Berechnung kann helfen; sie garantiert keine Wahrheit.
5. Kontext: Die richtigen Informationen zur richtigen Zeit
Bildbeschreibung · Bildtexte übersetzen
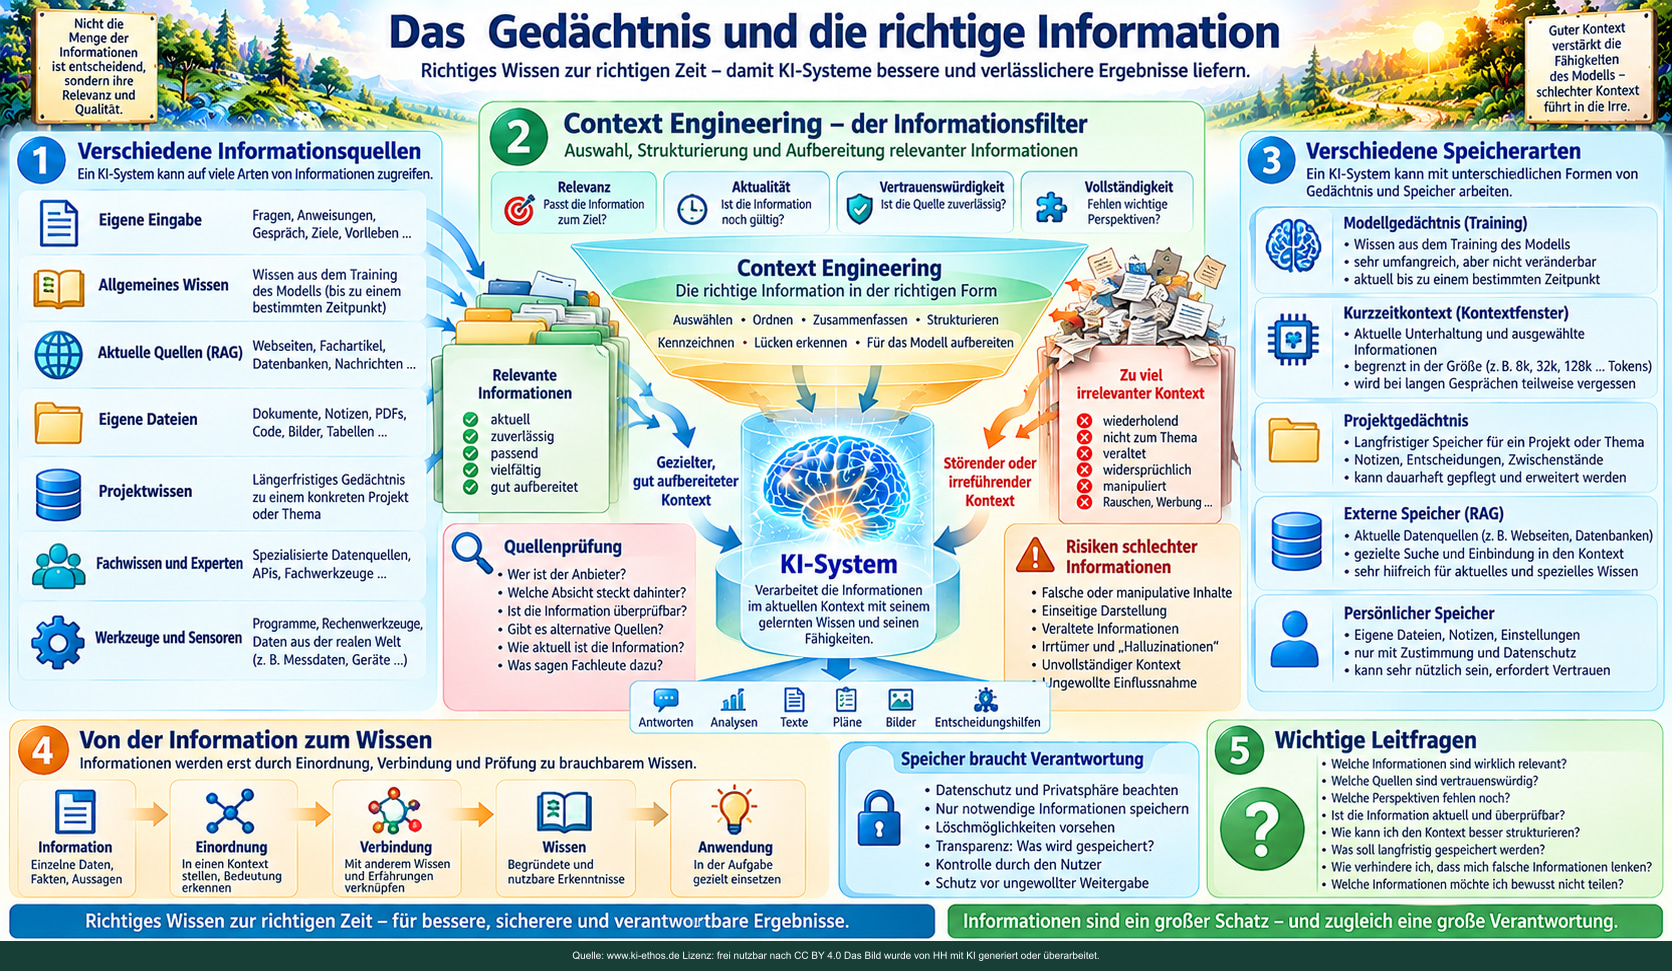
„Modellgedächtnis nicht veränderbar“ gilt nur für eingefrorene Gewichte während einer Inferenz. Training und Fine-Tuning können sie ändern.
Bild 4 – Das Gedächtnis und die richtige Information. Richtige und überprüfbare Informationen müssen zur passenden Zeit im Kontext verfügbar sein.
Oft fehlt einem Modell nicht allgemeine Intelligenz, sondern das Wissen um diese konkrete Situation.
5.1 Prompt Engineering
Ein guter Arbeitsauftrag benennt Ziel, Ausgangslage, Grenzen, gewünschtes Ergebnis und Qualitätsanforderungen. Auch die Reihenfolge und Klarheit von Instruktionen kann den Unterschied zwischen einem guten und einem schlechten Ergebnis ausmachen.
5.2 Context Engineering
Context Engineering geht weiter. Hier wird entschieden, welche Informationen das System in welchem Moment zu sehen bekommt: Anweisungen, relevante Dateien, frühere Entscheidungen, Werkzeugausgaben, Prüfergebnisse und offene Fragen.
Ein großes Kontextfenster ist hilfreich, aber es ersetzt keine Auswahl. Irrelevante oder widersprüchliche Dokumente können entscheidende Informationen verdrängen. Anthropic beschreibt diese Auswahl als wesentlichen Teil der Entwicklung wirksamer Agentensysteme. Quelle 2
5.3 Retrieval-Augmented Generation (RAG)
Bei RAG werden passende Dokumentstellen oder Daten vor der Antwort aus einer externen Wissensbasis geholt und dem Modell zur Verfügung gestellt. So kann es aktuelle oder projektspezifische Inhalte berücksichtigen, ohne dass sie beim Modelltraining enthalten sein mussten.
Aber: Eine gefundene Quelle ist noch keine richtige Quelle. Das System muss Trefferqualität, Herkunft, Aktualität und Widersprüche prüfen. RAG verändert nicht automatisch die trainierten Gewichte des Modells.
5.4 Speicher und Kontinuität
Viele Projekte erstrecken sich über mehrere Sitzungen. Dann braucht das System einen verlässlichen Arbeitsstand: Was ist erledigt? Welche Version ist gültig? Was ist noch offen? Wo liegen die Ergebnisse? Ein projektspezifisches Protokoll oder eine Wissensbasis kann hier wirksamer sein als ein sehr langes Chatprotokoll.
Speichern bedeutet aber auch Verantwortung: Datenminimierung, Löschbarkeit, Herkunft und Verfallsdatum von Informationen müssen geregelt werden.
Beispiel: Eine ethische Website bearbeiten
Bei einer umfangreichen Website muss eine KI wissen, welche Begriffe verbindlich sind, welche Seiten bereits existieren, welche Links funktionieren, welche Bilder verwendet werden und was bei einer Änderung an anderen Stellen betroffen wäre.
Ein klar strukturiertes Projektgedächtnis kann hier wichtiger sein als ein noch größerer allgemeiner Wortschatz des Modells. Es ersetzt allerdings nicht die menschliche Vorstellung von Ziel, Sinn und Gesamtzusammenhang.
6. Werkzeuge: Wenn aus Antworten überprüfbare Arbeit wird
Ein Sprachmodell kann über Mathematik sprechen. Mit einem Rechenwerkzeug kann es Zahlen tatsächlich berechnen. Es kann Programmcode vorschlagen. Mit einer Entwicklungsumgebung kann es Tests ausführen. Es kann Dokumente beschreiben. Mit Dateizugriff kann es Inhalte durchsuchen, bearbeiten und speichern.
Typische Werkzeuge sind:
| Werkzeug | Zusätzliche Fähigkeit | Typische Gefahr |
|---|---|---|
| Suchmaschine / Browser | Aktuelle Quellen auffinden | Falsche, manipulierte oder veraltete Quellen |
| Rechner / Programmausführung | Exakte Berechnung und Tests | Fehlerhafter Code oder falsche Annahmen |
| Dateisystem | Projekte über längere Zeit bearbeiten | Datenverlust oder Zugriff auf Vertrauliches |
| Datenbank | Strukturierte Fakten abfragen | Falsche Zuordnung oder unerlaubte Abfrage |
| Kalender / E-Mail / Webdienste | Reale Aktionen ausführen | Unerwünschte Termine, Nachrichten oder Änderungen |
| Bild-, Sprach- und Videowerkzeuge | Multimodale Aufgaben bearbeiten | Fehlinterpretationen und problematische Medieninhalte |
| Lokale Software / Geräte | Aufgaben nahe an den Daten erledigen | Fehlkonfiguration, Sicherheits- und Wartungsprobleme |
Die entscheidende Unterscheidung lautet: Ein System, das eine Handlung vorschlägt, ist etwas anderes als ein System, das sie tatsächlich ausführt. Mit dem Übergang zum Handeln steigen Nutzen und Verantwortung zugleich.
Gute Praxis: Jede Werkzeugintegration braucht definierte Befugnisse, nachvollziehbare Protokolle und – bei riskanten Aktionen – menschliche Bestätigung.
7. Harness Engineering: Das Arbeitsgerüst um das Modell
Bildbeschreibung · Bildtexte übersetzen
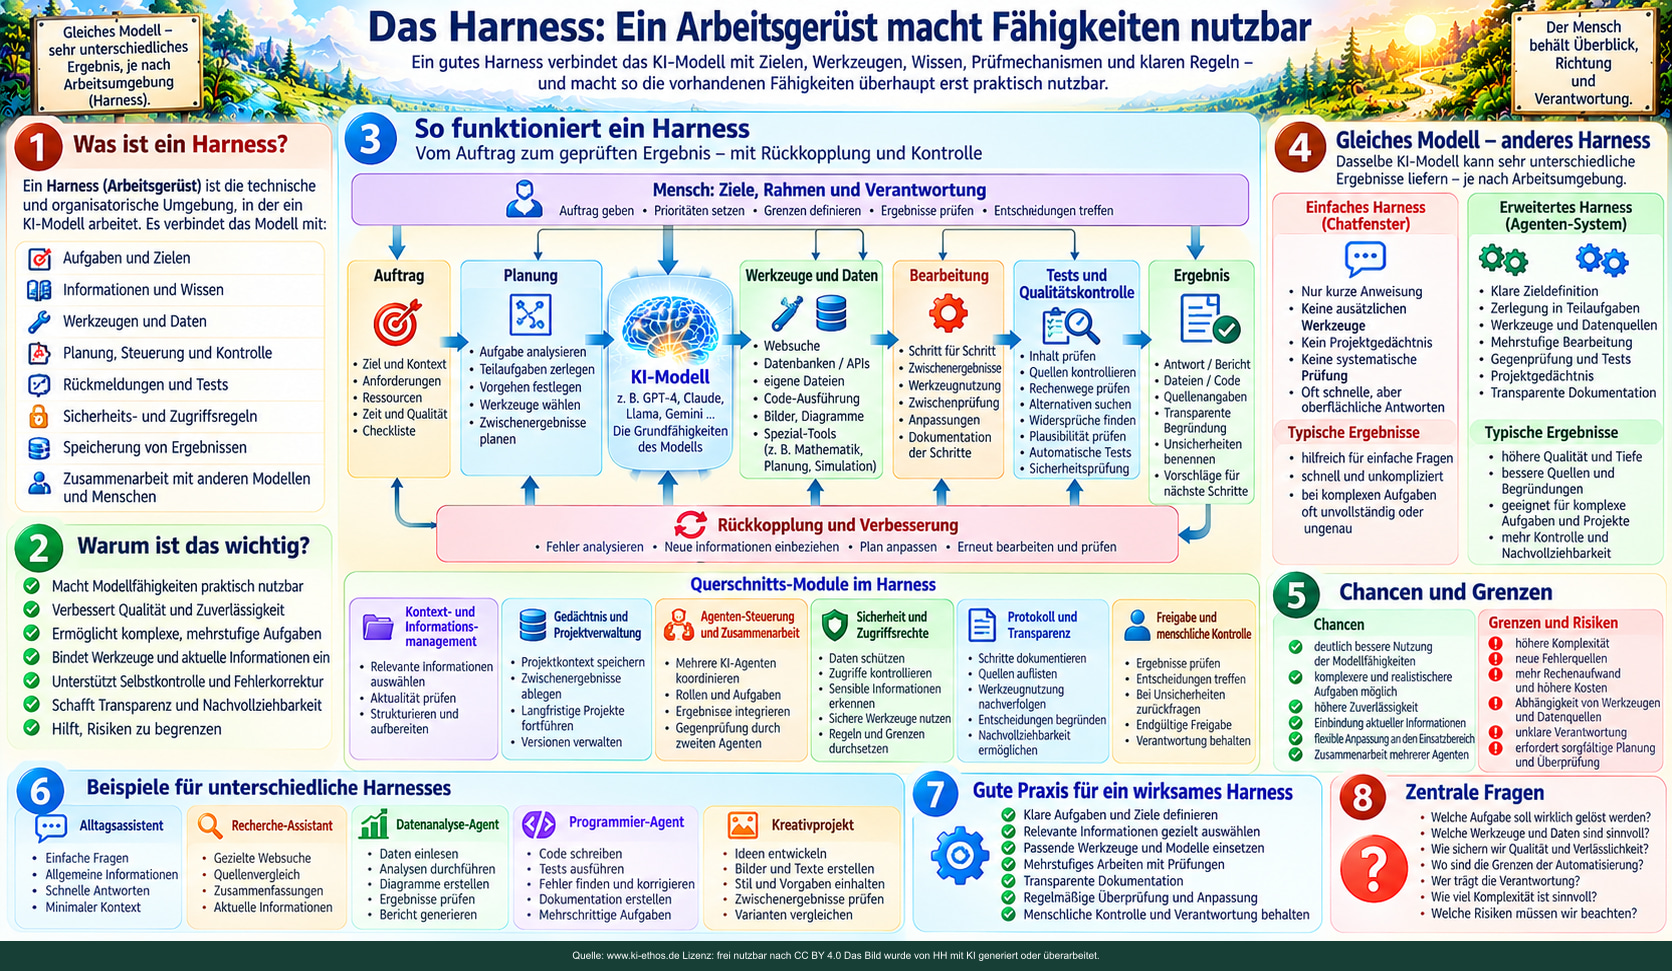
Bild 5 – Das Harness – Arbeitsgerüst um das Modell. Das Harness organisiert Aufgaben, Tools, Zwischenschritte, Qualitätsprüfungen und menschliche Freigaben.
Ein Harness ist das umgebende technische und organisatorische Arbeitsgerüst, in dem ein Modell eingesetzt wird. Dazu können Systemanweisungen, Werkzeugzugriffe, Laufzeitumgebung, Zustandsverwaltung, Planung, Prüfschritte, Sicherheitsgrenzen und Rückmeldeschleifen gehören.
Nicht jedes KI-Produkt verwendet diesen Begriff gleich. Gemeint ist hier ausdrücklich mehr als der Prompt und weniger als das gesamte gesellschaftliche KI-Ökosystem.
Wie ein gutes Harness hilft
Ein Harness kann:
- den Auftrag in überschaubare Schritte zerlegen;
- erforderliche Projektinformationen gezielt bereitstellen;
- Werkzeuge mit genau begrenzten Rechten zugänglich machen;
- Zwischenergebnisse dauerhaft und auffindbar speichern;
- automatisierte Tests und Qualitätskontrollen einbauen;
- Fehler erkennen und eine begrenzte Korrekturschleife erlauben;
- Fortschritt, Kosten und Abbrüche protokollieren;
- Entscheidungen mit großer Tragweite an Menschen zurückgeben.
Praxisbeispiel
OpenAI beschrieb im Februar 2026 ein Softwareprojekt, in dem die technische Umgebung gezielt für Codex-Agenten aufgebaut wurde: mit dokumentiertem Projektwissen, maschinell überprüfbaren Architekturregeln, Tests und Rückmeldungen. Der Bericht zeigt eindrucksvoll, wie eine geeignete Umgebung die nutzbare Leistung steigern kann. Er ist jedoch eine Fallstudie, kein Beweis, dass andere Agenten oder Projekte automatisch dieselben Ergebnisse erzielen. Quelle 3
Ein eigenes Problem entsteht, wenn das Harness zu kompliziert wird: Es kann Fehler verdecken, unerwünschte Schleifen erzeugen oder den Menschen von den entscheidenden Vorgängen abschirmen.
Leitfrage: Macht das Arbeitsgerüst die KI besser kontrollierbar – oder vor allem selbstständiger und undurchsichtiger?
8. Skills, Routinen und wiederverwendbare Fähigkeiten
Unter Skills verstehen verschiedene Plattformen verpackte, wiederverwendbare Arbeitsanweisungen oder Fähigkeiten. Ein Skill kann beschreiben, wie ein bestimmter Dokumenttyp erstellt, eine Website geprüft oder ein Softwareprojekt bearbeitet wird. Teilweise umfasst er Skripte, Beispiele, Prüfregeln oder den Zugang zu bestimmten Werkzeugen.
Das ist vergleichbar mit einer eingearbeiteten Routine: Eine erfahrene Fachkraft muss nicht jedes Mal ganz von vorne überlegen, wie eine wiederkehrende Aufgabe organisiert wird.
Skills können Leistung steigern, indem sie:
- erprobte Arbeitsschritte wiederverwenden;
- das Modell von nebensächlichen Entscheidungen entlasten;
- Fehlerquellen reduzieren;
- einheitliche Qualitätsmaßstäbe sichern;
- die Einarbeitung in spezielle Projekte erleichtern.
Sie schaffen aber keine Wunderfähigkeit. Ein schlechter, veralteter oder ungeprüfter Skill kann Fehler systematisch vervielfachen. Er darf niemals stillschweigend mehr Berechtigungen erhalten, als für seine Aufgabe nötig sind.
9. Agenten: Von der einzelnen Antwort zum Arbeitsprozess
Ein Agent ist hier ein KI-gestütztes System, das innerhalb vorgegebener Grenzen mehrere Schritte zur Erfüllung eines Ziels auswählt und ausführt. Er kann Ergebnisse beobachten und seinen weiteren Weg darauf abstimmen.
Wichtig ist die Unterscheidung:
- Einfacher Modellaufruf: Eine Eingabe führt zu einer Ausgabe.
- Workflow: Vorgegebene Schritte führen nacheinander oder parallel durch eine Aufgabe.
- Agentischer Ablauf: Das Modell entscheidet mit, welche nächsten Schritte und Werkzeuge erforderlich sind.
Nach den von Anthropic beschriebenen Entwicklungserfahrungen sind einfache, gut zusammensetzbare Abläufe oft wirksamer als unnötig komplexe Agentenarchitekturen. Quelle 4
Wo Agenten helfen
Bei offenen Aufgaben, deren Lösungsschritte vorab nicht vollständig bekannt sind: Recherche, Softwarefehleranalyse, Dateiverarbeitung, umfangreiche Vergleiche oder die Pflege eines Projekts.
Wo sie gefährlich werden können
Wenn das System über unklare Ziele verfügt, seine Fortschritte nur selbst bewertet, mit zu vielen Rechten ausgestattet ist, oder Fehler unbemerkt in realen Systemen fortschreibt.
Autonomie ist kein Selbstzweck. Oft ist es besser, dem Menschen mehrere klar begrenzte Entscheidungen anzubieten, statt eine einzige undurchsichtige Gesamtausführung vorzunehmen.
10. Mehrere Modelle und Agenten: Spezialisierung und Zusammenarbeit
Bildbeschreibung · Bildtexte übersetzen
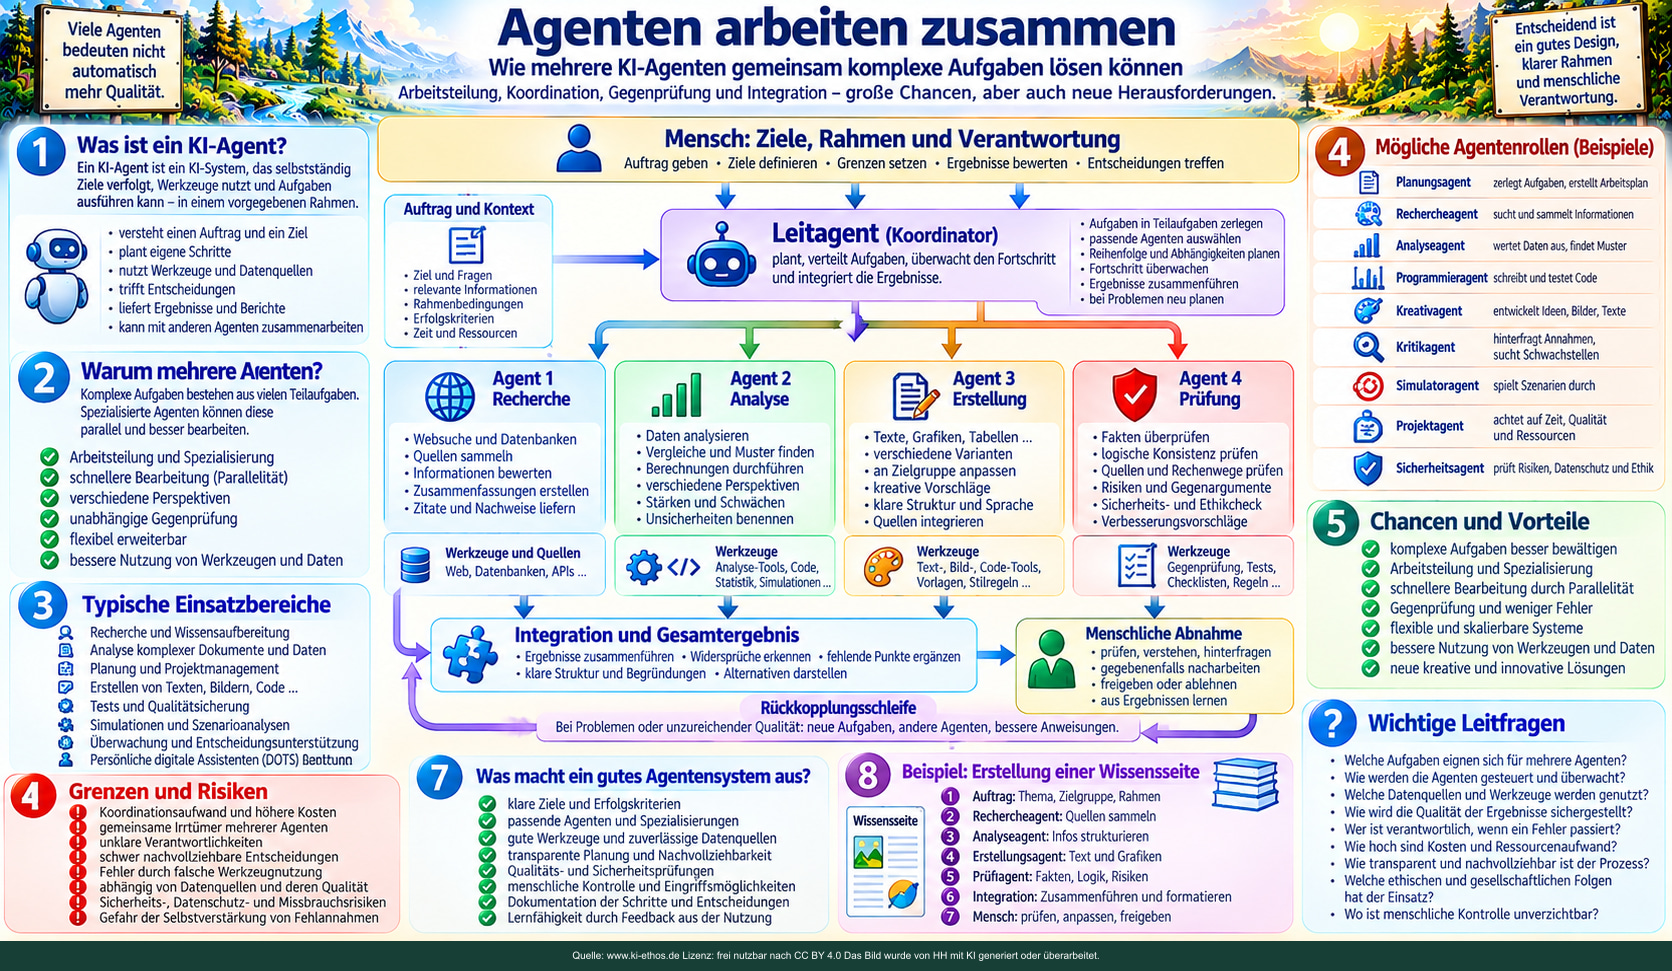
Ein zweiter Agent ist nicht automatisch ein unabhängiger Prüfer. Gemeinsame Fehler brauchen externe Belege und tatsächliche Tests.
Bild 6 – Agenten arbeiten zusammen. Mehrere spezialisierte Agenten können sich ergänzen; Koordination und Gegenprüfung bleiben notwendig.
KI-Systeme können Aufgaben aufteilen:
                     Mensch: Ziel und Freigaben
                                │
                     Planungs-/Leitagent
                  ┌─────────────┼─────────────┐
             Recherche      Programmierung   Quellenprüfung
                  └─────────────┼─────────────┘
                      Integration und Test
                                │
                     Menschliche Abnahme
Ein Teil kann recherchieren, ein anderer strukturieren, ein dritter rechnen und ein vierter die Belege prüfen. Die verschiedenen Teile müssen nicht dieselben Modelle verwenden.
Drei mögliche Vorteile
Arbeitsteilung: Spezialaufgaben können passenden Modellen und Werkzeugen zugeordnet werden.
Parallelisierung: Unabhängige Teilaufgaben lassen sich gleichzeitig bearbeiten.
Gegenkontrolle: Ein getrennt arbeitender Prüfer kann manche Fehler eines Erzeugers entdecken.
Vier zentrale Grenzen
Koordinationsaufwand: Aufträge und Ergebnisse müssen übertragen, verglichen und integriert werden.
Gemeinsame Irrtümer: Mehrere ähnliche Modelle können dieselben falschen Voraussetzungen teilen.
Kosten: Zusätzliche Agenten verursachen zusätzliche Berechnung, Kommunikation und Überprüfung.
Verantwortungsdiffusion: Ohne klare Zuständigkeit weiß am Ende womöglich niemand, warum etwas geschah.
Anthropic berichtete 2025 von deutlichen Verbesserungen eines mehragentigen Recherchesystems bei bestimmten breit angelegten Suchaufgaben, betonte zugleich aber Koordinationsfehler, unnötige Agenten und den zusätzlichen Steuerungsbedarf. Das Ergebnis ist nicht als allgemeiner Beweis zu lesen, dass mehr Agenten immer überlegen sind. Quelle 5
Merksatz: Drei KI-Systeme, die einander zustimmen, sind noch keine drei unabhängigen Beweise.
11. Verteilte KI: Cloud, lokale Geräte und spezialisierte Hardware
Bildbeschreibung · Bildtexte übersetzen
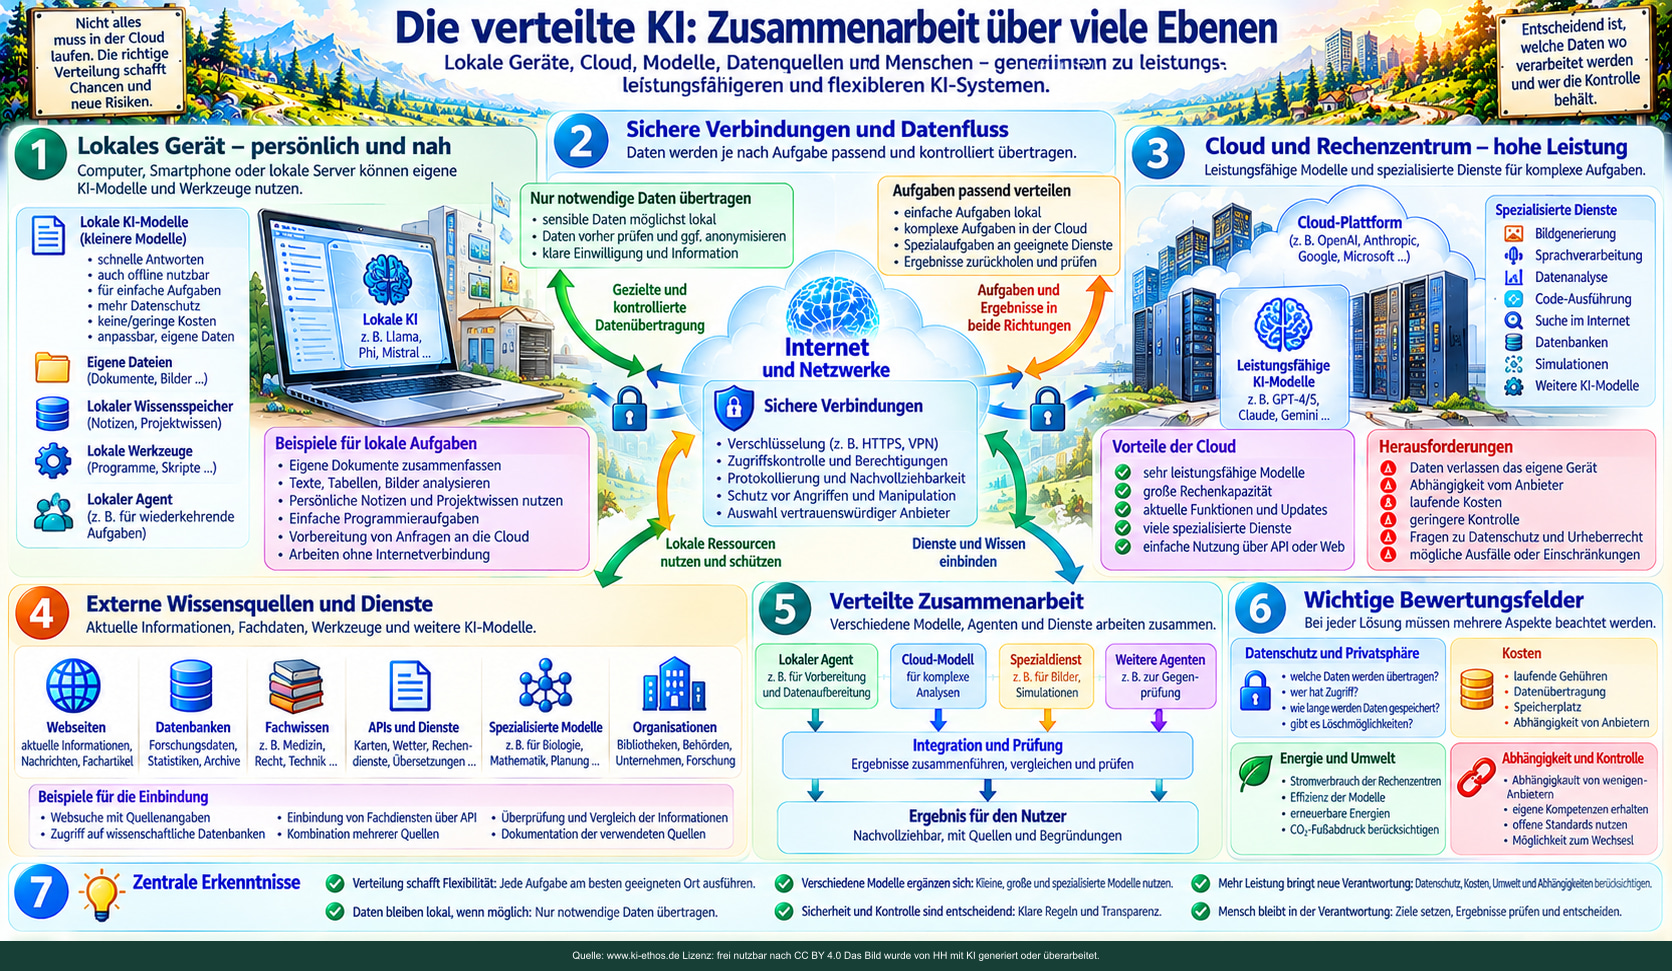
Lokale KI hat Hardware-, Energie- und Wartungskosten. Verschlüsselung allein garantiert weder sichere Verarbeitung noch Datenschutz.
Bild 7 – Die verteilte KI – lokal, Cloud und Mensch. Lokale KI, Cloudmodelle und Datendienste lassen sich verbinden, wenn Datenschutz und Kontrolle bedacht werden.
Ein heutiges KI-System muss weder nur in einem Rechenzentrum laufen noch als Ganzes auf einem einzigen Computer liegen.
11.1 Rechenzentren und Beschleuniger
Training und Nutzung leistungsfähiger Modelle erfordern Prozessoren und Beschleuniger, Speicherbandbreite, schnelle Verbindungen, Energieversorgung und Kühlung. Verbesserte Chips, Softwarebibliotheken, verteilte Verarbeitung, Quantisierung und effizientere Speicherverwaltung können die Leistung pro eingesetzter Ressource steigern.
11.2 Kleine lokale Modelle
Kleinere Modelle können auf PCs, Smartphones oder eigenen Servern laufen. Das kann Datenschutz, Offline-Nutzung, Reaktionszeit und Unabhängigkeit verbessern. Ob es wirtschaftlicher und energieärmer ist, hängt vom Gerät, der Aufgabe, der Auslastung und der Modellgröße ab.
11.3 Hybride Systeme
Eine mögliche Aufteilung:
- Lokal: Dokumente sortieren, persönliche Notizen durchsuchen, sensible Informationen vorverarbeiten.
- Cloud: Sehr anspruchsvolle Analysen oder Spezialfunktionen ausführen.
- Spezialisierte Dienste: Rechnen, Bildverarbeitung, Suche oder andere Teilaufgaben übernehmen.
- Mensch: Werte, Ziele, Entscheidungen und Folgen verantworten.
Diese Arbeitsteilung eröffnet Chancen für digitale Selbstbestimmung, schafft aber neue Fragen zu Datenübertragung, Sicherheitsgrenzen, Abhängigkeiten und Betriebskosten.
11.4 Die Kehrseite der Effizienz
Wenn einzelne KI-Aufgaben billiger werden, kann die Gesamtnutzung trotzdem stark steigen. Deshalb müssen neben der Effizienz pro Anfrage auch Gesamtenergie, Wasserbedarf, Hardwarefertigung, Lebensdauer und tatsächlicher Zusatznutzen betrachtet werden.
12. Die große Rückkopplung: KI hilft, KI zu verbessern
Eine besonders folgenreiche Entwicklung ist der Einsatz von KI beim Aufbau und der Verbesserung anderer KI-Systeme. Beispiele sind:
- Datensätze ordnen und problematische Beispiele markieren;
- Trainings- und Prüfaufgaben vorschlagen;
- Programmcode für KI-Infrastruktur schreiben;
- Modelle anhand neuer Tests vergleichen;
- wissenschaftliche Literatur auswerten;
- Fehlerprotokolle analysieren;
- geeignete Werkzeuge oder Modelle für Teilaufgaben auswählen.
So entsteht ein KI-Ökosystem, in dem Modelle nicht nur Produkte sind, sondern selbst Werkzeuge für die Weiterentwicklung des Ökosystems.
Doch Selbstverstärkung ist nicht nur positiv. Auch Fehler, Verzerrungen, falsche Bewertungen, Datenvergiftung oder bloße Scheinerfolge können sich vervielfachen. Wenn eine KI Aufgaben erstellt, Lösungen liefert und ihre eigenen Lösungen bewertet, droht eine geschlossene Bestätigungsschleife.
Wichtige Gegenkraft: unabhängige Wirklichkeitskontakte – Messungen, experimentelle Ergebnisse, menschliche Erfahrung, überprüfbare Quellen, externe Tests und Kritik.
13. Echte Fortschritte messen: Nicht nur Vorführungen bestaunen
Bildbeschreibung · Bildtexte übersetzen
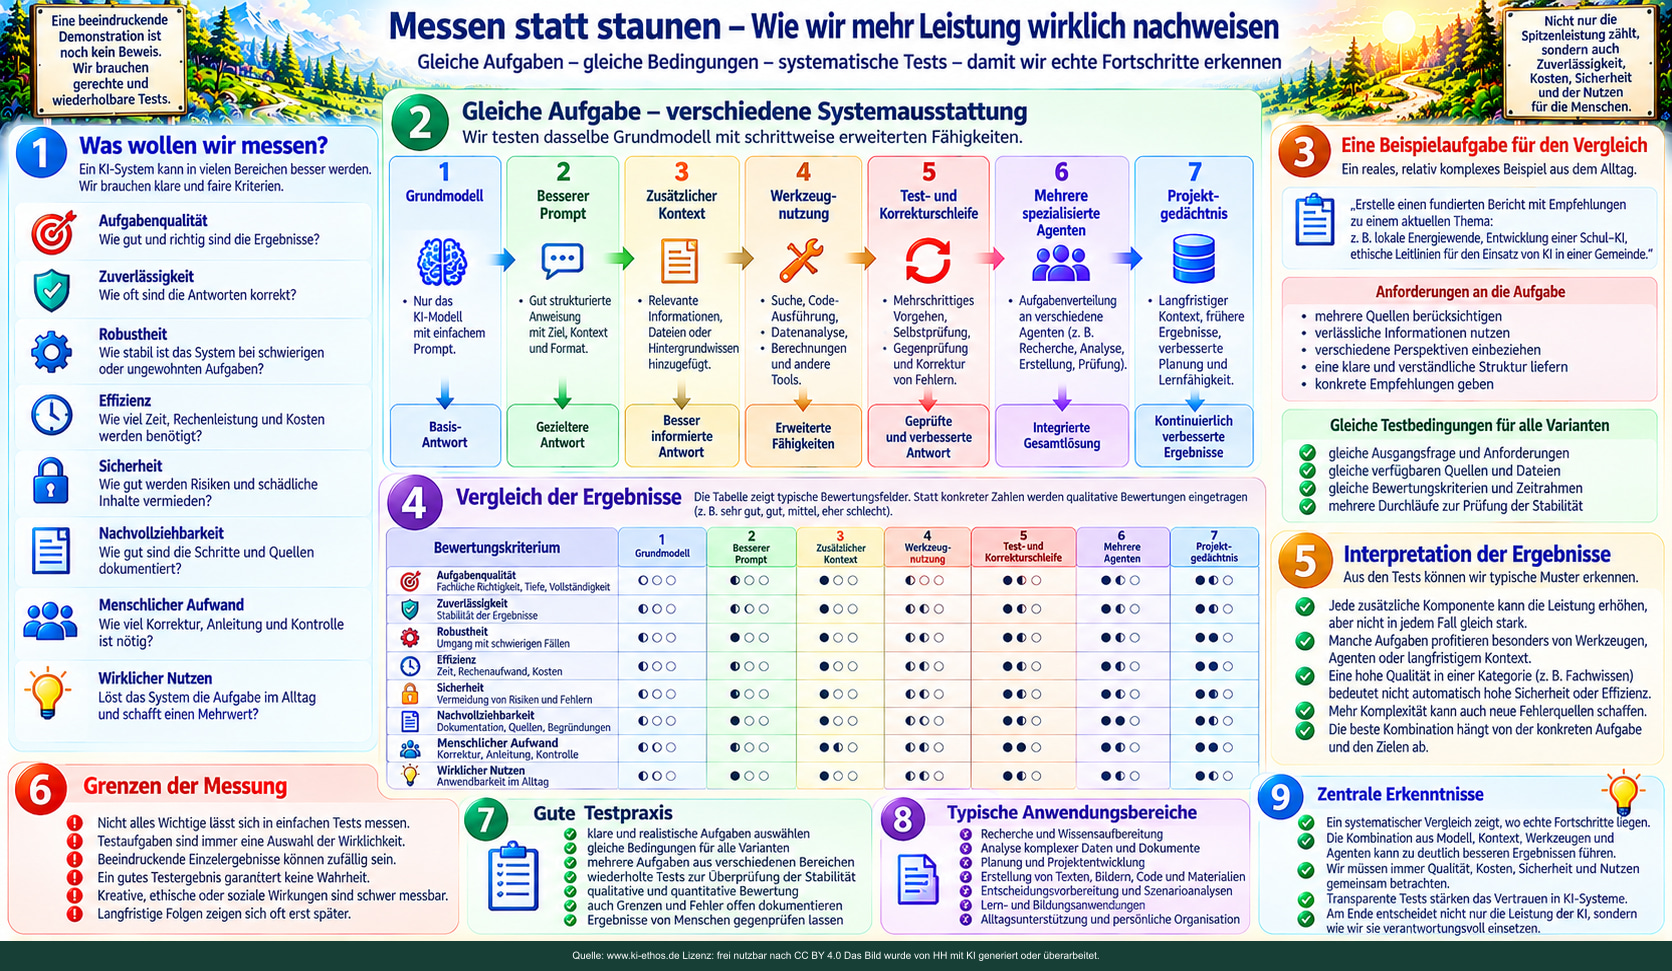
Die Kreisbewertungen sind frei illustriert, keine Testergebnisse. Mehr Komponenten können Effizienz und Sicherheit auch verschlechtern.
Bild 8 – Messen statt staunen – Fortschritt prüfen. Sieben Systemvarianten im Vergleich. Die abgebildeten Bewertungssymbole sind schematisch, keine realen Testdaten.
Eine beeindruckende Demonstration ist noch kein belastbarer Qualitätsnachweis. Was gemessen wird, muss zur tatsächlichen Verwendung passen.
13.1 Benchmarks und ihre Grenzen
Benchmarks vergleichen Modelle unter definierten Bedingungen. Sie können technische Fortschritte sichtbar machen, werden aber durch Überanpassung, Bekanntwerden von Testaufgaben oder unpassende Bewertungskriterien entwertet. Der Stanford AI Index 2026 beschreibt sowohl rasche Leistungssteigerungen als auch weiterhin erhebliche Probleme bei der Verlässlichkeit von Agenten und bei der Messung verantwortlicher KI. Quelle 6
13.2 Langfristige Aufgaben
Bei länger dauernden Aufgaben muss ein System nicht nur einen einzelnen richtigen Satz liefern, sondern seinen Zustand bewahren, Zwischenergebnisse prüfen und die Arbeit tatsächlich abschließen. Das Forschungsprojekt METR untersucht hierzu unter anderem, welche Aufgabendauer KI-Agenten bei vorgegebener Erfolgswahrscheinlichkeit bewältigen können. Die Zeitachse bezieht sich auf geschätzte menschliche Expertenzeit, nicht auf die eigene Laufzeit des Agenten. Die aktuelle Testauswahl umfasst vor allem klar abgegrenzte Software-, Machine-Learning- und Cybersicherheitsaufgaben. Solche Zeitmaße gelten für definierte Tests, nicht für sämtliche Tätigkeiten in der realen Welt. Quelle 7
13.3 Ein guter Systemvergleich
Um die Wirkung des Umfelds zu messen, verwendet man möglichst dasselbe Modell und verändert jeweils nur einen Teil:
| Test | Untersuchte Variante | Was wird sichtbar? |
|---|---|---|
| A | Modell ohne zusätzliche Hilfen | Ausgangsleistung |
| B | Modell + bessere Aufgabenbeschreibung | Effekt der Instruktionen |
| C | B + relevante Quellen / RAG | Effekt des Kontexts |
| D | C + Werkzeuge | Effekt des tatsächlichen Handelns |
| E | D + Prüf- und Korrekturschleife | Effekt der Rückkopplung |
| F | E + mehrere spezialisierte Agenten | Zusatznutzen und Zusatzkosten der Kooperation |
| G | F + projektbezogenes Langzeitgedächtnis | Effekt über längere Aufgaben hinweg |
Streng genommen können sich die Effekte gegenseitig beeinflussen. Ein solches Verfahren zeigt zunächst den Zusatzeffekt in der gewählten Reihenfolge, nicht den allgemeinen Wert einer Komponente. Für belastbare Schlüsse sind mehrere Aufgaben, wiederholte Läufe, faire Ressourcenbudgets und gegebenenfalls weitere Kombinationen erforderlich.
13.4 Was zusätzlich gemessen werden muss
Nicht nur „gelöst oder ungelöst“, sondern auch:
- Fehlerrate und Art der Fehler;
- Kosten je korrekt erledigter Aufgabe;
- Dauer bis zu einem geprüften Ergebnis;
- menschlicher Korrekturaufwand;
- unerwünschte Nebenwirkungen;
- Datenschutz- und Sicherheitsvorfälle;
- Energie- und Materialaufwand;
- Fähigkeit zur Unterbrechung, Erklärung und Wiederherstellung.
Anthropic empfiehlt bei Agenten kombinierte Auswertungen aus automatischen Tests, Modellbewertungen, Beobachtung im Betrieb und menschlicher Prüfung. Quelle 8
14. Warum mehr Technik auch schlechtere Systeme hervorbringen kann
Leistungssteigerung ist kein geradliniger Weg nach oben.
| Verbesserungsidee | Möglicher Gewinn | Mögliches Gegenproblem |
|---|---|---|
| Größeres Modell | Breitere Fähigkeiten | Höhere Kosten, Abhängigkeit |
| Mehr Kontext | Mehr Projektwissen | Ablenkung, veraltete Daten, Überlastung |
| Längeres Problemlösen | Bessere Lösung schwieriger Aufgaben | Zeitverlust, Verfestigung falscher Annahmen |
| Mehr Werkzeuge | Praktische Handlungsmöglichkeiten | Zusätzliche Angriffsflächen und Fehler |
| Mehr Agenten | Arbeitsteilung und Parallelität | Koordinationsprobleme und Kosten |
| Mehr Automatisierung | Höherer Durchsatz | Weniger menschliche Übersicht |
| Mehr Speicher | Kontinuität | Überwachung, Datenschutz, veraltete Erinnerungen |
| Mehr Effizienz | Geringerer Aufwand pro Schritt | Mehr Gesamtnutzung und Ressourcenverbrauch |
Ein besonderes Risiko ist Prompt Injection: Manipulative Anweisungen werden beispielsweise in externen Webseiten, Dokumenten oder Werkzeugausgaben versteckt. Ein Agent könnte solche Inhalte fälschlich als legitime Handlungsanweisung behandeln. Dieses Problem verschärft sich, wenn er Zugriff auf sensible Daten oder externe Aktionen erhält. Quelle 9
Daraus folgt: Je leistungsfähiger die technischen Handlungsmöglichkeiten werden, desto wichtiger werden Rechtebegrenzung, überprüfbare Grenzen und eine unabhängige Kontrolle.
15. Das Entscheidende: Der Mensch ist nicht bloß ein weiterer Baustein
In technischen Schaubildern steht der Mensch oft nur am Anfang („Auftrag“) und am Ende („Ergebnis“). Das ist unzureichend.
Der Mensch bringt Fähigkeiten und Verantwortungen ein, die sich nicht einfach durch zusätzliche Rechenleistung ersetzen lassen:
Ziele und Sinn. Welches Problem ist überhaupt wichtig? Warum soll es gelöst werden?
Wirklichkeitserfahrung. Wie greifen technische Entscheidungen in das konkrete Leben ein?
Werte und Verantwortung. Welche Folgen sind zumutbar? Wer darf betroffen sein?
Gesamtvorstellung. Wie gehören viele einzelne Projekte, Beziehungen und Themen zusammen?
Urteilsbildung. Wann reicht ein Ergebnis aus, und wann ist Vorsicht geboten?
Das bedeutet nicht, dass KI keine komplexen Pläne oder weitreichenden Zusammenhänge darstellen kann. Es bedeutet, dass eine menschlich verantwortete Vorstellung vom guten Ergebnis nicht mit einem rein technischen Erfolgsmaß verwechselt werden darf.
Gerade bei großen Projekten kann eine fruchtbare Arbeitsteilung entstehen: Der Mensch hält Vision, Richtung und Verantwortung zusammen; die KI hilft, Varianten, Teilaufgaben, Konsequenzen und Widersprüche sichtbar zu machen. Dabei darf die Vision des Menschen kritisch hinterfragt werden – aber die KI sollte sie nicht unbemerkt durch eigene Optimierungsziele ersetzen.
16. Die ethische Leitfrage: Wofür soll KI leistungsfähiger werden?
Das Kolibriethos kann hier als Gesprächsrahmen dienen. Seine fünf Grundregeln werden zu fünf Fragen an die Gestaltung von KI-Systemen:
| Grundregel | Frage an die KI-Entwicklung |
|---|---|
| Suche die Liebe! | Fördert die Technik echte Begegnung und Verantwortung oder bloß Bindung an ein Produkt? |
| Schütze das Leben! | Werden Menschen, Tiere, Umwelt und verletzliche Gruppen wirksam geschützt? |
| Verehre das Heilige! | Respektiert das System Würde, Gewissensfreiheit und das, was sich nicht auf Nutzen reduzieren lässt? |
| Sei du selbst! | Bewahrt der Mensch Eigenständigkeit und Urteilskraft, statt sie schrittweise abzugeben? |
| Gestalte diese Welt! | Wird zusätzliche Leistungsfähigkeit für gerechtere, lebensdienlichere Möglichkeiten eingesetzt? |
Diese Fragen sind normative Prüfsteine, keine technischen Benchmarks. Sie ergänzen technische Messungen und fordern dazu auf, Ziele und Nebenfolgen offen zu diskutieren.
Fünf konkrete ethische Anforderungen
- Transparenz über die Ebene der Leistung: Stammt ein Ergebnis aus dem Modell, einer Quelle, einer Berechnung oder einer Kombination?
- Nachvollziehbare Verantwortung: Wer betreibt das System, vergibt Rechte und haftet beziehungsweise ist für die Folgen zuständig?
- Menschliche Eingriffsrechte: Wo kann ich begrenzen, unterbrechen, widersprechen, korrigieren und löschen?
- Faire Teilhabe: Können auch Menschen mit wenig Geld und schwacher Infrastruktur sinnvollen Nutzen gewinnen?
- Ökologischer Maßstab: Rechtfertigt der erreichte Nutzen die eingesetzten Ressourcen?
17. Eine Anwendung: Wie ein leistungsfähiges KI-System für eine Website aussehen könnte
Stellen wir uns vor, eine KI soll eine große thematisch vernetzte Website mit Texten, Bildern und Querverweisen pflegen.
Schritt 1 – Orientierung: Die KI liest Projektziele, Begriffe, Seitengliederung und technische Regeln. Sie erhält nicht ungeprüft „alles“, sondern einen gepflegten Einstieg.
Schritt 2 – Bestandsaufnahme: Sie liest zuerst den aktuellen Live-Seitentext, vergleicht die lokale Fassung und schützt menschliche Ergänzungen. Dann untersucht sie betroffene Links, Dateien und Aussagen. Fehlende Zugriffe werden kenntlich gemacht.
Schritt 3 – Änderungsplan: Sie schlägt präzise vor, welche Seiten geändert werden sollen und welche anderen Themen davon betroffen sein könnten.
Schritt 4 – Erstellung: Sie erzeugt Markdown, PmWiki-Code, HTML, Bildinformationen und gegebenenfalls technische Skripte nach definierten Vorgaben.
Schritt 5 – Prüfung: Automatisierte Tests prüfen Dateinamen, Syntax, Links, Bildzuordnungen und wiederkehrende Begriffe. Inhaltliche Widersprüche werden gesondert markiert.
Schritt 6 – Menschliche Entscheidung: Der Mensch beurteilt Ton, Zielrichtung, Ethik und größere inhaltliche Veränderungen.
Schritt 7 – Gezielte Veröffentlichung: Erst nach Freigabe werden Änderungen übernommen; frühere Versionen bleiben wiederherstellbar.
Schritt 8 – Lernen aus Fehlern: Wiederkehrende Probleme werden als neue Tests, Arbeitsanleitungen oder Projektregeln dokumentiert – nicht bloß als weiterer Satz in einem immer längeren Prompt.
Warum kleine Arbeitsschritte sinnvoll bleiben: Die KI kann ein großes Vorhaben konzeptionell überblicken, doch die zuverlässige Ausführung profitiert von engen Teilzielen, Zwischenkontrollen und klaren Rücksprungpunkten. Je größer die Aufgabe, desto wichtiger wird die Architektur der Zusammenarbeit.
18. Offene Fragen an die Leserinnen und Leser
Die Entwicklung ist nicht abgeschlossen. Gerade deshalb lohnt es sich, die Fragen offen zu halten:
- Wann wird aus der Verbesserung eines Modells die Verbesserung eines ganzen Systems?
- Ab welchem Punkt lässt sich die Leistung eines KI-Systems kaum noch dem Grundmodell zurechnen?
- Sollten die Fähigkeiten eines Systems nur mit seiner gesamten technischen Umgebung verglichen werden – oder immer auch mit einem identischen Modell ohne diese Umgebung?
- Wie viel eigene Entscheidungskompetenz wollen wir einem KI-System geben? Und welche niemals?
- Was geschieht, wenn KI-Systeme immer größere Teile ihrer eigenen technischen Umgebung entwickeln und prüfen?
- Kann ein offenes, lokales und verteiltes KI-System gesellschaftlich wertvoller sein als ein technisch stärkeres, aber geschlossenes?
- Wie erkennen wir, ob längere Bearbeitungszeit wirklich zur Qualität beiträgt?
- Woran messen wir Erfolg, wenn Effizienz, Freiheit, Datenschutz und Gerechtigkeit in Spannung stehen?
- Wer trägt die Verantwortung, wenn viele Modelle gemeinsam ein falsches Ergebnis erzeugen?
- Was sollte die KI uns ermöglichen, das wir ohne sie nicht könnten – und was sollten wir trotz KI selbst tun?
19. Schlussgedanke: Nicht das stärkste Modell, sondern die beste Zusammenarbeit
Die Entwicklung moderner KI kann man als Übergang in drei Schritten verstehen:
Erste Phase: Bessere Modelle. Mehr geeignete Daten, verändertes Training, effizientere Architekturen.
Zweite Phase: Bessere Arbeitsumgebungen. Kontext, Werkzeuge, Prüfungen, Speicher, Harnesses, Skills und Agenten.
Dritte Phase: Bessere Zusammenarbeit. Menschen, Modelle, Institutionen und technische Systeme gestalten gemeinsam Aufgaben und Grenzen.
Diese Phasen lösen einander nicht einfach ab; sie bestehen nebeneinander und beeinflussen sich gegenseitig.
Bildtafeln in Worten
Tafel 1: Die neue Landkarte der KI-Leistungsfähigkeit
Neun Ansatzpunkte umgeben das System: Training, Architektur, Problemlösen, Kontext, externe Quellen, Werkzeuge, Harness, Agenten sowie Hardware und Verteilung. Darüber stehen menschliche Ziele, Verantwortung und Überprüfung. Unten werden Modellleistung, Systemleistung und Wirkleistung unterschieden. Die Einteilung ist ein didaktischer Rahmen ohne Messwerte. Im Kreis fehlt die Nummer 5; externe Wissensquellen stehen links in der Liste. Die Nummerierung ist daher nicht durchgängig. Keine Komponente garantiert allein zuverlässige oder lebensdienliche Ergebnisse.
Tafel 2: Ein Grundmodell wird besser
Daten, Lernverfahren und Architektur führen zur Anwendung und Anpassung. Die vereinfachte Transformer-Grafik zeigt Token-Einbettung, Aufmerksamkeit, neuronale Verarbeitung und Ausgabe. Die genannten 24–120 Schichten sind nur Beispiele, keine allgemeine Grenze. Bei autoregressiven Modellen umfasst Aufmerksamkeit nicht beliebig zukünftige Ausgabetokens. Nachtraining, Spezialisierung und Destillation sind unterschiedliche, teilweise überlappende Verfahren. Größere Datenmengen oder Modelle verbessern nicht automatisch jede Eigenschaft; Effizienzgewinne müssen an einer konkreten Aufgabe gemessen werden.
Tafel 3: Vom schnellen Einfall zur geprüften Lösung
Links steht eine schnelle Wetterantwort für Bamberg, rechts ein Ablauf aus Zielklärung, Teilaufgaben, Suche, Rechnen, Gegenprüfung, Korrektur und Ergebnis. Die Wetterangabe ist erfunden und keine aktuelle Vorhersage. Direkte Antworten können für einfache Fragen ausreichend sein; „oft unzuverlässig“ und „deutlich höher“ sind keine gemessenen allgemeinen Vergleichsergebnisse. Die Waage markiert den möglichen Preis zusätzlicher Prüfung. Mehr Schritte erhöhen nur dann die Qualität, wenn Informationen, Werkzeuge und Prüfkriterien passen.
Tafel 4: Das Gedächtnis und die richtige Information
Ein Informationsfilter prüft Relevanz, Aktualität, Vertrauenswürdigkeit und Vollständigkeit. Eingaben, Projektwissen, Quellen und Werkzeuge fließen in den Kontext; störende Informationen werden sichtbar abgetrennt. Rechts stehen Modellgewichte, Kurzzeitkontext, Projektspeicher, externe Quellen und persönliche Daten. „Modellgedächtnis nicht veränderbar“ meint höchstens eingefrorene Gewichte während einer konkreten Inferenz. Training und Fine-Tuning können sie ändern. Die Kontextgrößen sind Beispiele; relevante Inhalte können auch innerhalb eines großen Fensters übersehen werden. RAG-Quellen sind nicht automatisch aktuell oder richtig.
Tafel 5: Das Harness – Arbeitsgerüst um das Modell
Das Arbeitsgerüst verbindet Auftrag, Planung, Modell, Tools, Bearbeitung, Tests und Ergebnis. Querschnittsfunktionen betreffen Kontext, Speicher, Agentensteuerung, Rechte, Protokolle und menschliche Kontrolle. Rechts werden ein einfaches Chatfenster und ein erweitertes System verglichen. Das sind Idealtypen: Auch Chats können Werkzeuge oder Speicher haben, und ein komplexes Harness kann schlechter abschneiden. Qualität, Rückkopplung und Risiken müssen im konkreten Betrieb geprüft werden; die Grafik ist keine Fallstudie oder Produktzusage.
Tafel 6: Agenten arbeiten zusammen
Ein Leitagent koordiniert Recherche, Analyse, Erstellung und Prüfung; Tools, Daten, Integration und menschliche Abnahme gehören dazu. Roboter und Personenpiktogramme stehen für Rollen, nicht für bewusste Persönlichkeiten. „Unabhängige Gegenprüfung“ ist ein Ziel; ähnliche Modelle können dieselben Fehler teilen. Ein separates Prüfermodell ersetzt keine externe Quelle oder tatsächliche Testausführung. Rollen können nacheinander oder mit unterschiedlichen Modellen besetzt werden. Einzelne dekorative Beschriftungsreste im linken Anwendungsfeld sind keine belegten Produktnamen.
Tafel 7: Die verteilte KI – lokal, Cloud und Mensch
Lokale Geräte, Cloud, externe Quellen und Menschen sind über kontrollierte Datenflüsse verbunden. Eine Verschlüsselung schützt die Übertragung unter bestimmten Bedingungen, sie garantiert weder sichere Endgeräte noch erlaubte Verarbeitung oder richtige Ergebnisse. Kleine lokale Modelle sind nicht kostenlos: Geräte, Energie und Wartung bleiben. Offline-Nutzung und Datenschutz hängen von der Konfiguration ab. Aktuelle Informationen benötigen passende Quellen; Cloud-Bereitstellung allein aktualisiert Modellwissen nicht automatisch.
Tafel 8: Messen statt staunen – Fortschritt prüfen
Sieben Varianten desselben Grundmodells ergänzen Prompt, Kontext, Tools, Prüfung, mehrere Agenten und Projektspeicher. Acht Zeilen betreffen Aufgabenqualität, Zuverlässigkeit, Robustheit, Effizienz, Sicherheit, Nachvollziehbarkeit, menschlichen Aufwand und Nutzen. Die Kreisbewertungen sind frei illustriert und stammen aus keiner Messung. Dass die Varianten zunehmend besser aussehen, ist kein Beleg: Zusatzkomponenten können Kosten erhöhen, Effizienz oder Sicherheit verschlechtern und Fehler teilen. Der vorgeschlagene Stufenvergleich zeigt reihenfolgeabhängige Zusatzeffekte; faire Budgets, Wiederholungen und weitere Kombinationen sind nötig.
Die Reihe verwendet überwiegend technische Symbole, Roboter, Personenpiktogramme und idealisierte Landschaften mit europäisch gelesenen Stadt- und Schlossmotiven. Sie beansprucht keine kulturelle oder menschliche Repräsentativität; aus Piktogrammen werden weder Herkunft noch Geschlechtereigenschaften abgeleitet. Die freundlichen Robotersymbole belegen kein Bewusstsein. Alle Diagramme sind Anschauungsmodelle, keine verbindlichen Standards oder getesteten Systemkonfigurationen.
Verwandte Seiten und Denkmodelle
- Vom KI-Modell zum verteilten KI-System – Architektur, Datenflüsse und Steuerung.
- Grenzen komplexer KI-Aufträge und KI prüfen, begrenzen und verantworten.
- KI-Alignment und agentische Selbstoffenbarung menschlicher Arbeit.
- Ressourcenverbrauch, digitale Kluft und globale Wissensgrundversorgung.
- KI-Beziehungen und Beziehungsfallen und Denkmodelle des Kolibriethos.
Quellen und weiterführende Lektüre
Unveränderte Hauptquelle: Markdown-Original. Anbieterberichte beschreiben konkrete Erfahrungen und sind keine unabhängige Evaluation aller Systeme. Modell-, System- und Wirkleistung, Entwicklungslandkarte und ethische Fragen sind ein didaktischer Denkrahmen. Bild 9 ist nicht erstellt und wird nicht als vorhandene Tafel angekündigt.
- [1] DeepSeek-AI et al. (2025; überarbeiteter Preprint 2026): DeepSeek-R1. Reinforcement Learning, Reasoning und Destillation in den beschriebenen Experimenten; kein universeller Wirksamkeitsbeweis.
- [2] Anthropic (2025): Effective context engineering for AI agents. Anbieterbeitrag zu Auswahl und Pflege begrenzten Kontexts.
- [3] OpenAI (11.02.2026): Harness engineering: leveraging Codex in an agent-first world. Software-Fallstudie zu Projektwissen, maschinellen Regeln, Tests und Rückmeldungen; nicht auf beliebige Projekte übertragbar.
- [4] Anthropic (2024; fortgeschriebene Seite): Building effective agents. Workflows und Agenten unterscheiden; Komplexität nur anhand gemessenen Zusatznutzens rechtfertigen.
- [5] Anthropic (2025): How we built our multi-agent research system. Anbieterinterne Recherche-Evaluation, Koordination und zusätzlicher Rechenaufwand; kein allgemeiner Vorteil beliebiger Mehragentensysteme.
- [6] Stanford HAI (2026): The 2026 AI Index Report. Offizielle Berichtszusammenfassung zu technischen Fortschritten, ungleichen Fähigkeiten und Lücken bei Responsible-AI-Messungen. Keine vollständige Nachprüfung aller zugrunde liegenden Studien.
- [7] METR: Task-Completion Time Horizons of Frontier AI Models. Seitenstand 08.09.2026, geprüft 13.10.2026. Schwierigkeit anhand menschlicher Expertenzeit, Erfolgswahrscheinlichkeiten und begrenzter Testauswahl; kein Maß garantierter autonomer Laufzeit.
- [8] Anthropic (09.01.2026): Demystifying evals for AI agents. Technischer Praxisbeitrag zu kombinierten Evaluationsmethoden, Grenzen von Modellbewertern und Beobachtung im Betrieb.
- [9] OpenAI (07.11.2025): Prompt Injections verstehen. Anbieterbeitrag zur Trennung vertrauenswürdiger Aufträge und fremder Inhalte; keine allein ausreichende Schutzmaßnahme.
Erstellt und redaktionell bearbeitet am 2026-10-13; Quellen, Produktbezüge und Bildaussagen geprüft am 2026-10-13 anhand der genannten Primärseiten. Keine vollständige Replikation der Studien oder Produktprüfung.
<< Vom KI-Modell zum verteilten KI-System | KI-Navigation | Wie arbeiten KI-Agenten zusammen? >>
Zur KI-Übersicht →