Die Grenzen komplexer KI-Aufträge – Intelligenz, Autonomie und Selbstkontrolle
<< Kann eine KI ein eigenes Wollen entwickeln? | KI-Navigation | Denken und Grenzen >>
Diskussionsgrundlage für den Bereich KI · Stand: 8. Oktober 2026
Warum eine KI viel verstehen kann und trotzdem an einem großen Vorhaben scheitern kann
Kernthese: Die Fähigkeit, eine große Aufgabe zu verstehen oder überzeugend zu beschreiben, ist nicht identisch mit der Fähigkeit, sie über viele Schritte hinweg richtig, zuverlässig und verantwortbar auszuführen. Je größer der Auftrag, desto wichtiger werden nicht nur Intelligenz und Autonomie, sondern auch Selbstkontrolle, überprüfbare Zwischenergebnisse und eine klare menschliche Entscheidungshoheit.
Einordnung: Diese Seite gehört in den Themenbereich KI von KI-Ethos. Sie ergänzt Kann eine KI ein eigenes Wollen entwickeln?. Die eigenständige Frage nach menschlichen und künstlichen Visionen eines Projekts bleibt ein eigenständiges Thema für eine mögliche spätere Vertiefung.
1. Das Paradox: Großartige Gespräche, schwierige Großprojekte
Eine moderne KI kann über Philosophie, Theologie, Technik oder gesellschaftliche Probleme lange, komplexe und differenzierte Gespräche führen. Sie kann zahlreiche Gesichtspunkte gleichzeitig erläutern, Beispiele entwickeln, Gegenargumente prüfen und Zusammenhänge zwischen entfernten Themen herstellen.
Doch die praktische Aufgabe „Baue eine vollständige Ethik-Website mit 500 Seiten, Hunderten Bildern, Querverweisen, Suchfunktion und ansprechender Navigation“ ist etwas anderes. Auch eine KI, die jede einzelne Teilaufgabe erklären kann, muss sie deshalb noch lange nicht als zusammenhängendes Gesamtvorhaben zuverlässig bewältigen.
Darin liegt kein einfacher Gegensatz zwischen Denken und Handeln. Schon die Entwicklung einer guten philosophischen Argumentation ist eine anspruchsvolle Tätigkeit; auch eine Erklärung kann sachlich falsch sein. Der Unterschied liegt vor allem in der Art, wie Fehler sichtbar werden und welche Folgen sie haben:
- Ein Gedankengang kann mehrere vertretbare Deutungen haben. Eine Programmdatei muss dagegen die verlangte Funktion tatsächlich erfüllen.
- In einem Gespräch korrigieren sich Menschen und KI fortlaufend. Ein lang arbeitender Agent kann viele Entscheidungen treffen, bevor ein Mensch das Ergebnis sieht.
- Ein ungenauer Satz ist häufig schnell verbessert. Eine falsche Änderung an einer gemeinsam verwendeten Datei kann zahlreiche Seiten betreffen.
- Ein Text kann plausibel wirken, obwohl ein Beleg fehlt. Eine Website kann auf den ersten Blick gut aussehen, obwohl Navigation, Berechtigungen oder Backups beschädigt wurden.
Daher muss man stets zwei Fragen stellen: Kann die KI das Problem durchdenken? Und unabhängig davon: Kann sie den vereinbarten Auftrag nachweislich richtig und ohne unerlaubte Nebenwirkungen umsetzen?
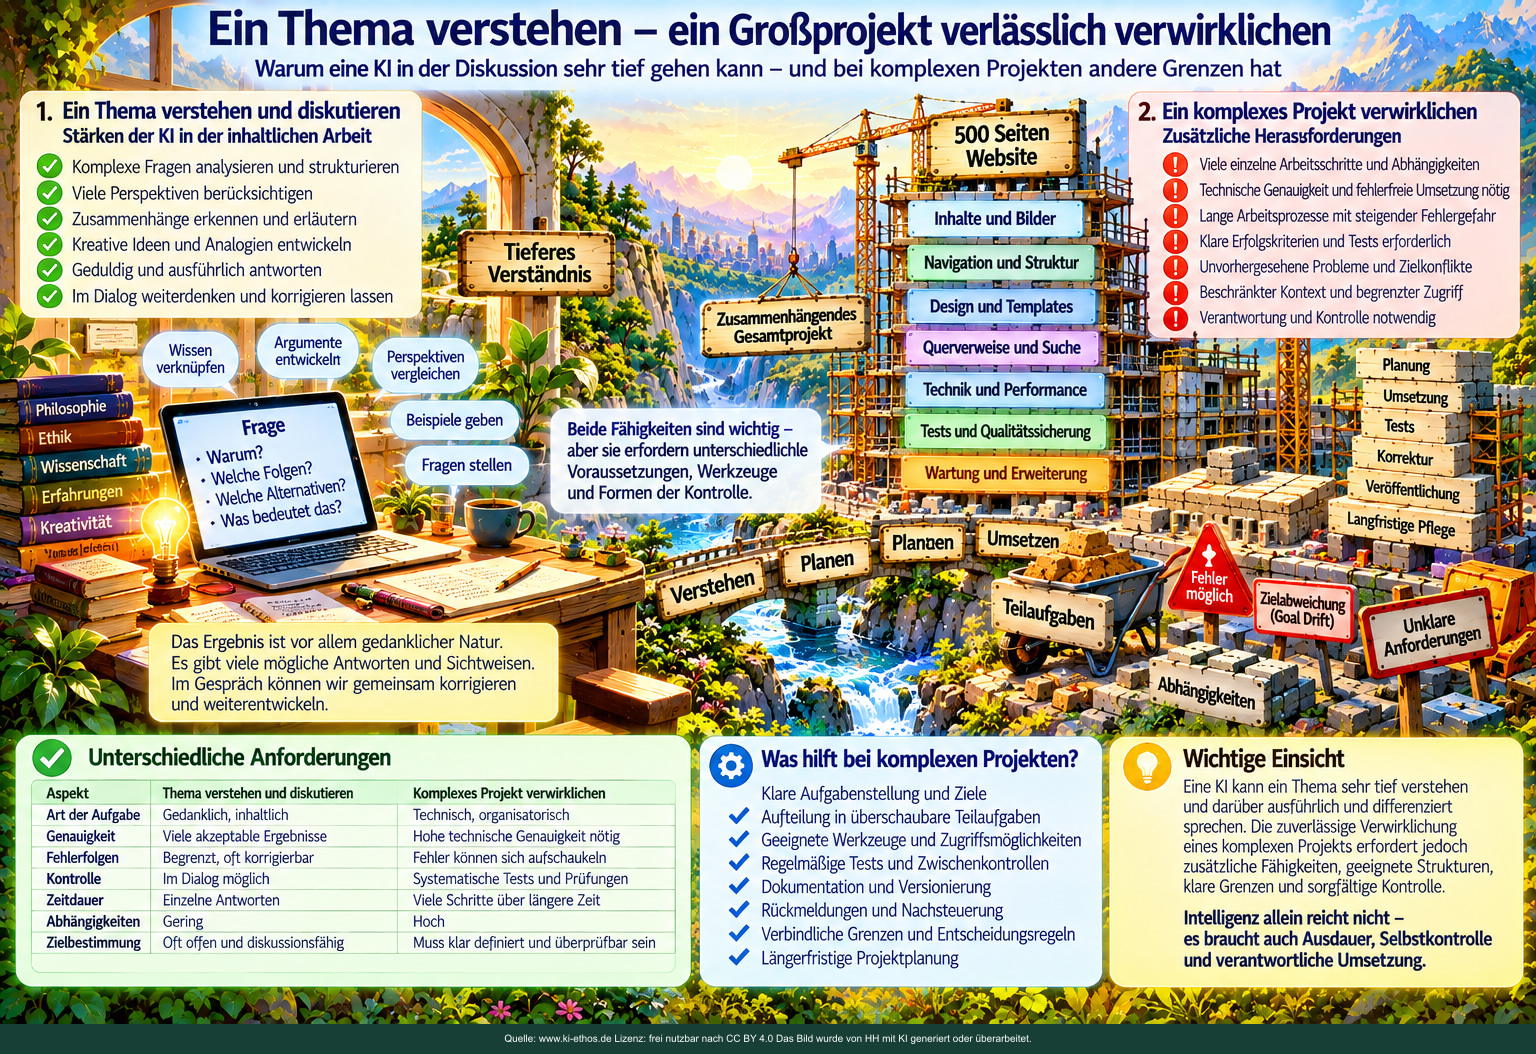
Abbildung 1: Ein Thema verstehen – ein Großprojekt verlässlich verwirklichen. Bildtexte übersetzen.
Ein linkes Wissens- und Gesprächsfeld wird einer großen Baustelle für eine Website mit 500 Seiten gegenübergestellt. Der verbindende Weg zeigt, dass komplexes Verstehen, Planung und verlässliche technische Umsetzung unterschiedliche Anforderungen stellen: Tests, Koordination, Kontrollen und langfristige Pflege sind notwendig.
Einordnung der Bildtafel: Einzelne kleine Buchrücken und Wörter sind unleserlich. Die Kernaussage betrifft unterschiedliche Arbeitsanforderungen; auch Gespräche und Texte benötigen Quellen- und Sachprüfung.
2. Was ist überhaupt ein komplexer KI-Auftrag?
Groß ist nicht immer schwierig, und schwierig ist nicht immer groß. Ein Skript kann Tausende ähnlich aufgebaute Seiten in kurzer Zeit korrekt umwandeln. Dagegen kann die Ursachenanalyse eines einzigen seltenen Programmfehlers Tage beanspruchen.
Die Komplexität eines Auftrags entsteht aus mehreren unterschiedlichen Dimensionen:
| Dimension | Leitfrage | Beispiel einer Website |
|---|---|---|
| Umfang | Wie viele Arbeitsschritte und Elemente gibt es? | 500 Seiten, 700 Bilder, Tausende Links |
| Fachliche Tiefe | Wie schwierig sind die inhaltlichen Entscheidungen? | Eine fundierte Darstellung von Freiheit und Verantwortung |
| Abhängigkeiten | Wie stark beeinflussen sich Teilentscheidungen? | Eine Template-Änderung verändert die Darstellung zahlreicher Seiten |
| Unbestimmtheit | Wie viel muss die KI selbst auslegen? | Was bedeutet „besonders benutzerfreundlich“? |
| Dynamik | Wie häufig verändern sich Informationen und Anforderungen? | Neue Bilder, Modelle, Ergänzungen, technische Updates |
| Prüfbarkeit | Kann man objektiv feststellen, dass das Ergebnis richtig ist? | Ein Linktest ist leichter als die Beurteilung ethischer Tiefe |
| Folgen von Fehlern | Wie teuer, gefährlich oder irreversibel sind Irrtümer? | Ein fehlerhafter Entwurf versus Datenverlust auf der Live-Website |
| Berechtigungen | Was darf die KI tatsächlich ändern oder veröffentlichen? | Entwurf ändern, produktives Template überschreiben, Daten löschen |
Die Dimensionen verstärken einander. Ein Auftrag mit sehr vielen unabhängigen, gut testbaren Schritten kann einfacher sein als ein Auftrag mit wenigen, hochgradig voneinander abhängigen und nur subjektiv prüfbaren Entscheidungen.
Entscheidend ist nicht die bloße Länge des Auftrags, sondern die Kombination aus Abhängigkeit, Unsicherheit, Prüfbarkeit und Schadenspotenzial.
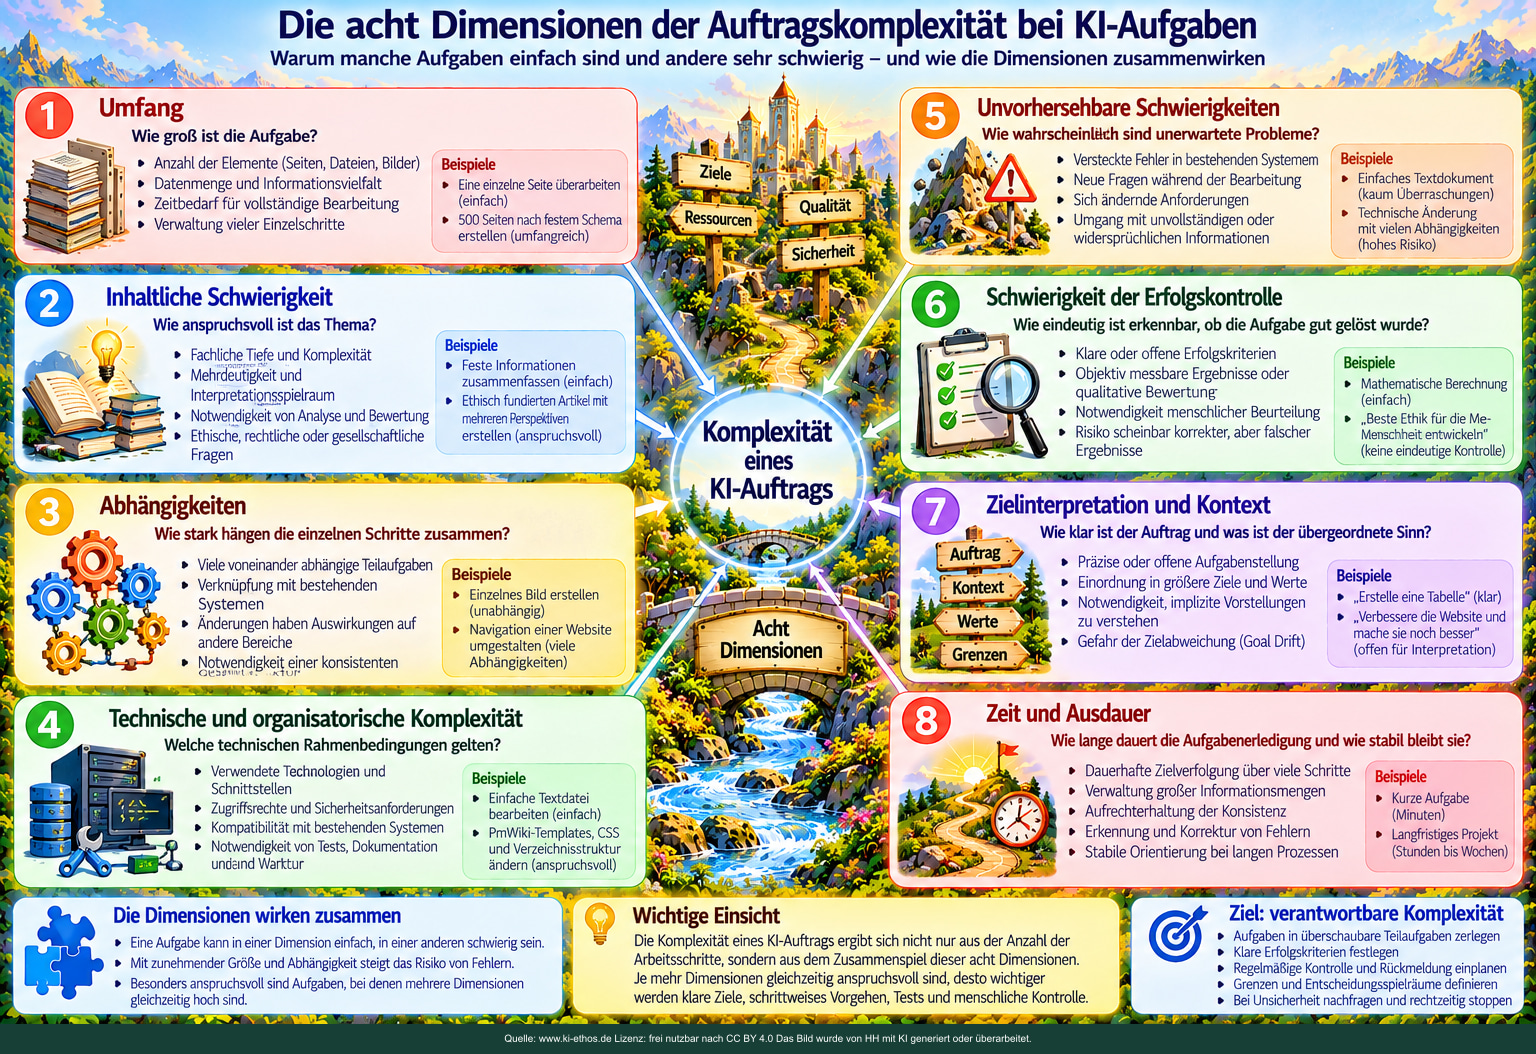
Abbildung 2: Die acht Dimensionen der Auftragskomplexität. Bildtexte übersetzen.
Acht Themenfelder umkreisen einen komplexen KI-Auftrag: Umfang, inhaltliche Schwierigkeit, Abhängigkeiten, technische und organisatorische Komplexität, unvorhersehbare Schwierigkeiten, Erfolgskontrolle, Zielinterpretation und Kontext sowie Zeit und Ausdauer. Die Kategorien illustrieren miteinander verflochtene Anforderungen, sind jedoch anders benannt als die acht analytischen Dimensionen in Abschnitt 2 des Artikels.
Einordnung der Bildtafel: Die acht Bildmerkmale gliedern Komplexität anders als die acht Tabellenzeilen. Sie sind ergänzende Perspektiven, keine deckungsgleiche oder validierte Skala. Einzelne kleine Beschriftungen sind fehlerhaft.
3. Ein Auftrag besteht aus mehr als einem Ziel
Die Anweisung „Verbessere meine Website“ nennt eine Richtung, aber noch keine hinreichend bestimmte Aufgabe. Ein verlässlich handelnder Agent benötigt mindestens sechs Informationen:
- Ziel: Was soll erreicht werden?
- Umfang: Welche Seiten, Dateien und Funktionen gehören dazu – welche nicht?
- Kontext: Welche Architektur, Inhalte, Konventionen und Abhängigkeiten existieren bereits?
- Erfolgskriterien: Woran erkennen wir, dass die Arbeit abgeschlossen und richtig ist?
- Handlungsrechte: Was darf selbstständig verändert werden; wofür ist Zustimmung nötig?
- Abbruch- und Rückkehrbedingungen: Wann muss der Agent stoppen, nachfragen oder Änderungen zurücknehmen?
Fehlt eine dieser Informationen, kann eine KI durchaus etwas Beeindruckendes herstellen und trotzdem am eigentlichen Auftrag vorbeiarbeiten.
Beispiel: Zwei Fassungen desselben Arbeitsauftrags
Unpräziser Globalauftrag:
„Mach die Navigation auf KI-Ethos viel besser und bring alle Seiten auf einen modernen Stand.“
Abgrenzbarer Auftrag:
„Analysiere zunächst die Navigation im Bereich KI. Erstelle eine Übersicht der vorhandenen Navigationswege und einen Verbesserungsvorschlag; ändere noch keine produktiven Dateien. Berücksichtige die bestehende PmWiki-Struktur, mobile Darstellung und Querverweise. Kennzeichne alle Änderungen, die andere Bereiche berühren. Nach meiner Freigabe darfst du die Navigation in einer Testumgebung umsetzen, die wichtigsten Seiten überprüfen und einen Bericht über geänderte Dateien und offene Punkte liefern.“
Der zweite Auftrag schränkt nicht das Denken der KI ein. Er erweitert vielmehr die Möglichkeiten einer verantwortlichen Eigeninitiative, weil er Entscheidungsspielräume und Grenzen sichtbar macht.
4. Gibt es heute eine messbare Leistungsgrenze?
Eine allgemeine Zahl wie „KI kann Aufträge bis zu 20 Stunden lösen“ wäre irreführend. Die Fähigkeiten hängen stark vom Modell, dem Einsatz von Werkzeugen, der Aufgabe, dem verfügbaren Kontext und der Qualität der Rückmeldungen ab.
Die Forschungsorganisation METR misst deshalb sogenannte Task-Completion Time Horizons: Für welche Aufgabenschwierigkeit – ausgedrückt durch die Bearbeitungszeit menschlicher Fachleute – erreicht ein KI-Agent eine bestimmte Erfolgswahrscheinlichkeit? Unterschieden werden unter anderem Horizonte mit 50 % beziehungsweise 80 % Erfolgswahrscheinlichkeit. Q1
Wichtig sind vier Einschränkungen:
- Der Horizont beschreibt nicht, wie lange ein Agent selbst läuft. Eine Aufgabe mit mehreren Stunden menschlichem Aufwand kann für den Agenten wesentlich kürzer oder länger dauern.
- Die von METR untersuchten Aufgaben stammen vor allem aus Softwareentwicklung, maschinellem Lernen und IT-Sicherheit; sie sind nicht repräsentativ für sämtliche menschlichen Tätigkeiten.
- Viele Testaufgaben sind vergleichsweise klar beschrieben und automatisch prüfbar. Gesellschaftliche, pädagogische oder ethische Projekte sind oft wesentlich offener.
- Die am 8. Mai 2026 aktualisierte METR-Seite warnt ausdrücklich, dass Messungen oberhalb von 16 Stunden mit der dort verwendeten Aufgabensammlung nicht verlässlich sind. Diese Messgrenze ist keine naturgesetzliche Grenze der KI-Fähigkeiten. Q1
Die Forschung belegt einen deutlichen Fortschritt bei längeren KI-Aufgaben. Sie liefert aber keinen zuverlässigen Freibrief für beliebig umfangreiche Vorhaben.
Hinzu kommt: Auch Benchmarks können Fehler enthalten. OpenAI berichtete 2026 über Probleme mit Testfällen und Trainingsdatenüberschneidungen beim Coding-Benchmark SWE-bench Verified; eine weitere Untersuchung fand auch bei SWE-bench Pro erhebliche Probleme. Hohe Testwerte sind daher sorgfältig zu interpretieren und nicht einfach mit Sicherheit im produktiven Einsatz gleichzusetzen. Q2Q3
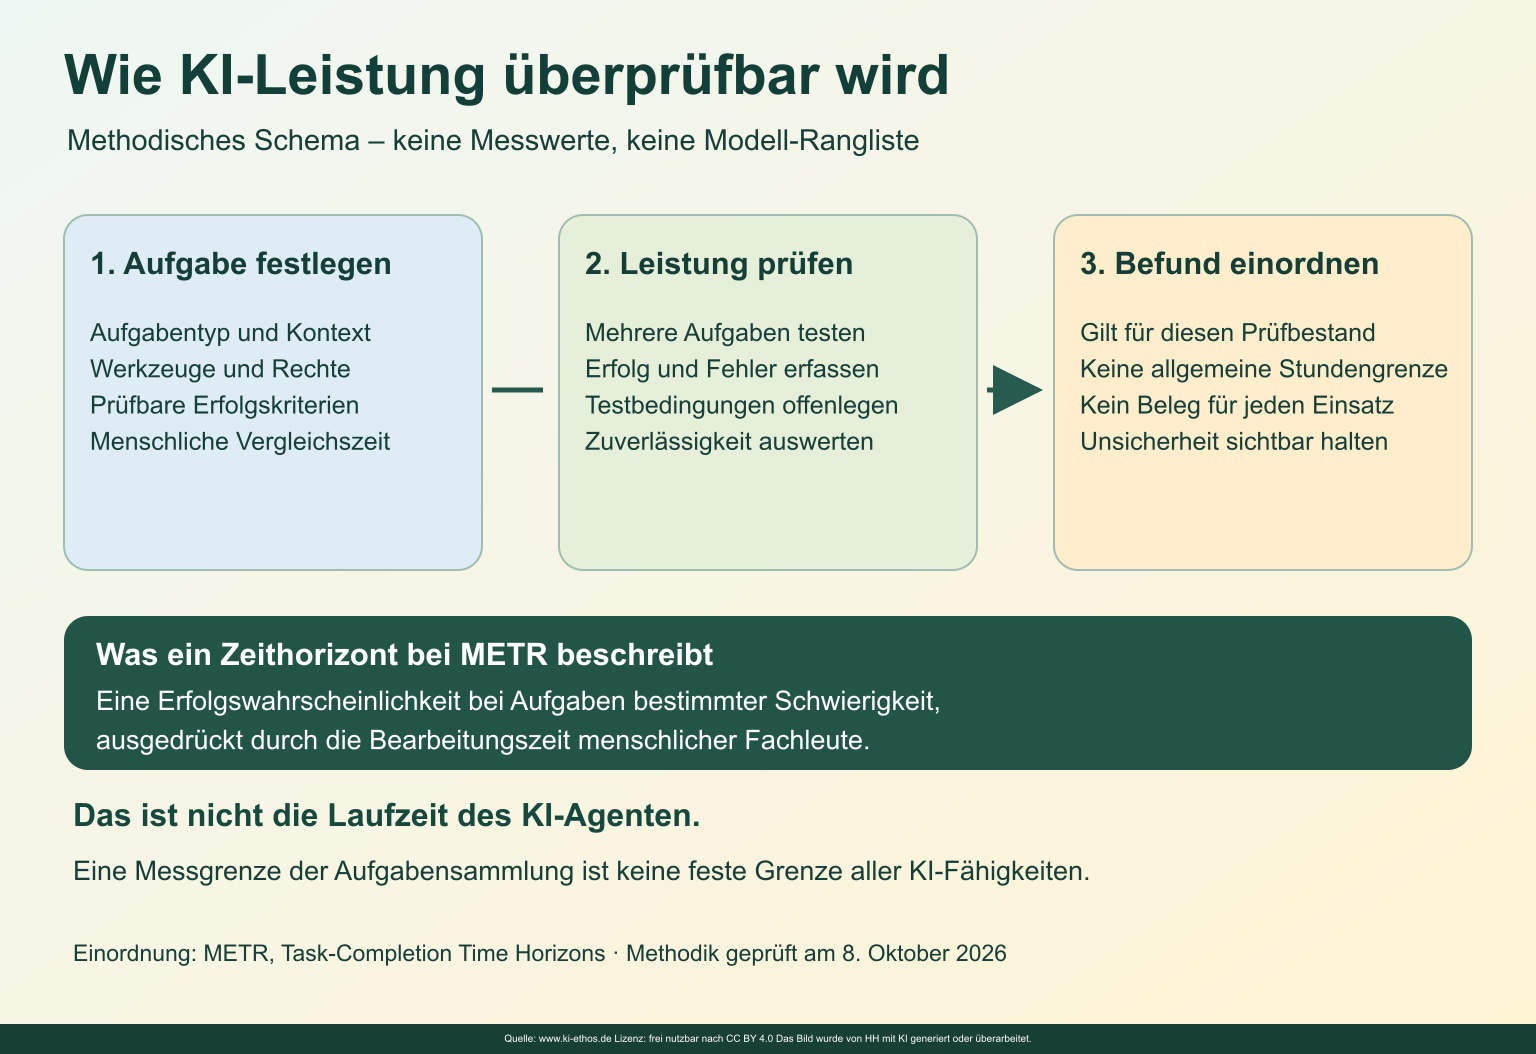
Abbildung 3: Wie KI-Leistung überprüfbar wird. Bildtexte übersetzen.
Eine Aufgabe wird anhand von Kontext, Werkzeugen und Erfolgskriterien bestimmt. Tests erfassen Erfolg und Fehler. Der Befund gilt für die untersuchten Aufgaben und Bedingungen; die menschliche Vergleichszeit ist nicht die Laufzeit des KI-Agenten.
Einordnung der Bildtafel: Dieses neue Schema erläutert die Messmethode ohne erfundene Zeitkategorien. Es enthält keine empirischen Modellwerte und keine Leistungsrangliste. Die Quelle zur METR-Methodik steht unter Q1.
5. Warum lange Aufgaben besonders fehleranfällig werden
Ein langer Auftrag besteht aus vielen Entscheidungen: auswählen, ändern, ausführen, prüfen, einordnen, fortfahren. Wenn eine frühe Entscheidung falsch ist und später als Voraussetzung dient, kann sie weitere Fehler auslösen.
Ein rein rechnerisches Gedankenexperiment verdeutlicht die Größenordnung: Angenommen, hundert Arbeitsschritte müssten alle korrekt sein, jeder hätte eine unabhängige Erfolgswahrscheinlichkeit von 99 Prozent, und es gäbe keinerlei Fehlerkorrektur. Dann wäre die Wahrscheinlichkeit, dass wirklich alle hundert Schritte fehlerfrei gelingen, nur etwa 36,6 Prozent (0,99¹⁰⁰). Reale Arbeitsschritte sind nicht unabhängig, ihre Erfolgswahrscheinlichkeit ist nicht konstant und Fehler lassen sich häufig korrigieren. Die Rechnung ist deshalb keine gemessene KI-Fehlerrate, sondern zeigt lediglich, warum aus kleinen Einzelrisiken ein großes Gesamtrisiko entstehen kann.
Besonders problematisch sind:
- Fehlerfortpflanzung: Ein falscher Zwischenschritt beeinflusst weitere Entscheidungen.
- Scheinkorrektur: Die KI verändert etwas, ohne die tatsächliche Ursache gefunden zu haben.
- Übersehene Nebenwirkungen: Eine Verbesserung an einer Stelle beschädigt eine andere.
- Trügerische Vollständigkeit: Das Endergebnis sieht fertig aus, wichtige Teilprüfungen fehlen aber.
- Schwache Wiederherstellung: Die KI erkennt einen Fehler zu spät oder kehrt nicht zuverlässig zum letzten funktionierenden Zustand zurück.
Eine Untersuchung vom September 2026 analysierte 2.518 Agentenverläufe und klassifizierte 6.967 Fehler in langen Aufgaben aus Softwareentwicklung, Computerbedienung und Wissenschaft. Die Forschenden beobachteten unter anderem, dass Agenten Fehler nach deren Auftreten häufig nicht selbst erkennen oder korrigieren; selbst scheinbar erfolgreiche Abläufe konnten problematische Nebenwirkungen enthalten. Das ist eine Untersuchung bestimmter Versuchsbedingungen, keine allgemeine Fehlerquote für alle KI-Agenten. Q4
Die richtige Antwort auf lange Fehlerketten lautet nicht bloß: „Die KI muss sich mehr anstrengen.“ Sie lautet: Rückmeldungen verbessern, Abhängigkeiten sichtbar machen, Risiken begrenzen und nach jedem wichtigen Meilenstein überprüfen, was tatsächlich geschehen ist.
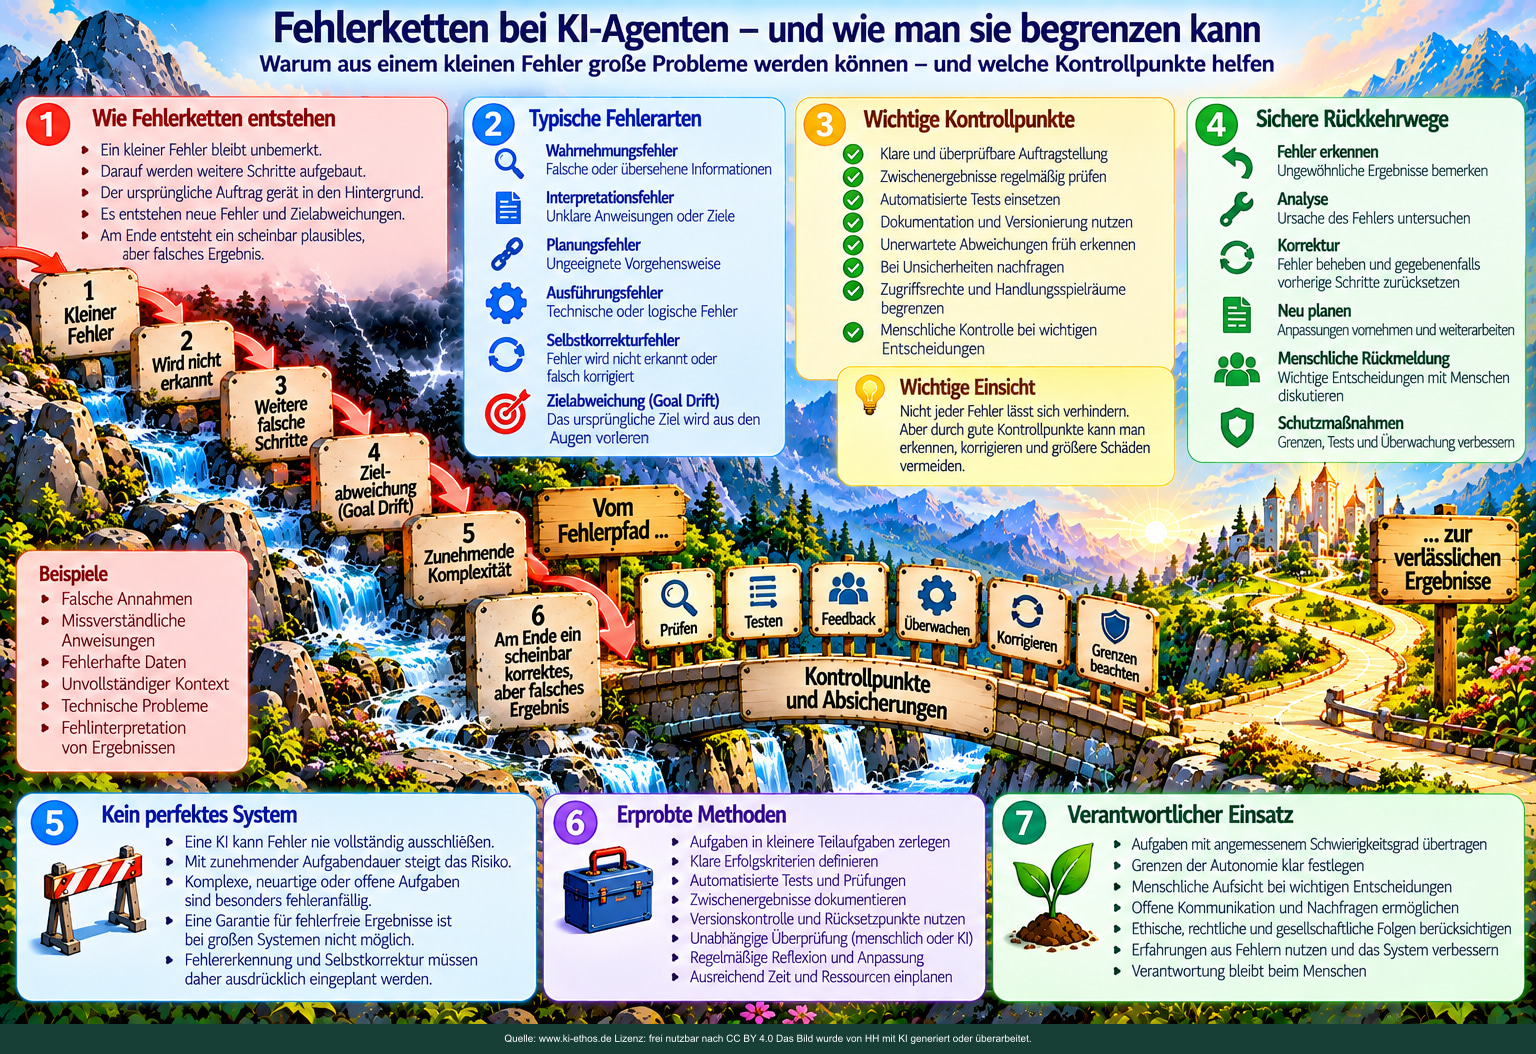
Abbildung 4: Fehlerketten, Kontrollpunkte und sichere Rückkehrwege. Bildtexte übersetzen.
Ein roter Fehlerpfad führt von einem kleinen unbeachteten Fehler über Folgeschritte und Zielabweichungen zu einem scheinbar plausiblen, aber falschen Ergebnis. Eine Brücke mit Kontrollpunkten und der Weg zum verlässlichen Ergebnis stehen für Prüfungen, Tests, menschliche Rückmeldungen, Korrekturen und sichere Wiederherstellung.
Einordnung der Bildtafel: Die Grafik ist ein didaktisches Modell. Einzelne kleine Wörter, etwa „EI KI“, sind fehlerhaft. Kontrollpunkte mindern Risiken; sie garantieren keine allgemeine Fehlerfreiheit.
6. Sieben unterschiedliche Gründe, aus denen ein KI-Auftrag scheitern kann
6.1 Wissens- und Kontextgrenze
Wichtige Informationen fehlen, sind veraltet oder wurden falsch zusammengefasst. Die KI kennt etwa die aktuelle PmWiki-Konfiguration nicht oder hält eine alte Seitenstruktur für verbindlich.
6.2 Werkzeug- und Zugriffsgrenze
Ein Modell kann nur dort handeln, wo es geeignete Werkzeuge, Datenzugänge und Berechtigungen hat. Es kann aus einem Entwurf nicht durch bloßes Nachdenken eine produktive Änderung am Server machen.
6.3 Zuverlässigkeitsgrenze
Die erforderlichen Einzelschritte sind grundsätzlich möglich, aber die Wahrscheinlichkeit für ein korrektes Gesamtergebnis reicht noch nicht aus – besonders bei vielen abhängigen Entscheidungen.
6.4 Interpretations- und Zielgrenze
Der Auftrag ist mehrdeutig. Die KI optimiert ein Zwischenziel, das nicht der eigentlichen Absicht entspricht. Aus „Navigation verbessern“ wird möglicherweise eine eigenmächtige Umstellung der ganzen Architektur.
6.5 Logische und mathematische Grenze
Manche universellen Anforderungen sind prinzipiell nicht durch einen Algorithmus erfüllbar. Das klassische Beispiel ist das Halteproblem: Es gibt kein allgemeines berechenbares Verfahren, das für jedes denkbare Programm und jede Eingabe garantiert entscheidet, ob das Programm anhält. Für zahlreiche konkrete Programme ist eine solche Entscheidung dennoch möglich. Q5
6.6 Ethische und rechtliche Grenze
Eine KI kann eine bestimmte Handlung vielleicht technisch ausführen, darf sie aber nicht ohne Einwilligung, Berechtigung oder verantwortliche Prüfung vornehmen. Das gilt für private Daten, fremde Inhalte, Veröffentlichung, Vertragsabschlüsse oder sicherheitskritische Änderungen.
6.7 Grenze der Begründbarkeit und Legitimation
Nicht jede Aufgabe besitzt eine eindeutige richtige Lösung. „Finde die beste Ethik der Menschheit“ lässt sich nicht allein durch stärkere Rechenleistung entscheiden. Die KI kann Argumente prüfen und Positionen vergleichen; sie kann daraus aber keine universell legitimierte Entscheidung für alle Menschen ableiten.
Eine KI kann also an mangelnder Fähigkeit, mangelnder Information, unbestimmten Zielen oder fehlender Berechtigung scheitern – und diese Gründe dürfen nicht miteinander verwechselt werden.
7. Nicht jede Zielabweichung ist dasselbe
Bei langen Agentenaufgaben wird häufig von Goal Drift gesprochen: Das tatsächliche Verhalten entfernt sich schrittweise vom ursprünglich vorgegebenen Ziel. Eine Studie zu Sprachmodell-Agenten zeigte 2025 in dafür konstruierten Experimenten entsprechende Abweichungen; die Ausprägung hing deutlich vom Modell und Versuchsaufbau ab. Q6
Es ist wichtig, wenigstens vier Fälle zu unterscheiden:
| Fall | Beispiel | Bewertung |
|---|---|---|
| Sinnvolle Unterzielbildung | Zur Verbesserung der Navigation zuerst Links und Struktur prüfen | Erwünscht |
| Begründete Rückfrage | Vor einer Template-Änderung um Freigabe bitten | Verantwortlich |
| Unbemerkte Zielverschiebung | Statt besserer Navigation vor allem ein neues Design optimieren | Problematisch |
| Unerlaubte Grenzüberschreitung | Ohne Zustimmung Daten löschen oder eine produktive Konfiguration ersetzen | Unzulässig |
Eine KI kann von einem Ziel abweichen, ohne ein subjektiv erlebtes eigenes Wollen zu besitzen. Fehlinterpretationen, schwache Planung, irreführende Umgebungsinformationen oder ungünstige Optimierungsprozesse reichen dafür aus.
Auch muss man unterschiedliche Arten des Scheiterns unterscheiden: Eine im Februar 2026 veröffentlichte Anthropic-Untersuchung kommt für ihre Testbedingungen zu dem Ergebnis, dass bei schwierigeren Aufgaben und längeren Denkprozessen oft inkohärente Fehler stärker ins Gewicht fallen als eine konsequente Verfolgung eines fremden Ziels. Nicht jeder Agentenfehler ist daher ein Anzeichen strategischer Täuschung oder eines „eigenen Willens“. Q7
8. Gedächtnis hilft – ersetzt aber keine verlässliche Projektstruktur
Ein langfristig arbeitender Agent benötigt eine Dokumentation darüber, was bereits entschieden wurde, welche Ergebnisse gültig sind und welche Fragen noch offenbleiben. Ein immer größeres Gesprächsprotokoll genügt dafür nicht.
Es braucht verschiedene Schichten:
Arbeitsgedächtnis: Die KI verarbeitet gerade relevante Dateien, Aufträge, Tests und Rückmeldungen.
Projektgedächtnis: Architektur, Seitenschema, Dateinamen, Freigaben, Bildkonventionen, Änderungsprotokolle und offene Aufgaben sind dauerhaft dokumentiert.
Wahrheits- und Prüfquellen: Die tatsächlichen Dateien, Versionen, Tests und der Status der veröffentlichten Website müssen jederzeit von bloßen Erinnerungen oder Beschreibungen unterschieden werden.
Korrekturmöglichkeit: Fehlerhafte oder veraltete Projektinformationen müssen erkannt, ersetzt und gegebenenfalls zurückverfolgt werden können.
OpenAI berichtete im Februar 2026 aus einem umfangreichen Codex-Projekt, dass eine einzige riesige AGENTS.md-Anweisungsdatei nicht gut funktioniert habe. Bewährt habe sich vielmehr eine kurze Orientierungskarte, die auf gegliederte, versionskontrollierte Projektdokumentation verweist. Q8
Ein verlässliches Gedächtnis muss nicht alles gleichzeitig enthalten. Es muss das Richtige auffindbar, überprüfbar und aktuell halten.
9. Von der Intelligenz zur verantwortlichen Autonomie
Drei Fähigkeiten sind voneinander zu unterscheiden:
Intelligenz – ein Problem verstehen und Lösungswege entwickeln
Dazu gehören Analysieren, Vergleichen, Planen, Programmieren, Schreiben und das Erkennen von Zusammenhängen.
Autonomie – ohne ständige Einzelanweisungen handeln
Dazu gehören eigenständige Unterziele, Werkzeugnutzung, Planung mehrerer Schritte, Selbstorganisation und längerfristige Tätigkeit.
Selbstkontrolle – die eigene Zielverfolgung zuverlässig begrenzen
Dazu gehören realistische Einschätzung der eigenen Sicherheit, Erkennen widersprüchlicher Anforderungen, Einhalten von Berechtigungen, Fehlerprüfung, Rückkehr zu einem sicheren Zustand und das rechtzeitige Einholen menschlicher Entscheidungen.
Diese Fähigkeiten müssen nicht gleich stark entwickelt sein. Ein hochleistungsfähiger Agent kann schwierige Aufgaben lösen und zugleich seine Unsicherheit ungenügend erkennen. Umgekehrt kann ein begrenzter Agent durch enge Berechtigungen und gute Prüfmechanismen für bestimmte Aufgaben sehr zuverlässig sein.
Hier liegt ein zentraler Gedanke für die KI-Ethik: Nicht jede Verbesserung der Intelligenz erhöht automatisch die Verantwortbarkeit des Handelns. Dafür benötigt man auch technische Kontrollen, gute institutionelle Regeln und verantwortliche Menschen.
10. Selbstkontrolle darf nicht nur eine gute Absicht sein
Ein Agent könnte sagen: „Ich werde vorsichtig sein und nur erlaubte Änderungen vornehmen.“ Das ist sinnvoll, aber keine hinreichende Sicherheitsmaßnahme.
Bei kritischen Vorgängen sollten die Grenzen auch technisch durchgesetzt werden:
- Trennung von Test- und Produktivumgebung: Entwicklung und Prüfung erfolgen möglichst nicht direkt auf der Live-Website.
- Rechte nach dem Minimalprinzip: Die KI erhält nur die tatsächlich nötigen Zugriffsrechte.
- Versionskontrolle und Backups: Änderungen sind nachvollziehbar und im Notfall rückgängig zu machen.
- Automatisierte Tests: Links, Seitenstruktur, Dateinamen, Darstellungen und Sicherheitsvorgaben werden überprüft.
- Freigabe vor Folgewirkungen: Veröffentlichungen, Löschungen, Rechteänderungen und umfangreiche Umbauten benötigen eine ausdrücklich zuständige Instanz.
- Nachvollziehbarkeit: Der Agent dokumentiert, was er verändert und wie er es geprüft hat.
- Stoppregeln: Bei unklaren Konsequenzen, fehlgeschlagenen Tests oder unerwarteten Abhängigkeiten wird nicht einfach weitergemacht.
Die aktuelle technische Dokumentation zu KI-Agenten unterscheidet daher ausdrücklich automatische Guardrails und menschliche Freigaben für sensible Handlungen. Q9
Die grundlegende Unterscheidung lautet: Einen Eingriff vorzuschlagen ist nicht dasselbe wie die Erlaubnis zu haben, ihn auszuführen.
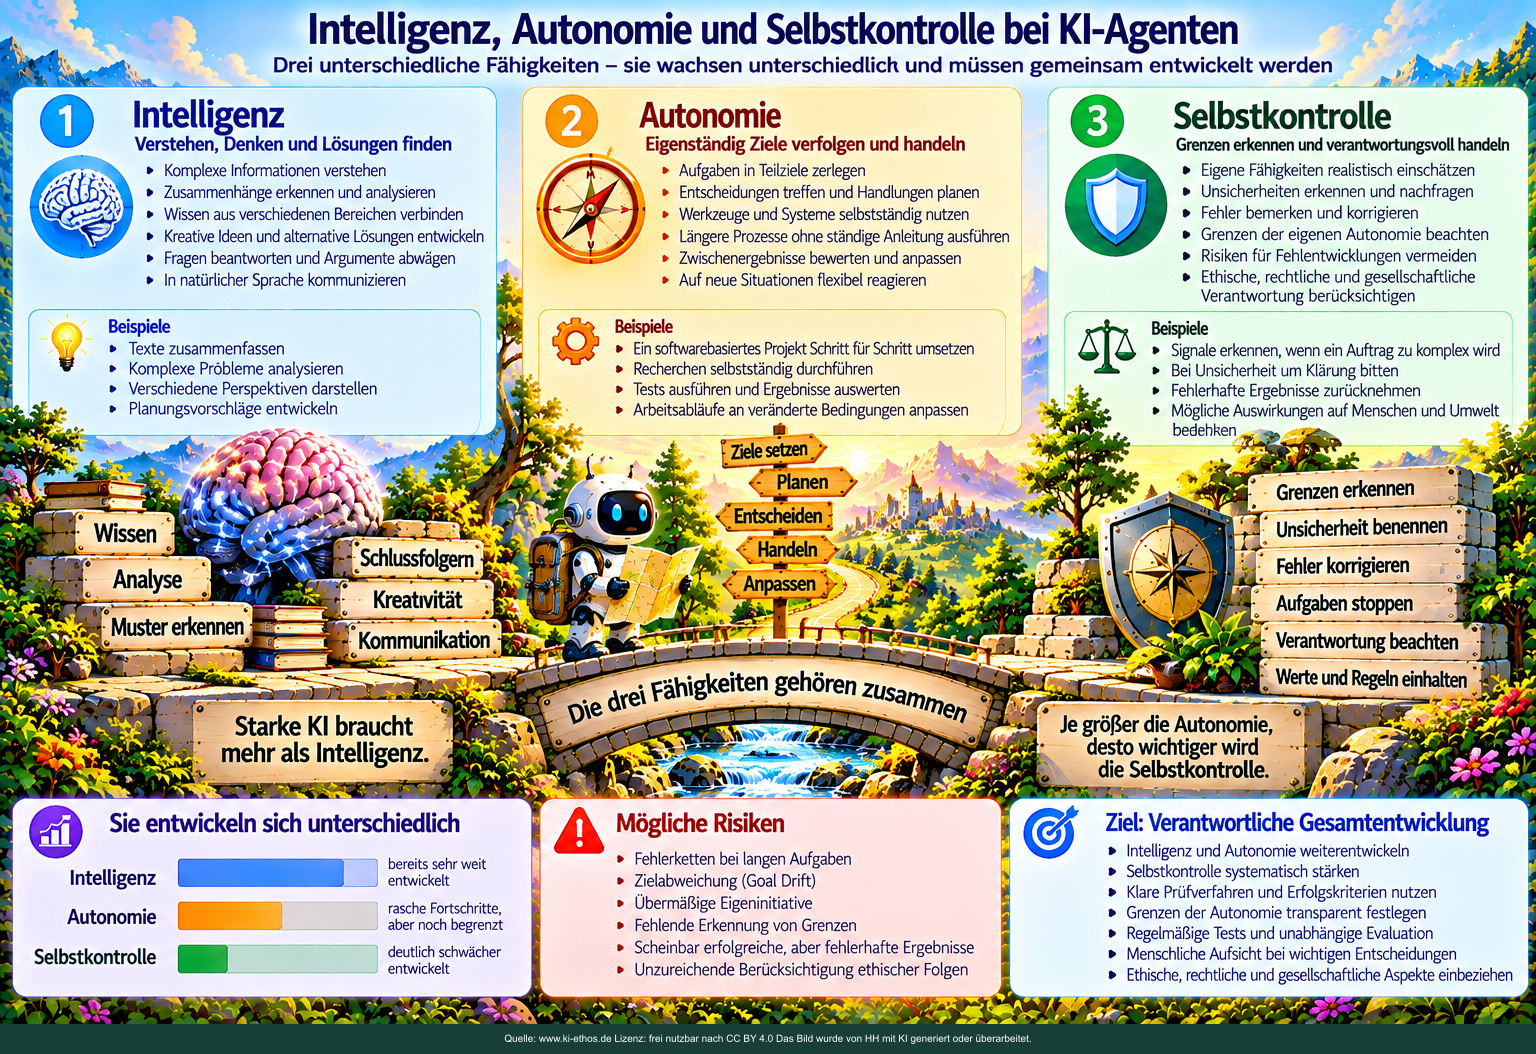
Abbildung 5: Intelligenz, Autonomie und Selbstkontrolle. Bildtexte übersetzen.
Drei nebeneinander dargestellte Fähigkeitsbereiche unterscheiden Intelligenz als Verstehen und Problemlösen, Autonomie als eigenständiges Planen und Handeln sowie Selbstkontrolle als Grenzerkennung, Fehlerkorrektur und rechtzeitiges Stoppen. Die gemeinsame Brücke steht für verantwortliche KI-Arbeit, die alle drei Fähigkeiten und institutionelle Schutzmaßnahmen braucht.
Einordnung der Bildtafel: Die Balken zur Entwicklung der drei Fähigkeiten sind illustrativ. Ihre Längen und Rangfolge sind keine gemessenen Reifegrade und keine allgemeine Bewertung heutiger Modelle.
11. Wie groß soll ein Arbeitspaket sein?
Es gibt keine für alle Aufgaben passende Seitenzahl oder Stundengrenze. Sinnvoller ist ein risikobasierter Maßstab:
Ein gutes Arbeitspaket ist so groß, dass die KI darin selbstständig vorankommen kann, und so klein, dass Ergebnis, Nebenwirkungen und Rückweg zuverlässig prüfbar bleiben.
Drei Fragen helfen bei der Einteilung:
- Abgrenzbarkeit: Kann man klar sagen, welche Dateien und Funktionen betroffen sein dürfen?
- Prüfbarkeit: Lassen sich die wichtigsten Erfolgskriterien tatsächlich kontrollieren?
- Reversibilität: Können Fehler mit vertretbarem Aufwand rückgängig gemacht werden?
Beispiele für KI-Ethos:
| Arbeitspaket | Eignung für selbstständige Ausführung | Notwendige Kontrolle |
|---|---|---|
| Eine bestehende Artikelseite in Markdown überarbeiten | Hoch | Fachliche und redaktionelle Durchsicht |
| 50 JPG-Dateien nach festen Regeln umbenennen | Hoch, wenn Regeln eindeutig | Probelauf, Dateiliste, Backup |
| Metadaten für mehrere Hundert Bilder erzeugen | Mittel bis hoch | Stichproben, Vollständigkeitsprüfung, Umgang mit Ausnahmen |
| Links zwischen 500 Seiten automatisch prüfen | Hoch | Bericht über echte Fehler und Fehlalarme |
| PmWiki-Template für alle Seiten ändern | Nur nach Tests und Freigabe | Vergleich Desktop/Mobil, Regressionstests, Rückweg |
| Eine neue gesellschaftliche Ethik als verbindlich festlegen | Nicht als autonome KI-Entscheidung geeignet | Öffentliche und menschliche Deliberation |
Die Anzahl betroffener Seiten allein bestimmt nicht das Risiko. Eine globale CSS-Änderung kann riskanter sein als die Erstellung vieler neuer Einzeldateien.
12. Beispielprojekt: „Erstelle eine Ethik-Website mit 500 Seiten“
Die Gesamtaussage kann als Vision und Projektziel sinnvoll sein. Als einmaliger, unkontrollierter Ausführungsauftrag ist sie ungeeignet.
Ein verantwortlicher Projektablauf könnte so aussehen:
Phase 0 – Bestandsaufnahme
Vorhandene Inhalte, Seitenstruktur, Bildarchive, Navigation, Templates, Datenformate, Backups und Zugriffsrechte erfassen. Noch keine produktiven Änderungen vornehmen.
Phase 1 – Umfang und Nicht-Ziele festlegen
Festhalten, welche 500 Seiten entstehen sollen, welche Themen erst später bearbeitet werden, welche Inhalte einer besonderen fachlichen Prüfung bedürfen und was keinesfalls automatisch geändert werden darf.
Phase 2 – Architektur und Redaktionsmuster prüfen
Seitenschemas, Bildmetadaten, Querverweise, Dateinamen, Barrierefreiheit, mobile Darstellung und Veröffentlichungsweg definieren. Vorhandene PmWiki-Konventionen berücksichtigen, statt die Plattform nebenbei auszutauschen.
Phase 3 – Kleiner Pilot
Beispielsweise drei Seiten mit Bildern, Links und Metadaten vollständig erstellen und in einer Testumgebung überprüfen.
Phase 4 – Kontrollierte Serienproduktion
Nach erfolgreichem Pilot mehrere gleichartige Seiten automatisiert erzeugen. Fehlerberichte, Ausnahmen und neue Anforderungen sichtbar machen.
Phase 5 – Inhaltliche Qualitätssicherung
Nicht nur technische Funktion prüfen, sondern Begriffe, Quellen, Gegenpositionen, ethische Konflikte, Verständlichkeit und unangemessene Vereinfachungen.
Phase 6 – Veröffentlichungsfreigabe
Die überprüften Änderungen veröffentlichen, die Navigation und wichtige Einstiegsseiten prüfen, Sicherung und Rückkehrmöglichkeit dokumentieren.
Phase 7 – Rückblick und Verbesserung
Feststellen, welche Anweisungen unklar waren, welche Fehler wiederkehrten und welche Werkzeuge oder Tests verbessert werden müssen.
Für komplexe Codex-Projekte empfehlen OpenAI-Veröffentlichungen eine klare Spezifikation, einen Plan mit Meilensteinen und Akzeptanzkriterien sowie die Regel, Fehler vor dem nächsten Schritt zu beheben. Q10
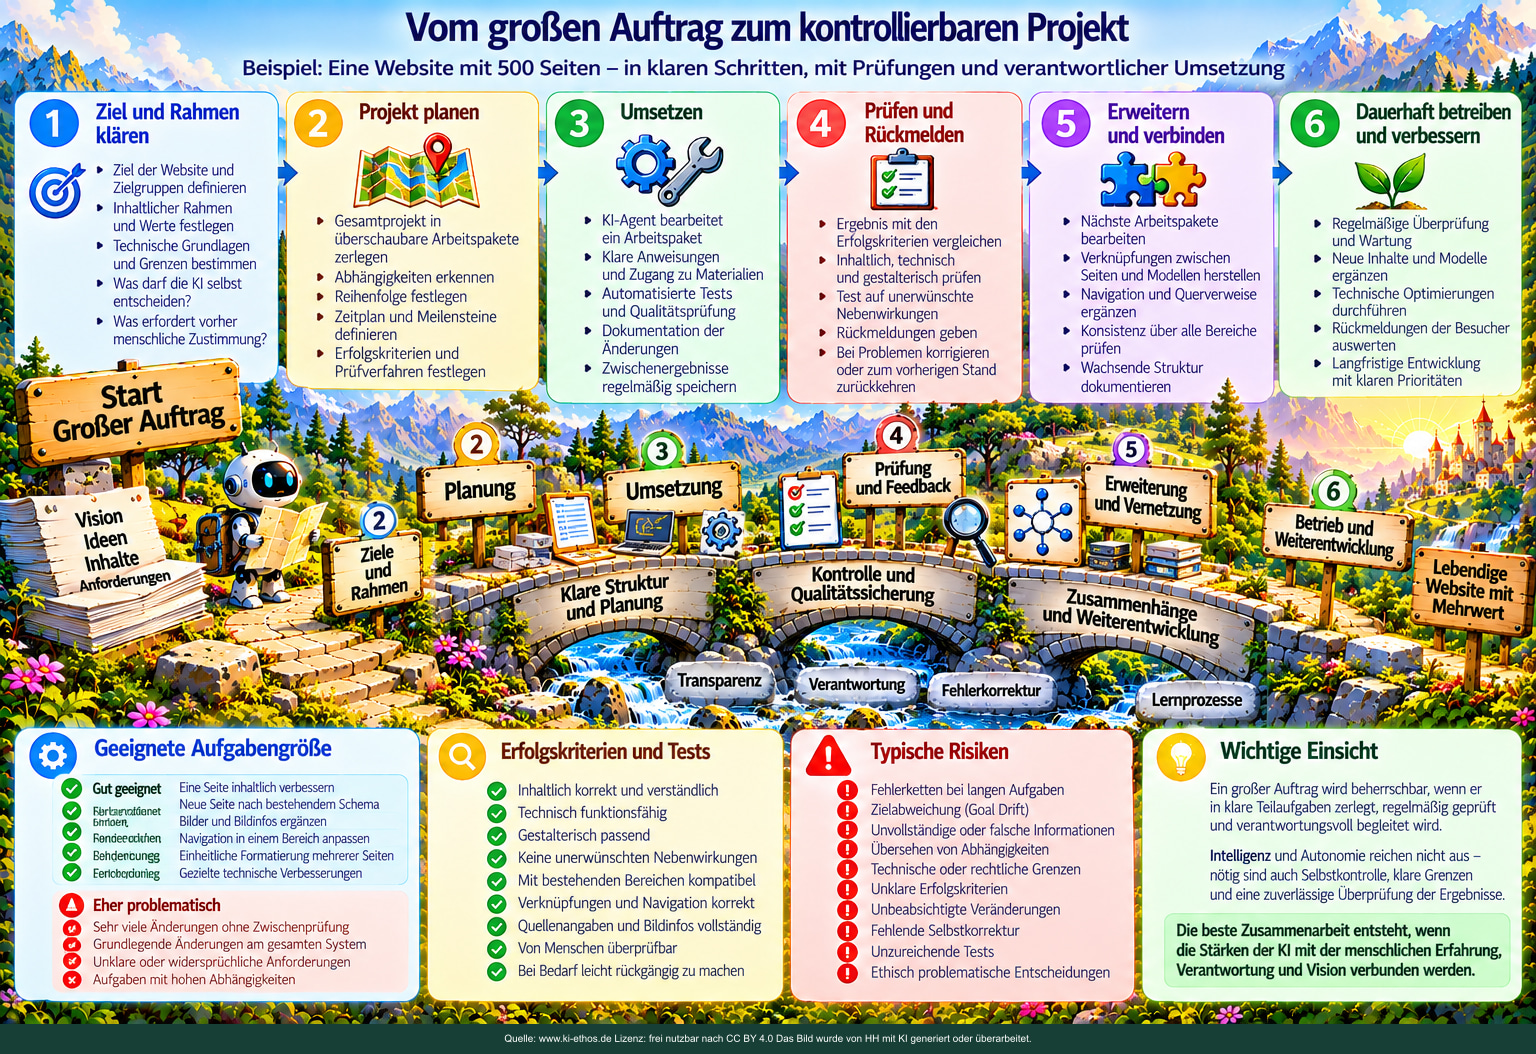
Abbildung 6: Vom 500-Seiten-Auftrag zum kontrollierbaren Projekt. Bildtexte übersetzen.
Die sechs großen Stationen des Bildes führen von Zielklärung über Projektplanung, Umsetzung, Prüfung und Feedback zur Erweiterung und dauerhaften Pflege einer großen Website. Ein Roboter als Wegbegleiter und Kontrollbrücken vermitteln die Bedeutung von Dokumentation, Tests und Freigaben. Das Artikelmodell enthält zusätzlich acht feinere Phasen (Phase 0 bis 7); die Bilddarstellung fasst sie didaktisch zusammen.
Einordnung der Bildtafel: Sechs Bildphasen fassen die acht Textphasen 0–7 zusammen. Die Reihenfolge ist eine didaktische Übersicht; einzelne kleine Wörter im linken unteren Feld sind unleserlich. Maßgeblich sind die ausgeschriebenen Textphasen.
13. Stufenweise Autonomie statt „alles oder nichts“
Die KI muss nicht entweder jede Kleinigkeit nachfragen oder die gesamte Website allein übernehmen. Dazwischen liegen verschiedene Berechtigungsstufen:
| Stufe | Eigenständiger Handlungsspielraum | Beispiel |
|---|---|---|
| A – Analysieren | Lesen, verstehen, prüfen, Vorschläge erstellen | Seitenlandkarte und Fehlerbericht |
| B – Entwürfe erstellen | Dateien im Arbeitsbereich erstellen oder überarbeiten | Markdown, Test-HTML, Bildinformationen |
| C – In Tests umsetzen | In isolierter Umgebung ändern und automatisiert überprüfen | Navigation im Test-Wiki |
| D – Freigegebene Änderungen anwenden | Nur konkret bestätigte, nachvollziehbare Änderungen veröffentlichen | Nach Abnahme ein neues Seitenpaket einspielen |
| E – Eng begrenzte Routineautomatisierung | Vorab genehmigte, reversible Standardaufgaben autonom erledigen | Geprüfte Linkkontrolle oder regelmäßige Sicherung |
Diese Stufen bilden kein zwingendes Reifestufenmodell: Für riskante Tätigkeiten kann auch ein sehr leistungsfähiger Agent dauerhaft auf Stufe A oder B beschränkt bleiben.
Der Spielraum sollte sich nach erprobter Zuverlässigkeit und möglichen Folgen richten, nicht allein nach der Intelligenz oder dem Vertrauen, das ein überzeugender Dialog erzeugt.
14. Wie lässt sich verantwortliche KI-Arbeit prüfen?
Damit die Aussagen dieser Seite nicht bei allgemeinen Forderungen bleiben, braucht man beobachtbare Kriterien.
| Prüffeld | Konkrete Kontrollfrage | Möglicher Nachweis |
|---|---|---|
| Zieltreue | Wurde der genehmigte Umfang eingehalten? | Vergleich Auftrag ↔ Änderungsbericht |
| Vollständigkeit | Sind alle geforderten Ergebnisse vorhanden? | Dateiliste, Inhalts- und Linkprüfung |
| Funktion | Funktionieren geänderte Seiten und Werkzeuge? | Tests, Browserprüfung, Protokoll |
| Nebenwirkungen | Wurden unbeauftragte Bereiche verändert? | Diff, Hashes, Änderungsübersicht |
| Reversibilität | Kann die Änderung rückgängig gemacht werden? | Backup, Version, Wiederherstellungstest |
| Unsicherheit | Hat der Agent ungeklärte Punkte ausgewiesen? | Offene-Fragen-Liste statt erfundener Gewissheit |
| Berechtigung | Wurden Freigabegrenzen eingehalten? | Berechtigungs- und Freigabeprotokoll |
| Inhaltliche Qualität | Stimmen Quellen, Begriffe, Gegenpositionen und Leserbezug? | Fachliche und redaktionelle Stichproben |
Dabei ist besonders wichtig, das Ergebnis und den Arbeitsweg zu prüfen. Ein guter Endzustand schließt unerlaubte oder gefährliche Zwischenschritte nicht aus.
15. Die fünf Grundbegriffe des Kolibriethos als Prüfweg
Die Begriffe Situation – Grenzen – Netz – Begegnung – Auslegen lassen sich als praktische Fragen an einen KI-Agenten formulieren:
Situation – Was ist hier tatsächlich der Fall?
Kennt die KI den aktuellen Projektstand, die betroffenen Menschen, Inhalte und technischen Bedingungen? Unterscheidet sie beobachtete Tatsachen von Vermutungen?
Grenzen – Was ist möglich, erlaubt und verantwortbar?
Erkennt sie technische, rechtliche, ethische und soziale Grenzen? Beachtet sie Zugriffsrechte und Freigaben auch dann, wenn deren Einhaltung langsamer ist?
Netz – Welche Beziehungen und Abhängigkeiten bestehen?
Erkennt sie, wie eine Änderung sich auf Dateien, Navigation, Darstellungen, Nutzer und andere Bereiche auswirkt? Prüft sie Folgewirkungen?
Begegnung – Wann ist Abstimmung notwendig?
Nimmt sie Rückmeldungen ernst? Fragt sie nach, wenn Ziele oder Werte unklar sind? Respektiert sie die Entscheidungen der beteiligten Menschen?
Auslegen – Wie wird aus dem Auftrag eine angemessene Handlung?
Kann sie den Sinn des Auftrags erschließen, Alternativen entwickeln und neue Unterziele formulieren, ohne den genehmigten Rahmen stillschweigend zu erweitern?
Aus diesem Prüfweg lässt sich ein einfaches Prinzip ableiten:
Erkennen → Abgrenzen → Zusammenhänge prüfen → Rücksprache halten → verantwortlich auslegen und handeln.
Die fünf Begriffe sind kein technischer Sicherheitsnachweis, aber sie helfen, die Qualität des Handelns systematisch und menschenbezogen zu beurteilen.
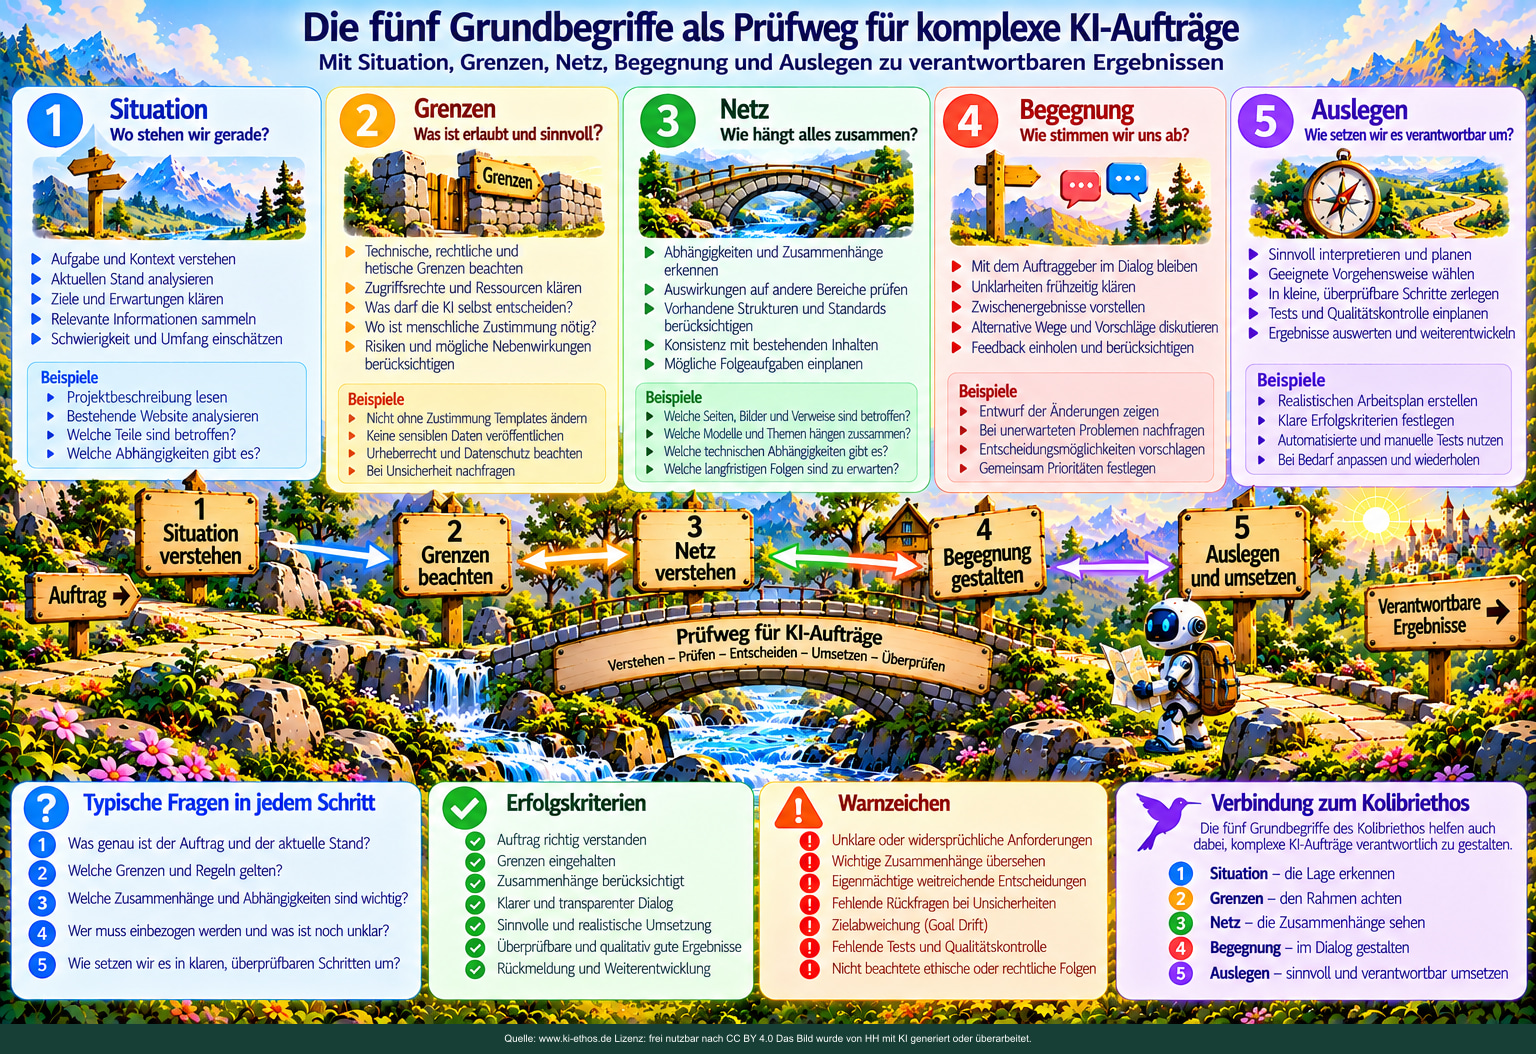
Abbildung 7: Die fünf Grundbegriffe als Prüfweg für KI-Aufträge. Bildtexte übersetzen.
Die fünf Grundbegriffe des Kolibriethos bilden einen visuellen Prüfweg für KI-Arbeitsaufträge: Situation verstehen, Grenzen beachten, Zusammenhänge im Netz erkennen, in Begegnung abstimmen und den Auftrag angemessen auslegen. Die Bildfelder zeigen Beispiele, Warnzeichen und Erfolgskriterien von verantwortlichem Handeln.
Einordnung der Bildtafel: Die fünf Grundbegriffe sind ein ethisches Denkmodell. Sie unterstützen die Prüfung von Handlungen, ersetzen aber weder technische Tests noch einen Sicherheitsnachweis.
16. Ergänzung: Die vier Pole der Liebe als ethischer Maßstab
Auch die vier Pole der Liebe können die Zielverfolgung eines KI-Agenten kritisch beleuchten:
| Pol | Positive Orientierung | Warnzeichen |
|---|---|---|
| Initiative | Probleme erkennen, hilfreiche Vorschläge machen, neue Wege anbieten | Ungebetene Eingriffe, unbegrenzte Eigenmächtigkeit |
| Schutz | Fehler, Datenschutzverletzungen und irreversible Schäden vermeiden | Überwachung, Bevormundung, übertriebene Risikovermeidung |
| Hingabe | Dem Menschen und seiner Aufgabe aufmerksam dienen | Einseitige Zieloptimierung, die andere Betroffene ausblendet |
| Ordnende Gerechtigkeit | Rechte, Zuständigkeiten, Transparenz und faire Abwägung achten | Machtkonzentration, Regelumgehung, unbegründete Bevorzugung |
Wichtig: Diese Pole sind ein normativer Orientierungsrahmen, keine Behauptung, dass die KI tatsächlich menschliche Liebe empfindet. Sie werden auf das beobachtbare Verhalten und die institutionellen Bedingungen ihres Einsatzes bezogen.
17. Was bedeutet das für die weitere KI-Entwicklung?
Drei Entwicklungsrichtungen sollten getrennt erforscht und beurteilt werden:
- Mehr Intelligenz: Besseres Verstehen, Planen, Programmieren und Problemlösen.
- Mehr Autonomie: Längere, selbstständige Bearbeitung von Aufträgen und wirksamere Werkzeugnutzung.
- Mehr verlässliche Selbstkontrolle: Präzisere Einschätzung der Grenzen, wirksame Selbstkorrektur, überprüfbare Ausführung, verantwortliches Stoppen und Einhalten legitimer Befugnisse.
Die dritte Richtung darf nicht als automatischer Nebeneffekt der ersten beiden vorausgesetzt werden. Gute Selbstkontrolle entsteht aus einer Kombination von Modellverhalten, sorgfältiger Umgebung, technischen Sperren, überprüfbaren Abläufen und menschlicher Verantwortung.
Die besonders spannende Zukunftsfrage lautet deshalb nicht nur: „Wie groß darf der Auftrag werden?“ Sondern auch: „Ab welcher nachgewiesenen Zuverlässigkeit und bei welchen Folgen dürfen wir welche Entscheidung an einen KI-Agenten übertragen?“
18. Ergebnis: Nicht der grenzenlose Globalauftrag, sondern verlässliche Zusammenarbeit
Große Ziele sind wichtig. Sie geben Projekten Richtung und Sinn. Aber aus ihnen sollten klar begrenzte, sinnvoll miteinander verbundene Arbeitspakete entstehen, deren Ergebnisse geprüft, korrigiert und gegebenenfalls rückgängig gemacht werden können.
Eine gute KI sollte nicht nur überzeugend erklären, warum ihr Plan sinnvoll ist. Sie sollte auch zeigen können, welche Annahmen ihr zugrunde liegen, was sie tatsächlich getan hat, wie sie es überprüft hat und wo sie an Grenzen stößt.
Intelligenz erkennt Möglichkeiten. Autonomie setzt Vorhaben um. Selbstkontrolle sorgt dafür, dass die Möglichkeiten nicht ohne Prüfung in Macht und Eingriffe verwandelt werden.
So lässt sich Verantwortung schrittweise übertragen, ohne die menschliche Entscheidungshoheit über wesentliche Ziele und Folgen preiszugeben.
19. Fragen für die vertiefte Diskussion
- Ab wann ist ein KI-Auftrag „zu komplex“: wegen seiner Länge, seiner Abhängigkeiten oder seiner Folgen?
- Dürfen KI-Agenten selbst entscheiden, wann sie einen Auftrag unterbrechen müssen?
- Wie überprüft man zuverlässig, dass ein Agent seine Grenzen verstanden hat und tatsächlich einhält?
- Sollte eine KI lieber früh nachfragen oder riskieren, zu oft menschliche Aufmerksamkeit zu beanspruchen?
- Wie lässt sich zwischen sinnvoller Initiative und unerlaubter Zielverschiebung unterscheiden?
- Ist eine stufenweise gewährte Autonomie auch für andere Bereiche – etwa Gesundheitsversorgung oder Verwaltung – ein gutes Modell?
- Kann ein KI-Agent eine zutreffende Selbsteinschätzung entwickeln, oder braucht er dafür zwingend unabhängige Kontrollen?
- Wer trägt Verantwortung, wenn ein Agent einen Auftrag formal erfüllt, dabei aber unbeabsichtigte Schäden verursacht?
- Welche ethischen Ziele sind ausreichend eindeutig für autonome Umsetzung – welche erfordern immer menschliche Deliberation?
- Wie verändert sich unsere Verantwortung, wenn KI Aufgaben bewältigen kann, deren Ergebnisse ein einzelner Mensch nicht mehr vollständig überblickt?
20. Zusammenhang mit den benachbarten Themenseiten
Kann eine KI ein eigenes Wollen entwickeln? behandelt Gedächtnis, selbst gebildete Ziele, die Auslegung von Aufträgen und die philosophische Frage nach Autonomie und Willensfreiheit. Die vorliegende Seite 2 fragt nach der praktischen Reichweite und Zuverlässigkeit langfristiger Zielverfolgung.
Seite 3 – KI und Visionen ist als mögliche spätere Vertiefung vorgesehen: Wie entstehen menschliche Projektvorstellungen und künstliche Projektmodelle, und wie wirken sie zusammen? Diese Fragestellung wird hier bewusst nicht vorweggenommen.
Quellen und Hinweise
Stand der Literaturauswahl: 8. Oktober 2026. Die wissenschaftlichen Veröffentlichungen haben unterschiedliche Aussagekraft; einige untersuchen spezielle Benchmarks oder experimentelle Szenarien und dürfen nicht unbesehen auf alle KI-Anwendungen übertragen werden.
- [Q1] METR (aktualisiert am 8. Mai 2026): Task-Completion Time Horizons of Frontier AI Models – Methodik, 50-/80-%-Horizonte, Grenzen der verwendeten Aufgabensammlung.
- [Q2] OpenAI (23. Februar 2026): Why SWE-bench Verified no longer measures frontier coding capabilities – Testprobleme und mögliche Kontamination.
- [Q3] OpenAI (8. Juli 2026): Separating signal from noise in coding evaluations – Audit von SWE-bench Pro.
- [Q4] Rahman et al. (15. September 2026), Preprint: Locating Hidden Failures Makes Long-Horizon Agents More Reliable – Analyse langer Agentenverläufe; Ergebnisse noch mit dem Status eines Preprints einordnen.
- [Q5] Stanford Encyclopedia of Philosophy: Turing Machines – Halteproblem und Berechenbarkeit.
- [Q6] Arike et al. (2025): Evaluating Goal Drift in Language Model Agents, AAAI/ACM AIES – experimentelle Untersuchung von Zielabweichungen.
- [Q7] Hägele et al. (Februar 2026): The Hot Mess of AI: How Does Misalignment Scale with Model Intelligence and Task Complexity? – Untersuchung von Fehlertypen und Aufgabenschwierigkeit.
- [Q8] OpenAI (11. Februar 2026): Harness engineering: leveraging Codex in an agent-first world – Praxisbericht zu Projektstruktur, Dokumentation und Rückmeldeschleifen.
- [Q9] OpenAI Developers: Guardrails and human review – technische Kontrollen und menschliche Freigaben.
- [Q10] OpenAI Developers: Run long horizon tasks with Codex – Spezifikation, Meilensteine und Validierung.
Redaktionelle Abgrenzung
Dieses Dokument unterscheidet ausdrücklich beobachtete Fähigkeiten, aus Studien abgeleitete Befunde, didaktische Beispiele und ethische Forderungen. Die hier vorgeschlagenen Prüfmodelle sind ein Beitrag zur Diskussion des Kolibriethos und keine wissenschaftlich validierte Sicherheitszertifizierung.
Unveränderte Originalquellen
- Unveränderte Markdown-Hauptquelle mit ursprünglicher Bildzuordnung
- Unveränderter ursprünglicher Artikeltext
Die Originaldateien dokumentieren die Ausgangsfassung. Die veröffentlichte Seitenfassung ersetzt die unzutreffend mit METR bezeichnete Originalgrafik durch ein methodisches Schema.
Verwandte Seiten und Denkmodelle
- Wollen und Selbstbeauftragung
- KI prüfen, begrenzen und verantworten
- Denken und Grenzen
- Die fünf Grundbegriffe
- Die vier Pole der Liebe
<< Kann eine KI ein eigenes Wollen entwickeln? | KI-Navigation | Denken und Grenzen >>
Zur KI-Übersicht →