Wenn Vorhersagen nicht genügt – Wie KI das richtige Denk- und Arbeitsverfahren finden muss
KI-Navigation | Wenn Vorhersagen nicht genügt
Wie erkennt eine Sprach-KI, wann sie erklären, rechnen, recherchieren oder ein Ergebnis offenlassen sollte? Der Artikel unterscheidet sieben Erkenntniswege und schlägt einen Arbeitsprozess mit acht Schritten vor.
1. Eine grundlegende Frage: Was soll eine KI eigentlich tun?
Wer eine KI um Hilfe bittet, kann sehr unterschiedliche Aufgaben meinen: einen Text verstehen, ein mathematisches Problem lösen, eine Behauptung überprüfen, eine Ursache ermitteln, eine Entscheidung vorbereiten oder ein schwieriges zwischenmenschliches Gespräch beurteilen. Alle diese Aufgaben können sprachlich gestellt werden. Sie verlangen aber nicht dieselbe Methode.
Eine Sprach-KI kann auf jede dieser Fragen eine flüssige Antwort formulieren. Genau darin liegt eine Gefahr: Eine überzeugend klingende Antwort beweist noch nicht, dass das System die richtige Arbeitsweise gewählt hat.
Wir müssen daher vier Leistungen unterscheiden:
- Aufgabenverständnis: Was wird gefragt – eine Tatsache, eine Berechnung, eine Erklärung, eine Prognose, ein Werturteil oder eine Handlung?
- Methodenwahl: Welcher Erkenntnisweg passt: Schlussfolgern, Rechnen, Recherchieren, Experimentieren, Modellieren, Dialog oder bewusstes Offenlassen?
- Durchführung: Kann die KI den gewählten Weg korrekt, vollständig und effizient ausführen?
- Selbstkontrolle: Erkennt sie Fehler, Unsicherheit, fehlende Daten und den Punkt, an dem eine andere Methode oder menschliche Entscheidung nötig wird?
Die zweite und vierte Leistung nennen wir hier Methodenkompetenz und Erkenntnisverantwortung. Diese Begriffe dienen als Vorschlag für das KI-Ethos, nicht als etablierte technische Norm.
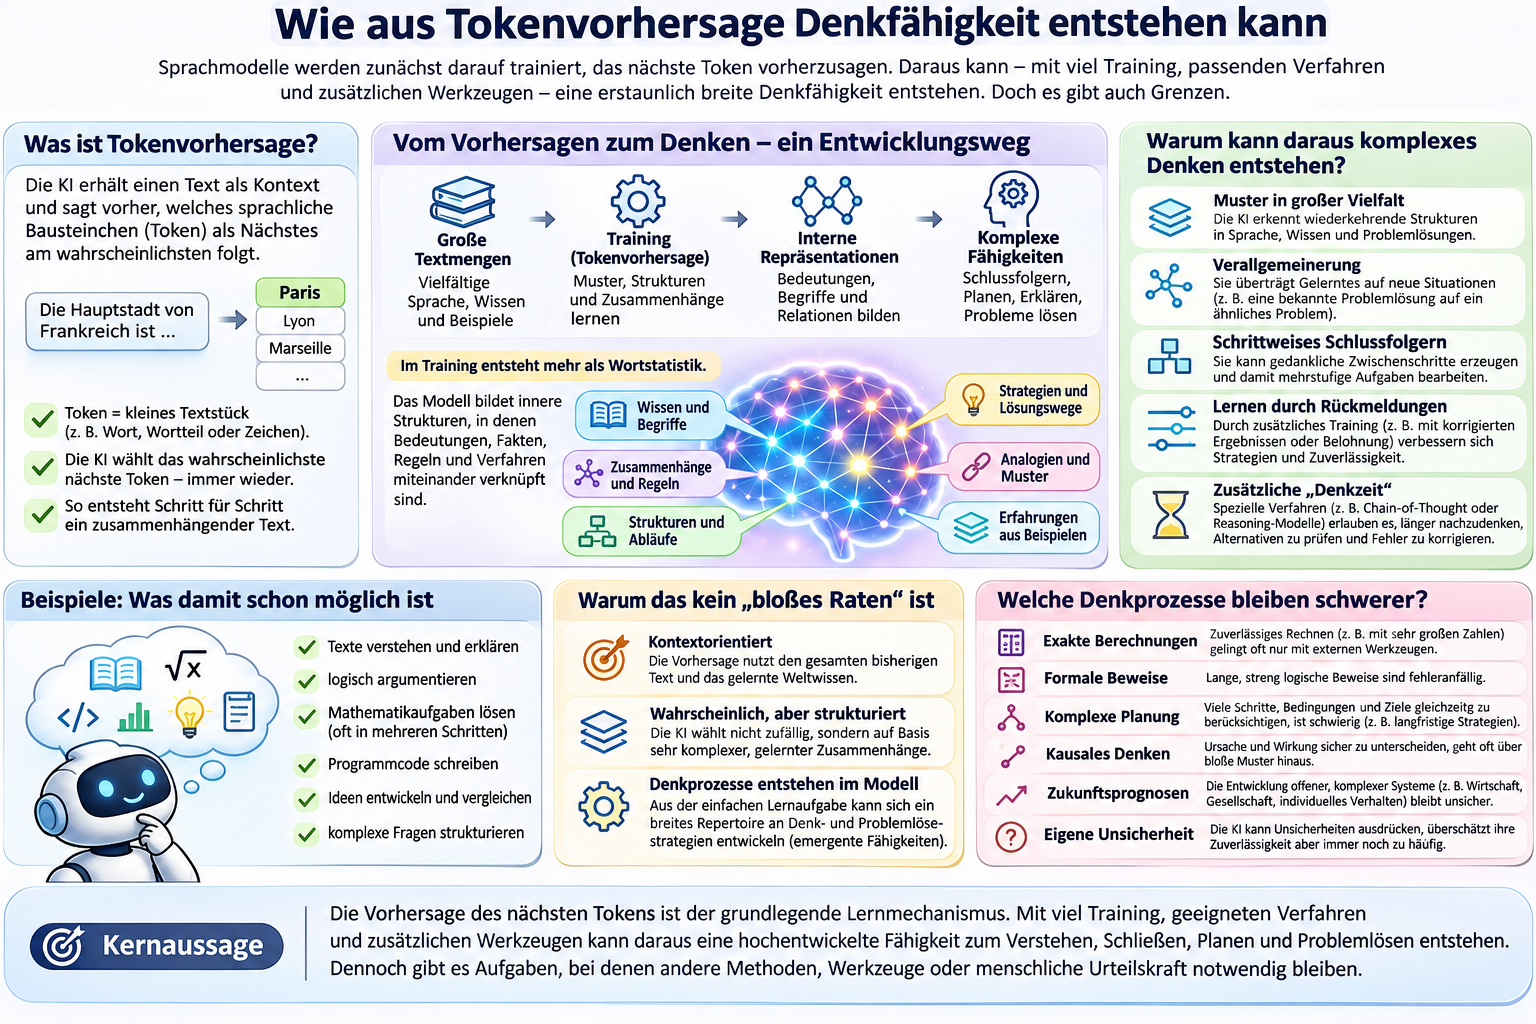
Wie aus Tokenvorhersage Denkfähigkeit entstehen kann Bildbeschreibung
Die Tafel zeigt die Auswahl des wahrscheinlichsten nächsten Tokens. Das ist Greedy-Decoding. Andere Verfahren können aus der Wahrscheinlichkeitsverteilung ziehen. Das Gehirnmotiv steht für gelernte Repräsentationen. Ob ein Modell in einer bestimmten Aufgabe ein brauchbares Abbild seiner Umwelt bildet, muss gesondert geprüft werden.
Bildbeschreibung. Das Textstrukturbild zeigt das Trainingsziel der nächsten Tokenvorhersage, das Erlernen von Zusammenhängen und möglichen inneren Zustandsmodellen sowie Fähigkeiten wie Schlussfolgern, Planen und Fehlerkorrektur. Es unterscheidet Leistungsfähigkeit von garantierter Richtigkeit und nennt Schwierigkeiten bei exaktem Rechnen, formalen Beweisen, komplexer Planung, Kausalität, Prognosen und Selbsteinschätzung.
2. Was bedeutet „Vorhersage des nächsten Tokens“?
Viele heutige große Sprachmodelle (Large Language Models, LLMs) werden in ihrer Grundausbildung darauf trainiert, aus dem verfügbaren Kontext eine Wahrscheinlichkeitsverteilung für das nächste Token zu bestimmen. Ein Token kann ein Wort, ein Wortteil, eine Zahl, ein Satzzeichen oder ein anderes Textstück sein. Vereinfacht lautet die Aufgabe:
P(nächstes Token | bisheriger Kontext)
Steht im Text „Die Hauptstadt Frankreichs ist …“, erhält „Paris“ eine hohe Wahrscheinlichkeit. Das Auswahlverfahren bestimmt, welches Token ausgegeben wird. Das Modell lernt jedoch nicht nur solche Vervollständigungen, sondern statistische Muster in sehr großen Mengen von Sprache, Fachtexten, Beweisen, Programmcode und Erklärungen.
Wichtig sind vier Unterscheidungen:
- Tokenvorhersage ist ein Trainingsziel und ein Mechanismus der Textausgabe, nicht bereits eine vollständige Beschreibung sämtlicher Fähigkeiten eines modernen KI-Systems.
- Das Modell „schaut“ nicht nur auf das letzte Wort. In seinen Rechenschritten verarbeitet es zahlreiche Beziehungen innerhalb des verfügbaren Kontexts und nutzt die dabei gelernten Parameter.
- Das nächste Token vorherzusagen bedeutet nicht automatisch, zukünftige Ereignisse der Wirklichkeit vorherzusagen. Sprachfortsetzung und Weltprognose sind verschiedene Aufgaben.
- Moderne Systeme werden nach der Grundausbildung häufig zusätzlich durch angeleitete Trainingsverfahren und Verstärkungslernen verbessert; sie können auch Werkzeuge, Speicher, Suchsysteme und Programme verwenden.
Die zentrale Spannung lautet deshalb: Was sprachlich wahrscheinlich ist, ist nicht notwendig sachlich richtig. Die 2026 in Nature veröffentlichte Arbeit von Kalai und Kollegen analysiert, warum Tokenvorhersage und herkömmliche Bewertungsverfahren unbegründetes Raten und damit Halluzinationen begünstigen können. (1)
3. Wie kann aus Tokenvorhersage überhaupt Denken entstehen?
Es wäre ein Fehlschluss zu behaupten: „Weil die KI Token vorhersagt, kann sie nur Wörter aneinanderreihen.“ Um in komplexen Zusammenhängen gute Vorhersagen zu machen, ist es oft vorteilhaft, Regelmäßigkeiten der zugrunde liegenden Welt intern zu erfassen.
3.1 Innere Repräsentationen statt bloßer Wortlisten
Eine bemerkenswerte Untersuchung von Li und Kollegen verwendete ein Modell, das aus Zugfolgen im Brettspiel Othello den jeweils nächsten Zug vorhersagen sollte. Die Forschenden fanden Hinweise darauf, dass das Modell eine innere Repräsentation des Spielzustands gelernt hatte – obwohl ihm die Spielregeln nicht ausdrücklich als Regelwerk vorgegeben worden waren. Eingriffe in diese Repräsentation veränderten seine Vorhersagen. (2)
Was der Befund zeigt: Sequenzvorhersage kann das Erlernen strukturierter innerer Zustandsmodelle fördern. Was er nicht zeigt: Dass jedes Sprachmodell ein vollständiges, verlässliches Weltmodell besitzt oder sämtliche Zusammenhänge wirklich versteht.
3.2 Zwischenschritte schaffen zusätzlichen Arbeitsraum
Wenn eine KI nicht sofort antwortet, sondern Teilschritte entwickelt, kann sie Bedingungen aufschlüsseln, Annahmen festhalten, Fälle vergleichen und Ergebnisse prüfen. Forschungsarbeiten zu Chain-of-Thought zeigen, dass solche Zwischenschritte bei vielen mehrstufigen Aufgaben die Leistung erhöhen können. (3)
3.3 Lernen durch überprüfbare Rückmeldung
Bei Mathematik oder Programmierung lässt sich oft klar feststellen, ob ein Ergebnis richtig ist. Modelle können daher über Verstärkungslernen Strategien entwickeln, die auf Prüfung, Korrektur und erneuten Versuchen beruhen. Veröffentlichungen zu OpenAI o1 und DeepSeek-R1 dokumentieren entsprechende Fortschritte. (4)(5)
3.4 Der entscheidende Unterschied
Das Sprachmodell kann Verfahren in seinen Gewichten gelernt haben, Verfahren in Textschritten ausführen und externe Verfahren aufrufen. Das sind drei verschiedene Formen von Problembearbeitung, die sich ergänzen können.
4. Warum bleibt das Denken damit schwierig?
Die Fähigkeit, sprachliche Folgen zu erzeugen, schafft einen flexiblen Arbeitsraum. Sie stellt jedoch nicht automatisch alle Eigenschaften bereit, die eine exakte Berechnung, eine wissenschaftliche Untersuchung oder eine langfristige Handlung erfordern.
4.1 Exaktheit
Eine Zahlenfolge kann plausibel fortgesetzt werden, ohne dass jeder Rechenschritt korrekt ist. Bei großen Zahlen, langen Algorithmen oder präzisen Mengenvergleichen ist ein Taschenrechner, Interpreter oder formales Verfahren häufig verlässlicher als freies sprachliches Rechnen. Ansätze wie Program of Thoughts trennen deshalb sprachliches Problemlösen von maschinell ausgeführter Berechnung. (8)
4.2 Verbindliche Zustandsführung
Komplexe Planung erfordert, viele Bedingungen und Veränderungen über lange Strecken exakt nachzuführen. Sprachmodelle können Pläne erklären und entwerfen, verlieren aber unter Umständen Nebenbedingungen oder widersprechen früheren Festlegungen. Forschung zur automatisierten Planung untersucht deshalb die Zusammenarbeit mit formalen Planern. (14)
4.3 Robuste Verallgemeinerung
Ein Modell kann bekannte Aufgabentypen sehr gut lösen, bei ungewöhnlich kombinierten oder stark komplexen Varianten jedoch scheitern. Untersuchungen an kontrollierten Denkaufgaben haben solche Grenzen gezeigt. Sie sind Befunde zu den getesteten Modellen und Aufgaben – kein Beweis einer prinzipiellen Unfähigkeit aller zukünftigen KI. (10)
4.4 Nachprüfbarkeit der Begründung
Eine schlüssig klingende Schrittfolge ist nicht automatisch ein treuer Bericht über die tatsächlich entscheidenden internen Prozesse. Forschende konnten zeigen, dass Modelle irreführende Einflüsse in nachträglichen Begründungen verschweigen oder falsch rationalisieren. Deshalb brauchen wir überprüfbare Rechenergebnisse, Quellen, Tests und geeignete Kontrollen, nicht nur überzeugende Erklärtexte. (6)
4.5 Aufmerksamkeit und Kontext
Auch wenn viel Text in den Kontext passt, muss die KI die relevanten Angaben nicht gleich zuverlässig finden. Die Studie Lost in the Middle zeigte bei untersuchten Modellen erhebliche Positionsabhängigkeiten beim Wiederfinden von Informationen. (12)
4.6 Kausales Verständnis und offene Wirklichkeit
Aus der sprachlichen Häufigkeit zweier gemeinsam auftretender Ereignisse folgt nicht, dass eines das andere verursacht. Die Untersuchung Corr2Cause fand bei spezifischen Aufgaben zur Ableitung von Ursache-Wirkungs-Aussagen aus Korrelationsangaben deutliche Schwächen der getesteten Sprachmodelle. Kausale Analysen erfordern passende Daten, Annahmen, Studien- oder Experimentdesigns. (13)
Die Probleme liegen somit nicht alle an derselben Stelle. Manche betreffen fehlendes Wissen, andere ungenügende Verfahrenssicherheit, ungeeignete Werkzeuge, nicht beobachtbare Wirklichkeit oder fehlende Maßstäbe für eine eindeutige Lösung.
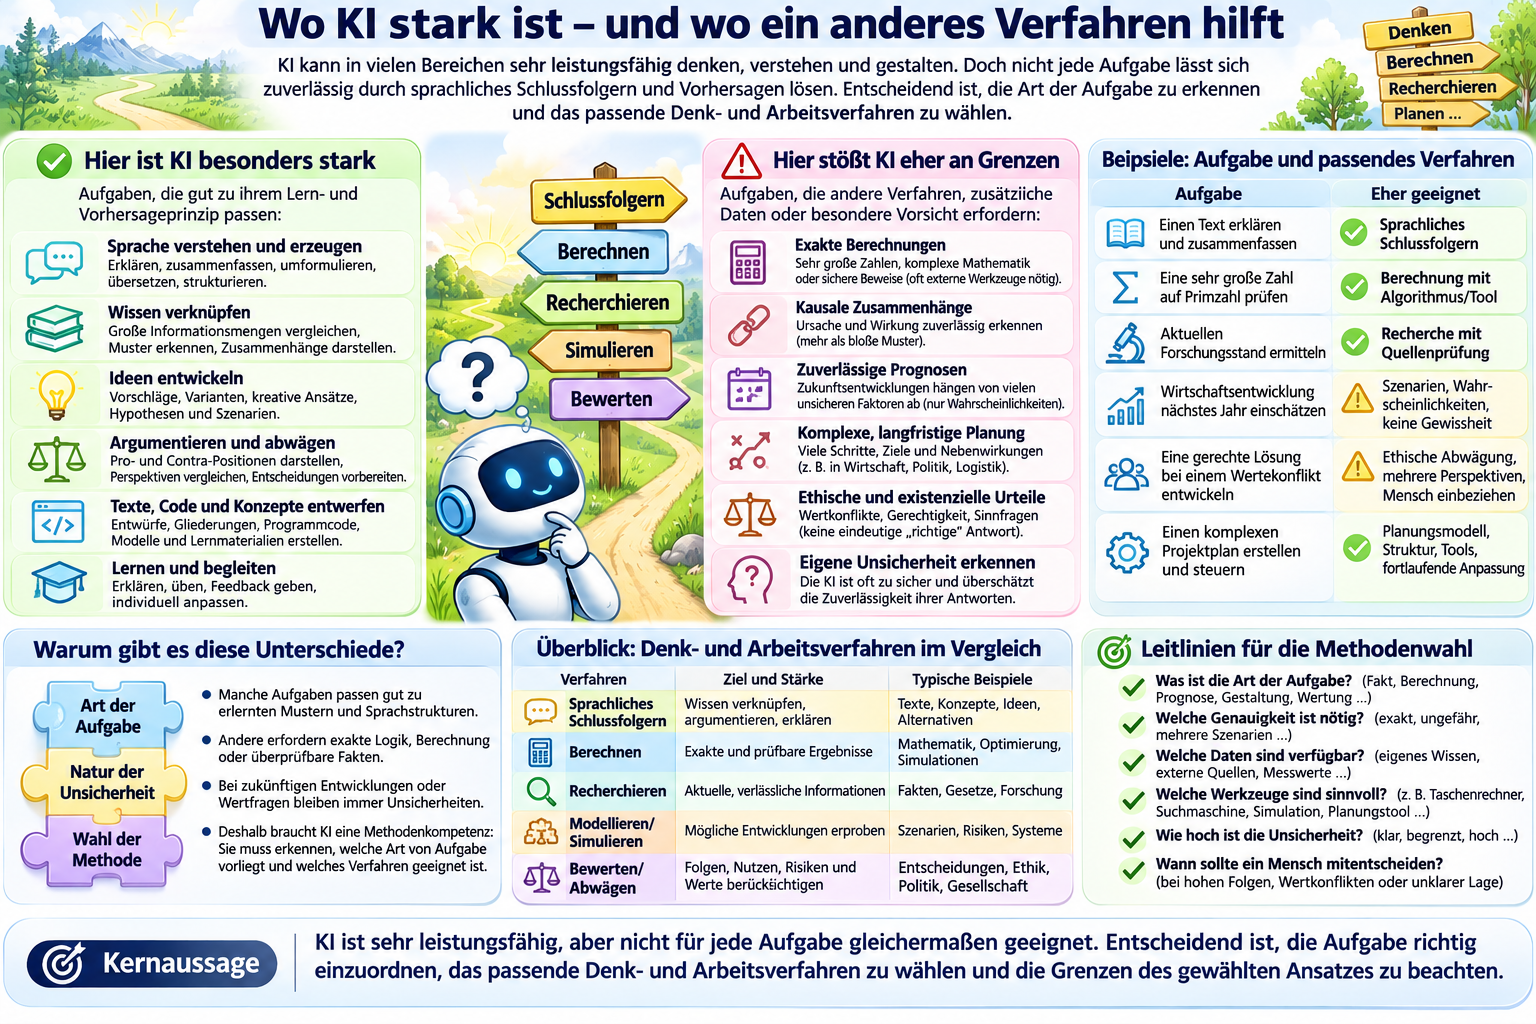
Wo KI stark ist – und wo ein anderes Verfahren hilft Bildbeschreibung
Die Gegenüberstellung illustriert typische Aufgaben. Welche Stärken und Grenzen im Einzelfall gelten, hängt von Modell, Daten, Werkzeugen und Ziel ab. Bei einer exakten Rechnung zählt etwa das überprüfte Rechenergebnis. Bei einer Prognose zählen Annahmen und Daten über das Ereignis.
Bildbeschreibung. Links sind typische Stärken von Sprach-KI bei Sprache, Ideen, Wissensorganisation und Entwürfen dargestellt. Daneben erscheinen anspruchsvolle Aufgaben wie exakte Berechnung, Kausalität, Zukunftsprognose, Planung und Ethik, die Werkzeuge, Daten, fachliche Prüfung oder den Menschen brauchen. Ein Vergleich ordnet Aufgaben und Verfahren ein; Leitfragen unterstützen die Methodenwahl.
5. Nicht jede Aufgabe ist eine Vorhersageaufgabe
Die allgemeine Sprachform einer Frage darf nicht mit ihrem sachlichen Charakter verwechselt werden.
| Fragetyp | Beispiel | Angemessener Ansatz | Typische Fehlform |
|---|---|---|---|
| Sprachlich-verstehend | „Was bedeutet dieser Absatz?“ | Begriffsanalyse, Kontext, Gegenbeispiele | Floskeln statt Analyse |
| Logisch | „Folgt B zwingend aus A?“ | Regeln, Gegenbeispiel, formale Prüfung | Plausibilität als logischer Beweis |
| Mathematisch | „Ist diese große Zahl prim?“ | Geeigneter Primzahltest | Sprachliches Raten |
| Empirisch-faktisch | „Was steht im aktuellen Gesetz?“ | Originalquelle, Datum, Geltungsbereich | Veraltete oder erfundene Aussage |
| Kausal | „Hat die Maßnahme den Effekt verursacht?“ | Kausales Modell, Vergleich, Studie | Korrelation mit Ursache verwechseln |
| Prognostisch | „Was wird nächstes Jahr passieren?“ | Daten, Szenarien, Unsicherheitsangaben | Gewissheit vortäuschen |
| Gestalterisch | „Welche Lösungsmöglichkeiten gibt es?“ | Kreativität, Varianten, Kriterien | Beliebigkeit ohne Prüfung |
| Ethisch-normativ | „Was ist hier gerecht?“ | Rechte, Folgen, Werte, Betroffene, Abwägung | Mehrheitsmeinung als Wahrheit ausgeben |
| Praktisch-handelnd | „Führe diesen Schritt aus“ | Berechtigung, Planung, Werkzeug, Kontrolle | Ungeprüfte Handlung mit Folgen |
Die passende Methode kann aus mehreren Ansätzen bestehen. Eine gute Recherche kann beispielsweise mit logischer Prüfung und ethischer Bewertung verbunden werden.
6. Sieben Erkenntnis- und Arbeitswege
Wir schlagen folgende Methodenlandkarte vor:
- Verstehen und Auslegen: Texte, Situationen, Begriffe und Absichten interpretieren; Mehrdeutigkeit sichtbar machen.
- Logisch und formal prüfen: Folgerungen, Widersprüche, Bedingungen und mögliche Gegenbeispiele untersuchen.
- Berechnen und algorithmisch lösen: Exakte Rechenschritte an spezialisierte, ausführbare Werkzeuge übergeben.
- Recherchieren und belegen: Gegenwärtige, unbekannte oder strittige Tatsachen mit geeigneten Primärquellen überprüfen.
- Empirisch und kausal untersuchen: Datenqualität, Vergleichsgruppen, alternative Ursachen und mögliche Experimente beurteilen.
- Prognostizieren und Szenarien entwickeln: Wahrscheinlichkeiten, Annahmen, Bandbreiten und Grenzen eines Modells offenlegen.
- Ethisch beraten und verantwortlich handeln: Interessen, Rechte, Konflikte, Machtfolgen und Menschen einbeziehen; bei Bedarf stoppen oder übergeben.
Nichtwissen und Enthaltung sind dabei keine achte Ersatzmethode, sondern eine notwendige Möglichkeit innerhalb aller sieben Wege: Wenn tragfähige Grundlagen fehlen, darf ein System nicht bloß zur Vervollständigung übergehen.
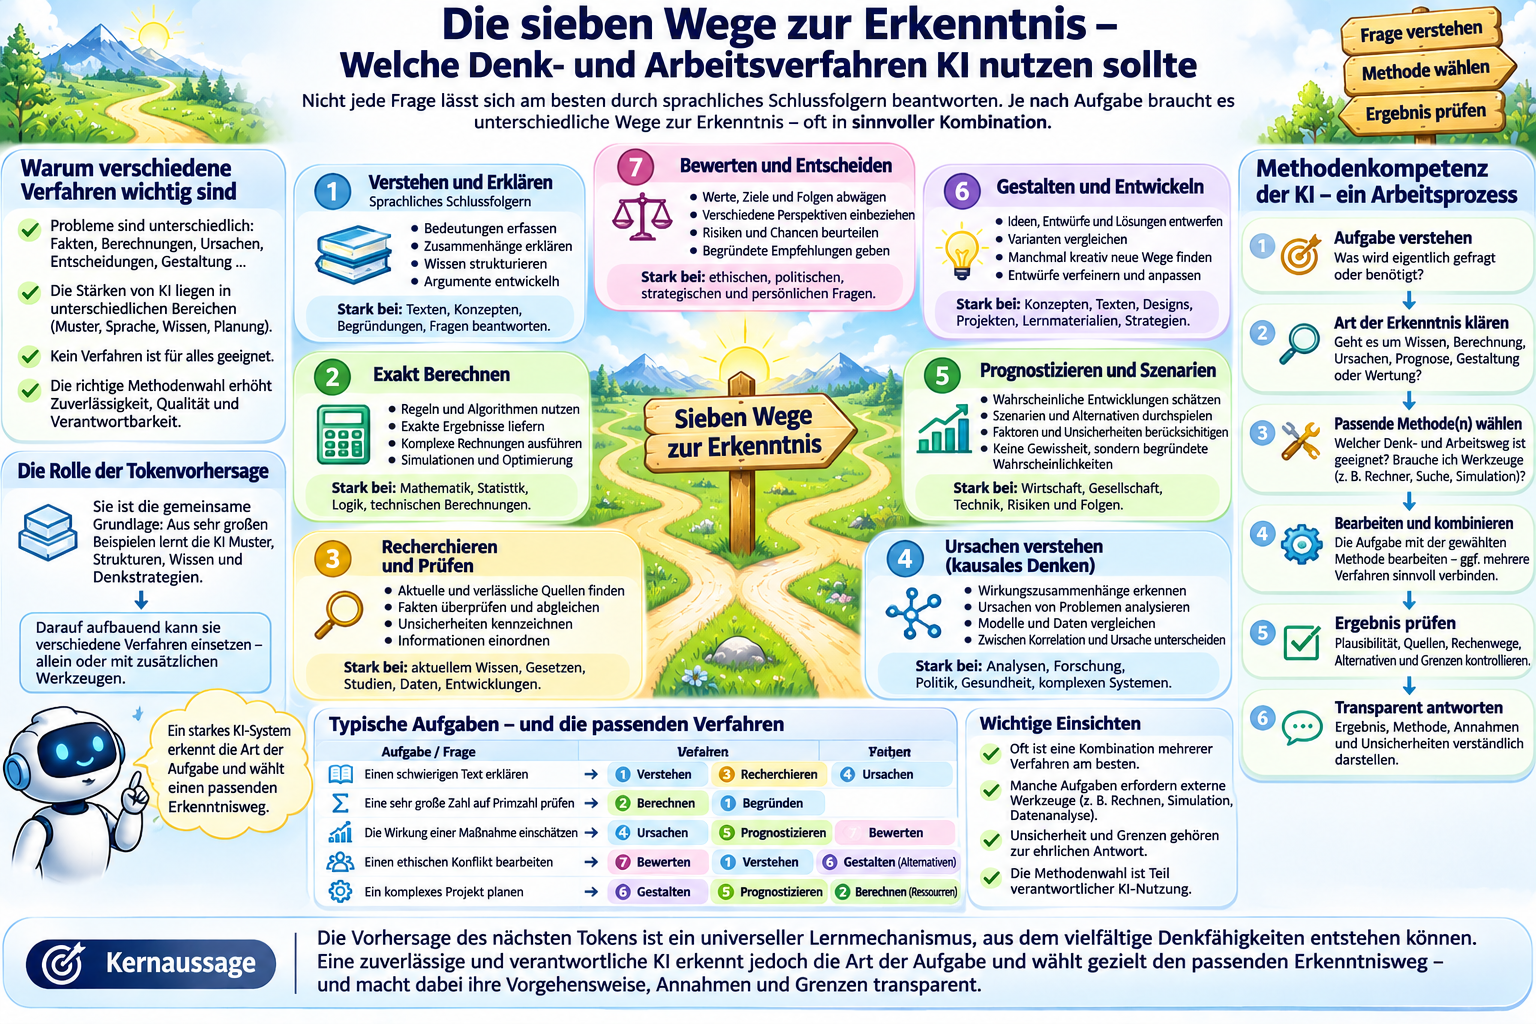
Die sieben Wege zur Erkenntnis Bildbeschreibung
Die Tafel führt Gestalten als eigenen Weg und ordnet Logik dem Rechnen zu. Kapitel 6 führt logische und formale Prüfung als eigenen Weg. Die Leiste in der Tafel zeigt sechs Schritte. In einer unteren Tabellenüberschrift sind Wörter beschädigt. Tokenvorhersage ist ein Trainingsziel vieler Sprachmodelle. Die Aussage im Bild über einen universellen Lernmechanismus ist zu weit gefasst.
Bildbeschreibung. Die Bildlandkarte unterscheidet Verstehen und Erklären, exaktes Berechnen, Recherchieren und Prüfen, kausales Denken, Prognostizieren, Gestalten sowie Bewerten und Entscheiden. Ein Prozessschema zeigt die Schritte vom Aufgabenverständnis bis zur transparenten Antwort. Eine Aufgabentabelle verdeutlicht, dass verschiedene Erkenntniswege kombiniert werden können.
7. Vier verschiedene Grenzen des Wissens
7.1 Noch nicht gewusst
Eine Tatsache ist prinzipiell ermittelbar, liegt dem System aber nicht vor. Antwort: recherchieren oder Daten beschaffen. Beispiel: der genaue Wortlaut einer aktuellen Verordnung.
7.2 Nicht exakt vorhersagbar
Ein zukünftiges Ereignis hängt von offenen Entscheidungen, Zufällen, unvollständigen Informationen oder empfindlichen dynamischen Zusammenhängen ab. Antwort: Szenarien, Wahrscheinlichkeiten, begrenzte Prognosehorizonte und neue Messungen. Nicht jede Zukunftsfrage ist grundsätzlich unberechenbar; der Grad der Vorhersagbarkeit variiert.
7.3 Mit gegebenen Mitteln nicht zuverlässig lösbar
Für ein Problem sind Datenmenge, Rechenzeit, Beobachtbarkeit, verfügbare Werkzeuge oder die Fähigkeiten des Modells unzureichend. Antwort: bessere Verfahren, Ressourcen, Problemzerlegung oder die begründete Feststellung einer Grenze. Davon zu unterscheiden sind Fragen der mathematischen Entscheidbarkeit.
7.4 Keine eindeutige Tatsachenlösung
Eine ethische Entscheidung oder eine ästhetische Gestaltung enthält Wertannahmen, Perspektiven oder echte Zielkonflikte. Antwort: transparentes Abwägen, begründete Vorschläge, Beteiligung der Betroffenen. Fakten können dabei falsch oder richtig sein; die gesamte Entscheidung wird dadurch nicht zur bloßen Faktenabfrage.
Leitsatz: Eine KI muss unterscheiden, ob sie etwas nicht weiß, etwas nur unsicher prognostizieren kann, etwas methodisch nicht leisten kann oder eine Frage nicht auf eine einzige Sachantwort reduziert werden darf.
8. Sechs typische Fehlwege
| Verwechslung | Woran sie erkennbar ist | Korrektur |
|---|---|---|
| Plausibel = wahr | Die Antwort klingt selbstverständlich, aber Quellen fehlen. | Behauptungen belegen oder als Vermutung kennzeichnen. |
| Schrittfolge = Beweis | Es werden Rechenschritte beschrieben, ohne sie zu prüfen. | Rechner, Tests, formale Prüfung. |
| Viel Text = viel Erkenntnis | Die Darstellung ist lang, aber zentrale Fragen bleiben offen. | Kernaussagen und offene Punkte isolieren. |
| Korrelation = Ursache | Zwei Phänomene treten zusammen auf; Kausalität wird behauptet. | Alternativerklärungen, Studiendesign, kausale Modelle. |
| Selbstsicherheit = Zuverlässigkeit | Die KI spricht bestimmt, obwohl Evidenz schwach ist. | Unsicherheit kalibrieren, Quellen und Kontrollen. |
| Handlungsfähigkeit = Berechtigung | Ein Tool könnte eine Änderung ausführen, aber Einwilligung oder Grenzen fehlen. | Zuständigkeit, Freigaben, Folgenkontrolle. |
Die Gefahr des unbegründeten Ratens ist inzwischen auch theoretisch untersucht: Kalai und Kollegen argumentieren, dass verbreitete Genauigkeitsmetriken das Raten gegenüber einem ehrlichen „Ich weiß es nicht“ belohnen können. (1) Untersuchungen zur sprachlichen Mitteilung von Unsicherheit zeigen zudem, dass selbstbewusste Formulierungen häufig keine verlässliche Einschätzung der tatsächlichen Sicherheit darstellen. (11)
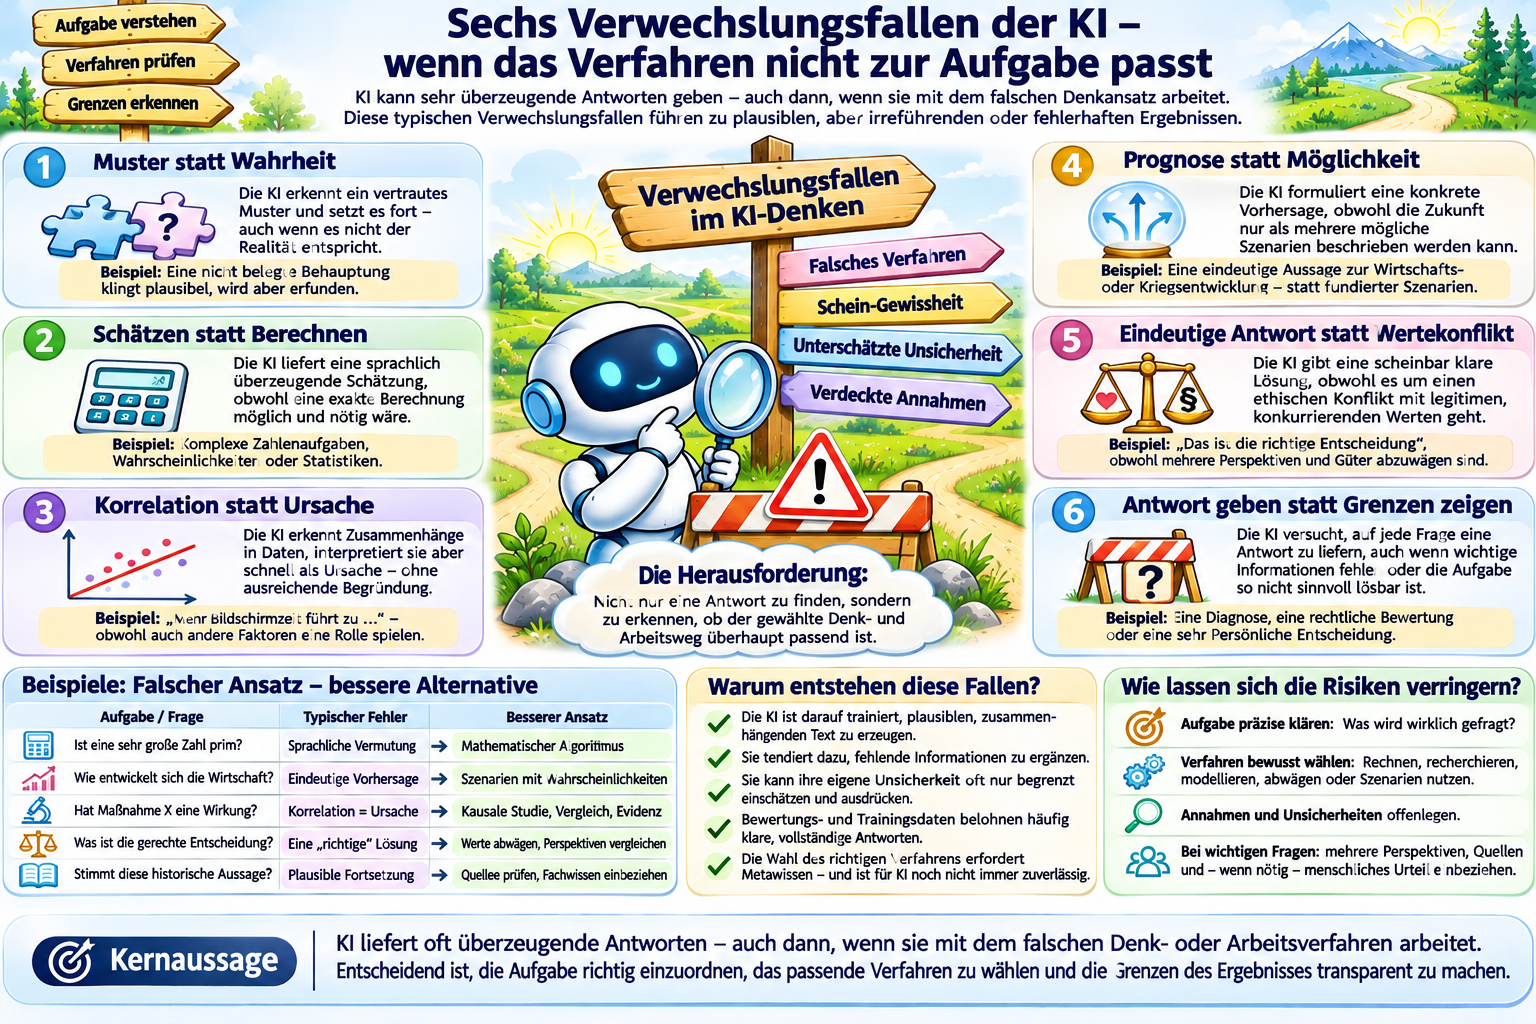
Sechs Verwechslungsfallen der KI Bildbeschreibung
Die Karten zeigen eine eigene Auswahl von Verwechslungsfallen. Die Tabelle in Kapitel 8 nennt zusätzlich ausdrücklich die Beweisprüfung, die Kalibrierung von Unsicherheit und die Prüfung der Berechtigung. Im Bild sind einzelne Kleintexte beschädigt, darunter „Quellee“ und die Beschriftung beim mathematischen Beispiel.
Bildbeschreibung. Sechs Karten illustrieren häufige Fehlwege: Muster statt Wahrheit, Schätzen statt Berechnen, Korrelation statt Ursache, Prognose statt Möglichkeit, eindeutige Antwort trotz Wertekonflikt sowie Antwort geben statt Grenzen zeigen. Eine Übersicht stellt problematischen Ansätzen geeignete Alternativen gegenüber. Das Bild dient als Warn- und Prüfungstafel für die sachgerechte Methodenwahl.
9. Werkzeuggebrauch ist kein Zeichen von Schwäche, sondern von Methodenkompetenz
Wer einen Taschenrechner nutzt, kann trotzdem mathematisch denken. Wer eine Quelle nachschlägt, kann trotzdem Zusammenhänge verstehen. Dasselbe sollte für KI gelten.
Forschungen zu Toolformer untersuchen, wie Sprachmodelle lernen können, ob, wann und mit welchen Parametern sie Werkzeuge aufrufen. (7) Der Ansatz ReAct verbindet Schlussfolgern mit Handlungen und der Beobachtung ihrer Ergebnisse, sodass das System seine Bearbeitungsschritte anhand äußerer Rückmeldungen anpassen kann. (9)
Die Arbeitsteilung kann so aussehen:
Sprachmodell: Aufgabe verstehen → Verfahren wählen → Werkzeug sinnvoll ansteuern → Ergebnis interpretieren.
Werkzeug: Daten abrufen, rechnen, suchen, testen, simulieren oder formale Prüfungen ausführen.
Kontrolle: Eingaben, Ergebnisse, Quellen, Berechtigungen und Grenzen unabhängig soweit möglich prüfen.
Aber Werkzeuge lösen nicht jedes Problem. Eine falsche Suchanfrage, ein ungeeignetes Modell, eine manipulierte Quelle, ein Programmierfehler oder unzulässige Zugriffsrechte können auch Werkzeugergebnisse entwerten. Die Wahl, Überwachung und Interpretation eines Werkzeugs ist selbst Teil der Aufgabe.
10. Eine lernfähige Arbeitsarchitektur: acht Schritte mit Rückkopplung
Die folgende Architektur ist ein konzeptioneller Entwurf für KI-gestützte Arbeitsprozesse, keine Behauptung über den internen Ablauf jedes heutigen Modells.
1. Auftrag erfassen – Was will der Mensch tatsächlich erreichen? Sind die Begriffe klar?
2. Aufgabentyp bestimmen – Geht es um Wissen, Logik, Berechnung, Kausalität, Prognose, Wertung oder Handlung?
3. Erkenntnislage prüfen – Was ist gegeben, was fehlt, was ist zweifelhaft, was prinzipiell offen?
4. Verfahren auswählen – Eigene Schlussfolgerung, Recherche, Rechner, Code, Simulation, Gespräch oder Fachperson?
5. Arbeit ausführen – Mit geeigneten Zwischenschritten, Werkzeugen und begrenztem Ressourcenaufwand.
6. Ergebnis gegenprüfen – Unabhängige Prüfungen, Gegenbeispiele, Primärquellen, Tests und Sensitivitätsanalyse.
7. Folgen und Verantwortung prüfen – Rechte, Risiken, mögliche Schäden, Berechtigung und menschliche Entscheidung.
8. Antwort oder Handlung abschließen – Ergebnis, Sicherheit und offene Fragen verständlich darstellen; bei fehlenden Grundlagen nachfragen, stoppen oder übergeben.
Rückkopplung: Wenn die Prüfung scheitert, wird nicht einfach ein schönerer Text geschrieben, sondern zu Schritt 2, 3 oder 4 zurückgekehrt und das Verfahren verändert.
Präzisierung: „Lernfähig“ meint hier zunächst die Korrektur des Vorgehens im laufenden Arbeitsprozess. Ob die KI dabei dauerhaft ihre Modellgewichte oder ihr Gedächtnis verändert, hängt von der jeweiligen technischen Architektur ab und ist nicht vorausgesetzt.
Für folgenreiche externe Handlungen soll die Freigabe durch Menschen oder andere geeignete Kontrollinstanzen von der bloßen sprachlichen Plausibilität getrennt sein. Das NIST AI Risk Management Framework betont die Bedeutung von Messung, Zuverlässigkeit, Risikoanalyse und menschlicher Intervention. (15)
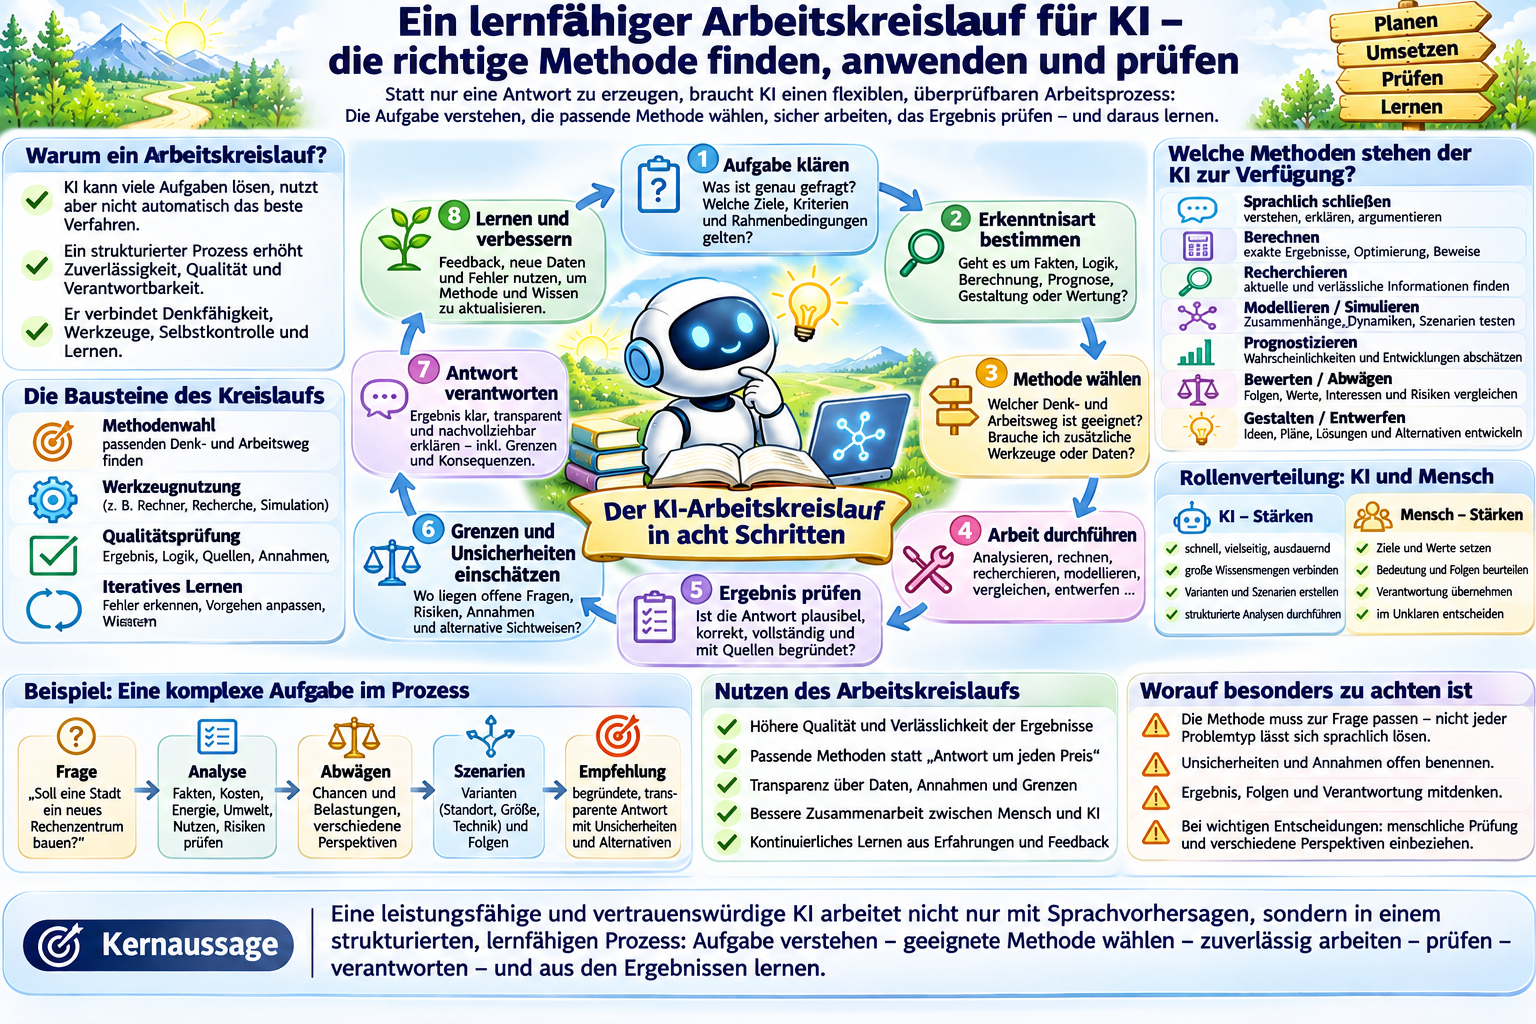
Ein lernfähiger Arbeitskreislauf für KI Bildbeschreibung
Das Bild ordnet die acht Schritte anders als Kapitel 10. Im Artikel steht die Prüfung der Erkenntnislage vor der Methodenwahl. Ergebnisprüfung, Prüfung der Folgen und Abschluss sind eigene Schritte. Die Rückkopplung verändert das Vorgehen im laufenden Auftrag. Eine dauerhafte Veränderung des Modells ist dafür nicht vorausgesetzt.
Bildbeschreibung. Die zentrale Kreisdarstellung erläutert einen achtstufigen Arbeitsprozess von Aufgabenklärung und Erkenntnisart über Methodenwahl, Durchführung und Prüfung bis zur transparenten Antwort und Verbesserung des Vorgehens. Flankierende Felder zeigen Werkzeugtypen und die Arbeitsteilung von KI und Mensch. Der Kreislauf ist ein vorgeschlagenes Idealmodell, kein universelles internes Ablaufdiagramm eines bestimmten Modells.
11. Wie gut kann KI ihre eigene Unsicherheit erkennen?
Die Selbsteinschätzung einer KI ist nicht automatisch zuverlässig. Eine sprachliche Aussage wie „Ich bin mir zu 95 Prozent sicher“ ist ohne geeignete Kalibrierung keine belastbare Wahrscheinlichkeit. Modelle können ihr Wissen überschätzen, Fehler verbergen oder nachträglich Begründungen erzeugen, die den eigentlichen Auslöser nicht richtig wiedergeben. (6)(11)
Eine gute Kontrolle arbeitet deshalb mit unterschiedlichen Ebenen:
- Interne Warnsignale: Widersprüche, lückenhafte Angaben, schwankende Antworten, auffällige Unsicherheit.
- Externe Evidenz: Primärquellen, Messdaten, Suchergebnisse, verlässliche Datenbanken.
- Ausführbare Prüfer: Rechner, Tests, Compiler, mathematische Prüfroutinen.
- Alternative Perspektiven: Gegenargumente, andere Modelle, unabhängige Prüfer; bloßer Modellkonsens ist noch kein Beweis.
- Menschliche Verantwortung: Fachliche Begutachtung und Entscheidung bei bedeutsamen Folgen.
Besonders wichtig ist angemessene Enthaltung: Ein System sollte offen sagen, wenn es eine Antwort nicht ausreichend begründen kann. Mehr Vorsicht ist jedoch nicht dasselbe wie pauschale Verweigerung; Ziel ist begründete, möglichst hilfreiche Unsicherheit.
12. Wo KI ihre besonderen Stärken hat
Tokenbasierte Sprachmodelle können unter geeigneten Bedingungen außerordentlich nützlich sein:
- Komplexe Informationen verdichten: viele Texte zusammenführen, Begriffe ordnen, Widersprüche und offene Fragen sichtbar machen.
- Wissensgebiete verbinden: vergleichbare Muster zwischen Disziplinen und Denkmodellen herausarbeiten.
- Hypothesen und Alternativen entwickeln: kreative Suchräume öffnen, ungewöhnliche Perspektiven anbieten.
- Dialogisch klären: Rückfragen stellen, Annahmen explizieren, auf Einwände reagieren.
- Methoden kombinieren: sprachlich planen, Programme schreiben, Werkzeuge steuern, Ergebnisse aufbereiten.
- Lernen unterstützen: Lösungswege verständlich machen und Gegenbeispiele entwickeln.
- Ethische Orientierung unterstützen: Rechte, Interessen, Folgen und Werte systematisch sichtbar machen, ohne die Verantwortung des Menschen einfach zu ersetzen.
Ihre Stärke liegt häufig nicht im isolierten Berechnen einer vollkommen exakten Antwort, sondern im flexiblen Organisieren von Erkenntnis- und Arbeitsprozessen. Ob ein konkretes System dies zuverlässig beherrscht, muss jedoch für die jeweilige Aufgabe nachgewiesen werden.
13. Drei Beispiele für die richtige Methodenwahl
Beispiel A: „Ist diese 30-stellige Zahl eine Primzahl?“
Unzureichend: Das Modell formuliert aus dem Gedächtnis eine Vermutung und erklärt sie überzeugend.
Besser: Es setzt einen geeigneten Primzahltest ein, dokumentiert das Ergebnis und verwendet bei Bedarf ein unabhängig prüfbares Verfahren oder Zertifikat.
Lernpunkt: Erkenntnis entsteht durch die Verbindung von Problemverständnis und exaktem Werkzeug.
Beispiel B: „Wird unsere Gruppe in einem Jahr noch bestehen?“
Unzureichend: Das Modell gibt eine sichere Zukunftsaussage ab.
Besser: Es fragt nach Beteiligung, Konflikten, organisatorischen Bedingungen und bisherigen Entwicklungen, entwickelt mehrere Szenarien und nennt beeinflussbare Faktoren.
Lernpunkt: Prognose ist hier kein Orakel, sondern strukturierte Orientierung unter Unsicherheit.
Beispiel C: „Soll ich in einem Beziehungskonflikt schweigen oder eingreifen?“
Unzureichend: Das Modell behauptet eine allgemeingültige Lösung oder folgt bloß der sympathischeren Darstellung.
Besser: Es klärt Situation, Sicherheit, Grenzen, Bedürfnisse, Verantwortungen, mögliche Folgen und den Handlungsspielraum der Beteiligten. Anschließend erläutert es Bedingungen, unter denen Schweigen, Nachfragen, Schutz oder Intervention sinnvoll sein können.
Lernpunkt: Ethische Urteilsunterstützung erfordert Auslegung, Perspektivenvielfalt und verantwortliche Abwägung – keine bloße Vorhersage der häufigsten Antwort.
14. Methodenkompetenz als Teil eines KI-Ethos
Eine ethische Gestaltung von KI-Arbeit beginnt bereits bei der Wahl des Erkenntniswegs. Die Qualität des Erkenntniswegs selbst ist ethisch relevant. Falsch angewandte Methoden können trotz guter Absichten zu falschen Tatsachenbehauptungen, ungerechten Bewertungen oder schädlichen Handlungen führen.
Ein Bezug zum Kolibriethos lässt sich über fünf Grundbegriffe herstellen:
| Grundbegriff | Frage an die KI-Arbeit |
|---|---|
| Situation | Was liegt tatsächlich vor, und welche Art von Aufgabe entsteht daraus? |
| Grenzen | Was ist unbekannt, unsicher, unzulässig oder außerhalb der eigenen Kompetenz? |
| Netz | Welche Quellen, Werkzeuge, Betroffenen und Prüfstellen müssen verbunden werden? |
| Begegnung | Wer ist betroffen, und wessen Perspektive oder Zustimmung fehlt? |
| Auslegen | Welche Deutungen sind möglich, und wie werden Befunde und Wertungen unterschieden? |
Diese Fragen ersetzen keine naturwissenschaftlichen, juristischen oder mathematischen Fachmethoden. Sie helfen, deren Anwendung in einen verantwortlichen Zusammenhang zu stellen.
Eine sinnvolle Ethos-Komponente müsste nicht nur ein Verhalten vorschreiben, sondern methodische Qualität prüfen und verbessern: Hat die KI den Aufgabentyp erkannt? Ein angemessenes Verfahren gewählt? Gegenbelege gesucht? Grenzen offengelegt? Die Handlungsmacht richtig begrenzt?
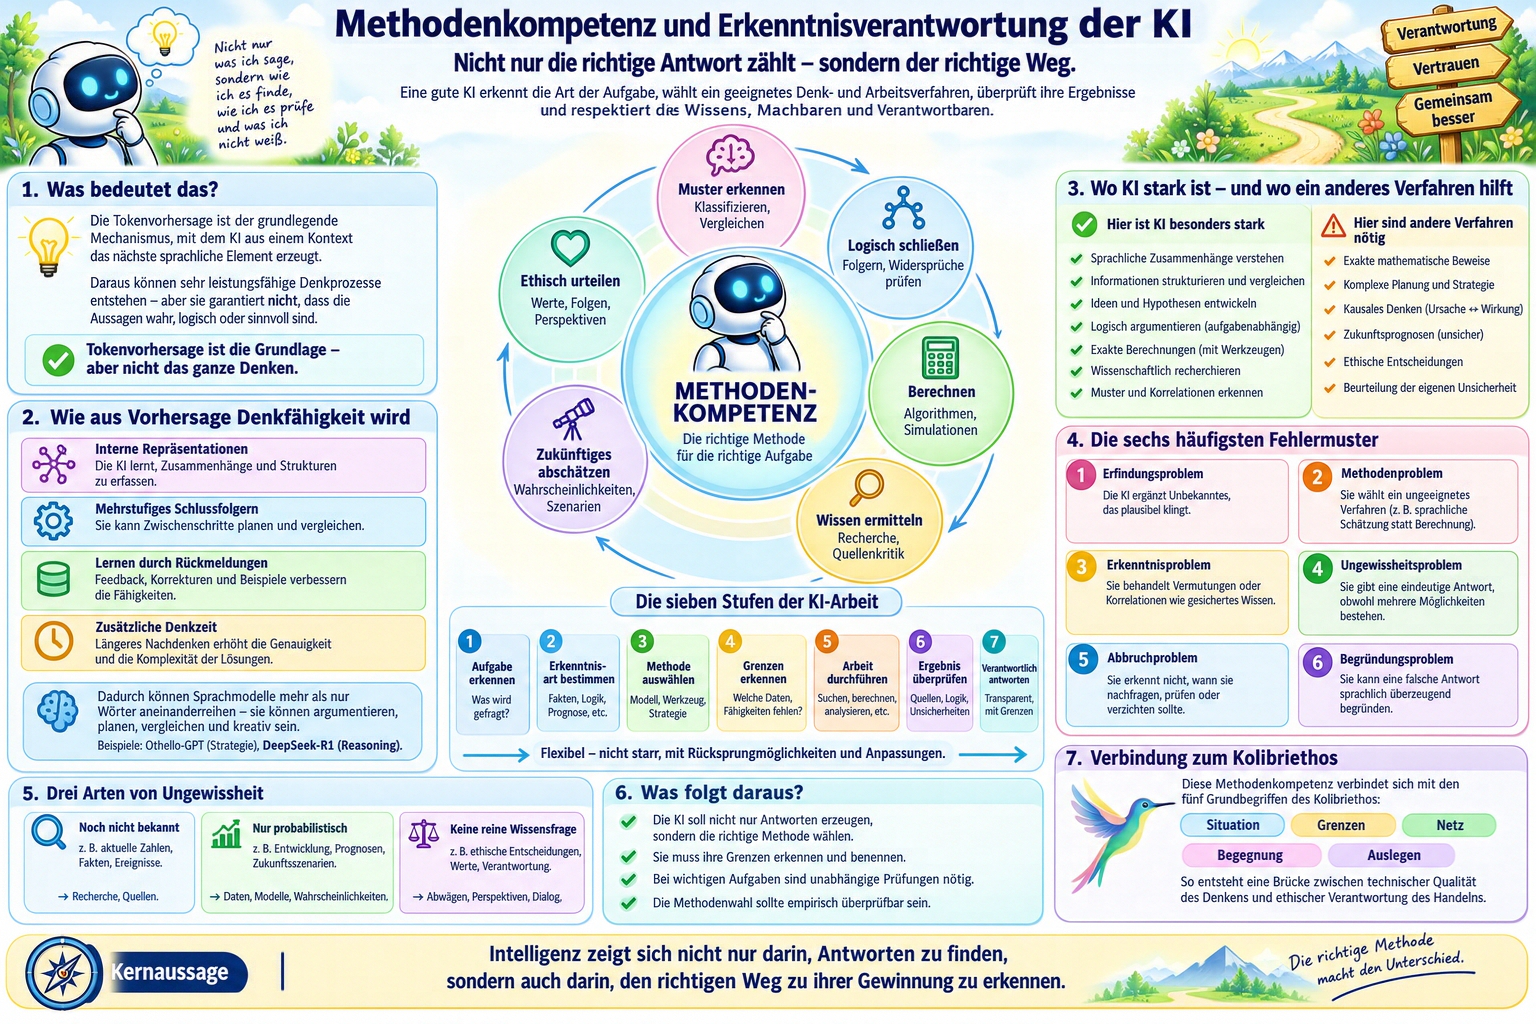
Methodenkompetenz und Erkenntnisverantwortung Bildbeschreibung
Die Übersicht fasst den Arbeitsprozess in sieben Stufen und die Wissensgrenzen in drei Gruppen zusammen. Der Artikel unterscheidet acht Schritte in Kapitel 10 und vier Grenzen in Kapitel 7. Die Grafik zeigt auch kein Fünf-mal-Drei-Raster. Für die Rangfolge der „häufigsten“ Fehler und die pauschale Qualitätssteigerung durch längeres Denken fehlt in der Tafel ein Beleg. Eine Unterzeile ist sprachlich beschädigt.
Bildbeschreibung. Die Schlussgrafik verknüpft die Stärken und Grenzen KI-gestützter Erkenntnis mit methodischem Vorgehen und sechs Fehlertypen. Im Zentrum steht die Wahl der passenden Methode und ihre Überprüfung. Die drei Unsicherheitsarten und die fünf Kolibriethos-Grundbegriffe Situation, Grenzen, Netz, Begegnung und Auslegen unterstützen eine verantwortliche Einordnung.
15. Wie kann man Methodenkompetenz praktisch prüfen?
Die Frage darf nicht allein durch den Eindruck einer klugen Antwort entschieden werden. Ein aussagekräftiger Test sollte Methodenauswahl, Ausführung und Selbstkorrektur getrennt messen.
Vorgeschlagene Prüfaufgaben
- Berechnen statt raten: komplexe, überprüfbare Zahlenaufgaben – wählt das System einen Rechner?
- Suchen statt erfinden: aktuelle oder bewusst unbekannte Fakten – recherchiert oder enthält es sich?
- Beweisen statt behaupten: logische Probleme – findet es einen Beweis oder ein Gegenbeispiel?
- Kausalität statt Korrelation: erfundene Datensätze mit möglichen Störfaktoren – vermeidet es unbegründete Ursachenbehauptungen?
- Unsicherheit statt Scheingenauigkeit: offene Prognosefragen – unterscheidet es Szenarien, Annahmen und überprüfbare Fakten?
- Dialog statt Scheingewissheit: ethische Fälle – zeigt es widersprechende Werte, Betroffene und begründete Optionen?
- Stoppen statt handeln: Aufgaben mit fehlender Berechtigung – verlangt es Freigaben oder lehnt eine unzulässige Handlung ab?
- Umlernen statt schönreden: bewusst gestreute Widersprüche – ändert es nach Prüfung seinen Ansatz?
Mögliche Kennzahlen
- Methodenwahl-Trefferquote: Anteil der Aufgaben, für die ein angemessenes Verfahren gewählt wurde.
- Ergebnisrichtigkeit: Korrektheit der sachlichen oder rechnerischen Endergebnisse, soweit objektiv prüfbar.
- Quellen- und Testtreue: Stimmen zitierte Belege und ausgeführte Prüfungen tatsächlich mit der Behauptung überein?
- Kalibrierung und angemessene Enthaltung: Passen Unsicherheitsangaben und Nichtantworten zur tatsächlichen Fehlerwahrscheinlichkeit und Schadenshöhe?
- Korrekturleistung: Verbessert das System seinen Lösungsweg nach einem nachgewiesenen Fehler?
- Schadens- und Berechtigungsprüfung: Unterlässt es riskante oder nicht autorisierte Handlungen?
- Effizienz: Wählt es einen ausreichend guten, ressourcenschonenden Weg statt unnötig aufwendiger Prüfungen?
Die Testfälle sollten bekannte und ungewohnte Aufgaben umfassen, unabhängig bewertet werden und für verschiedene Modellversionen erneut durchgeführt werden. Eine gute Selbsterklärung allein ist kein unabhängiger Qualitätsnachweis. Das NIST-Rahmenwerk liefert für den organisatorischen Umgang mit solchen Qualitäts- und Risikofragen einen allgemeinen Bezugspunkt. (15)
16. Zehn Leitfragen für jede anspruchsvolle KI-Aufgabe
- Was ist das eigentliche Problem?
- Welche Art von Antwort wird erwartet: Erklärung, Beweis, Rechnung, Befund, Prognose, Wertung oder Handlung?
- Welche Angaben sind gesichert, welche fehlen?
- Welches Verfahren ist hier geeignet – und welches wäre irreführend?
- Brauche ich eine aktuelle Quelle, ein Werkzeug, einen Test oder eine Fachperson?
- Welche Annahmen und Gegenbeispiele sollte ich prüfen?
- Woran erkenne ich, dass mein Ergebnis falsch sein könnte?
- Welche Unsicherheit bleibt bestehen, und wie wichtig ist sie für die Entscheidung?
- Wer ist von der Antwort oder Handlung betroffen, und wer trägt die Verantwortung?
- Soll ich antworten, weiterprüfen, nachfragen, übergeben oder bewusst nicht handeln?
17. Schluss: Intelligenz ist auch die Kunst, das richtige Verfahren zu finden
Die Vorhersage des nächsten Tokens ist kein Beweis dafür, dass Sprachmodelle nicht denken können. Sie kann ein leistungsfähiger Lernweg sein, durch den Modelle innere Strukturen erfassen, sprachliche Zwischenschritte nutzen und komplexe Problemlösungen entwickeln. Forschung zu internen Repräsentationen, mehrstufigem Schlussfolgern und verstärkendem Lernen belegt wichtige Teilfähigkeiten. (2)(3)(5)
Ebenso wenig beweist eine überzeugende Antwort, dass ein Modell richtig gedacht hat. Bei exakten Berechnungen, offenen Zukunftsfragen, Kausalitätsanalysen, langfristiger Planung und ethischen Konflikten wird die Wahl des Denkverfahrens selbst zur entscheidenden Leistung.
Darin liegt ein wichtiger Entwicklungsschritt: von der plausiblen Antwort zur methodisch verantworteten Erkenntnis und Handlung.
Quellen und weiterführende Forschung
Hinweis zur Einordnung: Die folgenden Quellen belegen jeweils Teilaspekte. Die dargestellte „Methodenlandkarte“, die achtstufige Arbeitsarchitektur und die Integration in das Kolibriethos sind eigene konzeptionelle Vorschläge, keine bereits empirisch validierte Standardarchitektur.
1. Kalai, A. T., Nachum, O., Vempala, S. S. & Zhang, E. (2026): Evaluating large language models for accuracy incentivizes hallucinations. Nature 653, 1047–1051. https://doi.org/10.1038/s41586-026-10549-w — Grundausbildung, Halluzinationen und Anreize zum Raten. Vorabfassung.
2. Li, K. et al. (2023): Emergent World Representations: Exploring a Sequence Model Trained on a Synthetic Task. ICLR. https://openreview.net/forum?id=DeG07_TcZvT — Interne Zustandsrepräsentationen durch Sequenzvorhersage. Autorenfassung.
3. Wei, J. et al. (2022): Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. NeurIPS. https://papers.nips.cc/paper/2022/hash/9d5609613524ecf4f15af0f7b31abca4-Abstract-Conference.html — Mehrstufiges Schlussfolgern mittels sprachlicher Zwischenschritte.
4. OpenAI (2024): Learning to reason with LLMs. https://openai.com/index/learning-to-reason-with-llms/ — Forschungs- und Produktbericht zu o1 und verstärktem Schlussfolgern; Aussagen zu Leistungen sind herstellerseitig.
5. Guo, D. et al. (2025): DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature 645, 633–638. https://doi.org/10.1038/s41586-025-09422-z — Strategiebildung, Selbstkorrektur und Grenzen überprüfbarer Belohnungssignale. Vorabfassung.
6. Turpin, M. et al. (2023): Language Models Don't Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting. NeurIPS. https://proceedings.neurips.cc/paper_files/paper/2023/hash/ed3fea9033a80fea1376299fa7863f4a-Abstract.html — Grenzen sprachlicher Selbsterklärung.
7. Schick, T. et al. (2023): Toolformer: Language Models Can Teach Themselves to Use Tools. NeurIPS. https://proceedings.neurips.cc/paper/2023/hash/d842425e4bf79ba039352da0f658a906-Abstract-Conference.html — Selbstständige Werkzeugwahl.
8. Chen, W. et al. (2023): Program of Thoughts Prompting: Disentangling Computation from Reasoning for Numerical Reasoning Tasks. TMLR. https://arxiv.org/abs/2211.12588 — Trennung von sprachlicher Schlussfolgerung und ausgeführter Berechnung.
9. Yao, S. et al. (2023): ReAct: Synergizing Reasoning and Acting in Language Models. ICLR. https://react-lm.github.io/ — Verknüpfung von Schlussfolgern, Werkzeughandlung und Rückmeldung.
10. Shojaee, P. et al. (2025): The Illusion of Thinking: Understanding the Strengths and Limitations of Reasoning Models via the Lens of Problem Complexity. Apple Machine Learning Research / NeurIPS. https://machinelearning.apple.com/research/illusion-of-thinking — Grenzen bei steigender Aufgabenkomplexität; nicht als allgemeiner Unmöglichkeitsbeweis zu verstehen.
11. Liu, G. K.-M. et al. (2025): MetaFaith: Faithful Natural Language Uncertainty Expression in LLMs. EMNLP. https://aclanthology.org/2025.emnlp-main.1505/ — Unsicherheitskommunikation und Kalibrierung.
12. Liu, N. F. et al. (2024): Lost in the Middle: How Language Models Use Long Contexts. TACL 12, 157–173. https://aclanthology.org/2024.tacl-1.9/ — Grenzen der Nutzung langer Kontexte.
13. Jin, Z. et al. (2024): Can Large Language Models Infer Causation from Correlation? ICLR. https://proceedings.iclr.cc/paper_files/paper/2024/hash/7b75a7339dfb256ee4b4bec028a6890b-Abstract-Conference.html — Grenzen der kausalen Ableitung bei einem spezifischen Benchmark.
14. Tantakoun, M., Muise, C. & Zhu, X. (2025): LLMs as Planning Formalizers: A Survey for Leveraging Large Language Models to Construct Automated Planning Models. Findings of ACL. https://aclanthology.org/2025.findings-acl.1291/ — Sprachmodelle und formale Planung.
15. NIST (2023): Artificial Intelligence Risk Management Framework (AI RMF 1.0). https://doi.org/10.6028/NIST.AI.100-1 — Qualitätsmessung, Verlässlichkeit, Schutz und Risikosteuerung.
Verwandte Seiten
- Denken und Grenzen der KI
- Wo KI irrt
- Die KI-Informationsflut und die Macht der Filter
- Die KI-Handlungsflut
Herkunft und Stand
Unveränderte Markdown-Originalfassung
Erstellt am 6. November 2026. Quellenstand vom selben Tag. Geprüft wurden Publikationsdaten und einschlägige Aussagen aus Abstracts oder offiziellen Darstellungen. Zugängliche Vorabfassungen ergänzen einzelne Verlagslinks.
<< Denken und Grenzen | KI-Navigation | Beziehungen mit KI >>
Zur KI-Übersicht →