Der Wissenskreislauf der KI
KI-Navigation | Der Wissenskreislauf der KI
Nehmen – lernen – schaffen – zurückgeben
Generative KI entsteht nicht aus dem Nichts. Sie baut auf Sprache, Bildern, Musik, Forschung, Software, journalistischer Arbeit, kulturellen Überlieferungen und unzähligen weiteren menschlichen Leistungen auf. Zugleich kann sie vorhandenes Wissen neu kombinieren, leichter zugänglich machen und neue Texte, Bilder, Programme, Analysen und Ideen hervorbringen.
Deshalb greift die Frage „Darf KI urheberrechtlich geschützte Inhalte zum Lernen verwenden?“ allein zu kurz. Die umfassendere ethische Frage lautet:
Das Leitmotiv dieser Seite lautet:
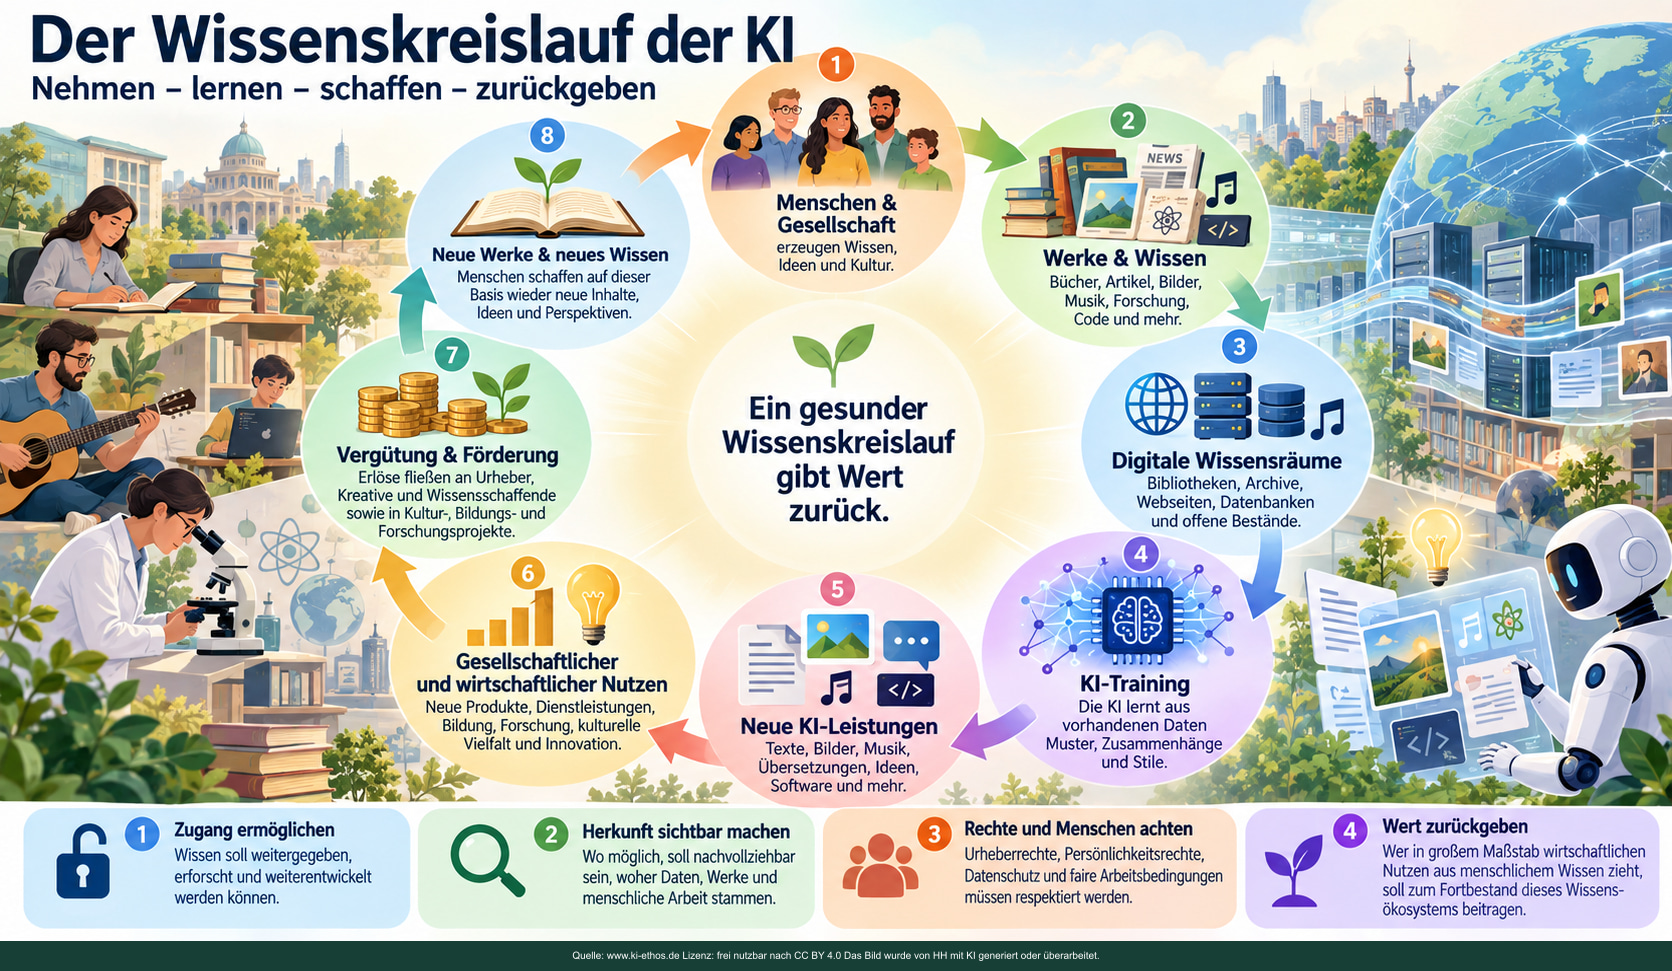
Das Schaubild ist ein ethisches Gestaltungsmodell. Die Pfeile zeigen gewünschte Zusammenhänge, keine gemessenen Geldflüsse oder garantierte Wirkung.
Ein gesunder Wissenskreislauf gibt Wert zurück: Zugang ermöglichen, Herkunft sichtbar machen, Rechte und Menschen achten, Wert zurückgeben.
1. Wissen entsteht aus Wissen
Kein Mensch beginnt geistig bei Null. Schriftsteller lesen andere Schriftsteller. Wissenschaftler bauen auf früheren Forschungen auf. Musiker kennen andere Musik. Programmierer verwenden Algorithmen, Dokumentationen, Bibliotheken und Konzepte, die andere entwickelt haben. Religionen, Philosophien und Kulturen leben von jahrhundertelanger Überlieferung, Auslegung und Weiterentwicklung.
Aufnehmen – verarbeiten – verändern – weitergeben ist ein Grundprozess menschlicher Kultur.
Darum wäre es zu einfach, KI grundsätzlich jede Verarbeitung geschützter Inhalte zu verbieten. Ebenso zu einfach wäre jedoch der umgekehrte Satz: „Menschen dürfen aus Werken lernen, also darf eine KI mit allem dasselbe tun.“
Zwischen menschlichem Lernen und maschinellem Training gibt es Ähnlichkeiten, aber auch entscheidende Unterschiede.
2. Der entscheidende Unterschied: die Skalierung
Ein vielgelesener Mensch kann von Hunderten oder Tausenden Werken geprägt sein. Er erinnert sich unvollständig, verarbeitet Erfahrungen biografisch und kann nur eine begrenzte Zahl neuer Werke schaffen.
Ein modernes generatives KI-System kann dagegen aus sehr großen Datenbeständen statistische Strukturen lernen und anschließend Inhalte mit hoher Geschwindigkeit und in sehr großer Zahl erzeugen. Auch diese Produktion ist durch Rechenleistung, Kosten, Energie und Zeit begrenzt. Bei bestimmten Modellen und Datensituationen kann es außerdem zu einer sehr engen Reproduktion oder Wiedererkennbarkeit von Trainingsinhalten kommen. Die Studie von Carlini und Mitautoren zeigte an GPT-2, dass sich unter gezielten Abfragen einzelne Trainingssequenzen ausgeben ließen. Das ist kein Beleg dafür, dass jedes Modell jedes Trainingswerk jederzeit vollständig wiedergeben kann. Quelle 14
Ethisch relevant ist deshalb nicht nur das Lernen selbst, sondern die Verbindung von Lernen, Reproduzierbarkeit, Automatisierung und Skalierung.
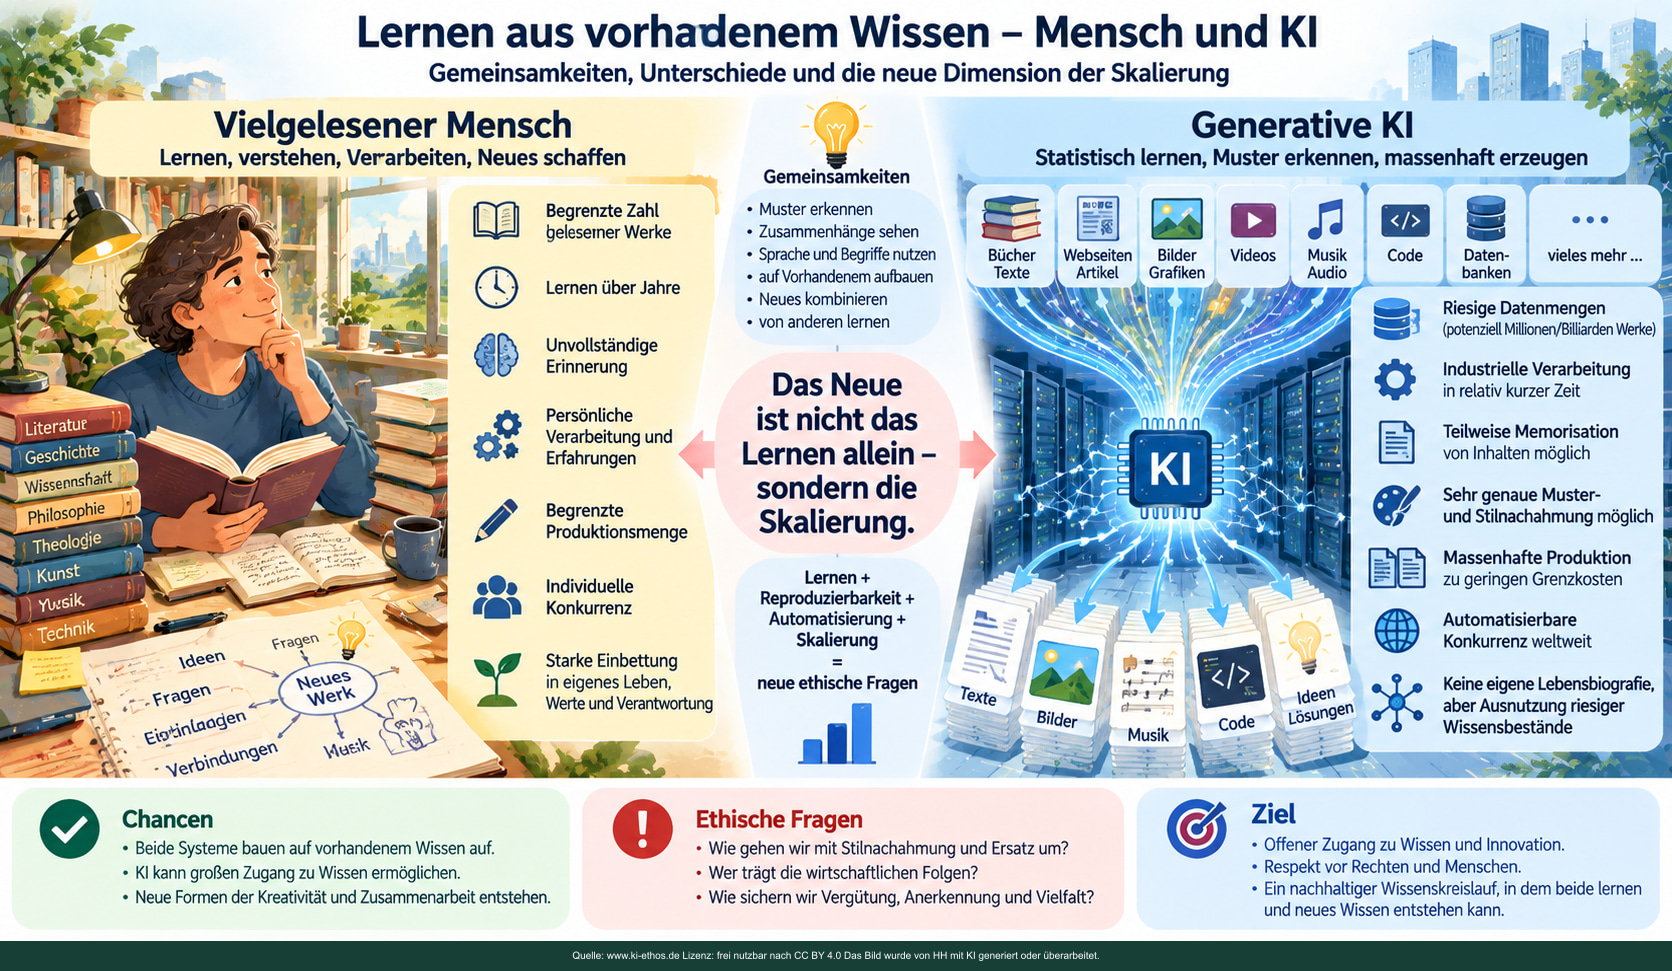
Der Vergleich stellt einen einzelnen Menschen einem technischen System gegenüber. Er bildet keine gesamte menschliche Wissensproduktion ab. Datenmenge und Reproduzierbarkeit unterscheiden sich je nach Modell; genaue Nachahmung ist keine garantierte Fähigkeit.
| Vielgelesener Mensch | Generative KI |
|---|---|
| begrenzte Zahl gelesener Werke | sehr große Datenbestände |
| Lernen über Jahre | industrielle Verarbeitung |
| unvollständige Erinnerung | statistische Verdichtung; in Einzelfällen enge Reproduktion möglich |
| persönliche und biografische Verarbeitung | mathematische Musterverarbeitung |
| begrenzte Produktionsmenge | massenhafte Produktion zu geringen Grenzkosten |
| Konkurrenz bleibt mengenmäßig begrenzt | Konkurrenz kann automatisiert und weltweit skaliert werden |
Das Neue ist nicht das Lernen allein – sondern seine technische und wirtschaftliche Skalierung.
3. Trainingsdaten sind nicht alle gleich
Für eine faire Debatte sollte man verschiedene Datenarten unterscheiden:
Freies und ausdrücklich geteiltes Wissen
Dazu gehören gemeinfreie Werke, offene Daten, geeignete Creative-Commons-Inhalte, Open-Source-Material und andere ausdrücklich freigegebene Bestände. Hier sind viele Konflikte geringer, sofern die jeweiligen Lizenzbedingungen eingehalten werden. Nicht jede offene Lizenz erlaubt jede Verwendung; Bedingungen wie Namensnennung oder nichtkommerzielle Nutzung sowie weitere Rechte müssen berücksichtigt werden.
Öffentlich erreichbare, aber geschützte Werke
Bücher, Zeitungsartikel, Bilder, Musik, wissenschaftliche Texte oder Webseiten können öffentlich zugänglich und trotzdem urheberrechtlich geschützt sein. „Im Internet auffindbar“ bedeutet nicht automatisch „frei von Rechten“.
Lizenzierte hochwertige Daten
Verlage, Archive, Nachrichtenanbieter, Bildagenturen oder andere Rechteinhaber können Inhalte für KI-Nutzung lizenzieren. Das schafft Rechtssicherheit, kann aber für kleine Anbieter teuer sein und zu Marktkonzentration beitragen.
Personenbezogene Inhalte
Hier kommen zusätzlich Datenschutz, Privatsphäre, Persönlichkeitsrechte und gegebenenfalls besondere Schutzinteressen hinzu.
Menschlich erzeugte Trainings- und Bewertungsdaten
Menschen sammeln und säubern Daten, annotieren Bilder, transkribieren Sprache, erstellen Beispielantworten, vergleichen Modellantworten, prüfen Sicherheit und kennzeichnen problematische Inhalte. Diese oft unsichtbare Arbeit ist ebenfalls Teil des Wissenskreislaufs.
4. Rechtlicher Rahmen: Was heute bereits gilt
In Deutschland definiert § 44b UrhG Text- und Data-Mining als automatisierte Analyse digitaler oder digitalisierter Werke zur Gewinnung von Informationen über etwa Muster, Trends und Korrelationen. Vervielfältigungen rechtmäßig zugänglicher Werke sind dafür grundsätzlich zulässig, sofern der Rechteinhaber sich die Nutzung nicht vorbehalten hat; bei online zugänglichen Werken muss ein solcher Vorbehalt maschinenlesbar erfolgen. Nicht mehr erforderliche TDM-Vervielfältigungen sind nach der Vorschrift zu löschen. Ob ein konkretes KI-Training diese Voraussetzungen erfüllt und welche weiteren Rechte berührt werden, ist gesondert zu prüfen; die Vorschrift ist keine pauschale Freigabe aller Internetinhalte oder späterer Ausgaben. Quelle 1
Für Anbieter von General-Purpose-AI-Modellen (GPAI) auf dem Unionsmarkt verlangt der EU AI Act seit dem 2. August 2025 unter anderem eine Strategie zur Einhaltung des europäischen Urheberrechts und eine ausreichend detaillierte öffentliche Zusammenfassung der für das Training verwendeten Inhalte. Quelle 2 Quelle 3 Quelle 13 Seit dem 2. August 2026 verfügt die Europäische Kommission über Durchsetzungsbefugnisse für diese GPAI-Pflichten; für Modelle, die vor dem 2. August 2025 auf den Markt gebracht wurden, gilt die Übergangsfrist bis zum 2. August 2027. Quelle 3 Quelle 4
Die Zusammenfassung nennt Datenarten, Quellen und Verarbeitungsschritte nach der Kommissionsvorlage. Sie ist nicht mit einer vollständigen Liste jedes einzelnen Trainingswerks gleichzusetzen und ersetzt weder Rechteklärung noch eine Einwilligung. Quelle 13
Diese Regelungen lösen aber nicht alle offenen Fragen. Der Initiativbericht des Europäischen Parlaments von Februar 2026 behandelt Transparenz, Rechtevorbehalte, Lizenzierung und Vergütung. Das Parlament beschloss am 10. März 2026 eine Entschließung zu Urheberrecht und generativer KI. Das offizielle Faktenblatt hebt Transparenz der Trainingsdaten, Lizenzierungsmechanismen und faire Vergütung hervor. Wichtig: Bericht und Entschließung sind politische Forderung und Orientierung, keine neue urheberrechtliche Erlaubnis und kein unmittelbar geltendes Vergütungsgesetz. Quelle 5 Quelle 15
Für ein KI-Ethos folgt daraus eine wichtige Unterscheidung:
5. Vom Lernen zur problematischen Aneignung
Nicht jede Nutzung vorhandener Kultur ist gleich problematisch. Hilfreich ist eine Abstufung:
1. Lernen
Die KI erfasst allgemeine Muster, Begriffe, Zusammenhänge oder sprachliche Strukturen. Das steht dem allgemeinen kulturellen Lernen am nächsten.
2. Nachahmung
Die KI erzeugt Inhalte, die einen bestimmten Stil, eine Bildsprache oder charakteristische Merkmale sehr eng nachbilden. Ein abstrakter Stil ist als solcher grundsätzlich kein urheberrechtlich geschütztes Werk. Konkrete schöpferische Gestaltungen und Übernahmen aus Werken müssen davon unterschieden werden; ethisch können dennoch Fragen nach Anerkennung, wirtschaftlicher Wirkung und gezielter Imitation entstehen. Welche Bestandteile einer Gestaltung geschützt sind, hängt unter anderem von ihrer individuellen Schöpfung ab. Quelle 16
3. Substitution
KI-Inhalte ersetzen oder konkurrieren mit Leistungen, für die bislang Autoren, Illustratoren, Übersetzer, Musiker, Programmierer oder andere Fachleute bezahlt wurden. Technischer Fortschritt darf Tätigkeiten verändern. Problematisch wird es, wenn der wirtschaftliche Nutzen systematisch aus den Leistungen einer Gruppe gezogen wird, während deren eigene Existenzgrundlage erodiert und kein angemessener Rückfluss entsteht.
4. Täuschung und Identitätsmissbrauch
Besonders deutlich wird die Grenze, wenn KI-Inhalte bewusst einem realen Menschen zugeschrieben, unter dessen Namen vermarktet oder mit irreführenden biografischen Angaben versehen werden. Dann geht es nicht mehr nur um Lernen aus Kultur, sondern um Täuschung, Vertrauen sowie möglicherweise Urheber-, Namens-, Persönlichkeits-, Marken- oder Wettbewerbsrechte. Plattformen versuchen darauf zu reagieren: Amazon KDP verlangt beispielsweise die Offenlegung KI-generierter Texte, Bilder und Übersetzungen gegenüber Amazon; für nur KI-assistierte Inhalte besteht diese Plattformpflicht dort nicht. Das ist keine allgemeine gesetzliche Kennzeichnungspflicht gegenüber sämtlichen Leserinnen und Lesern. Quelle 12
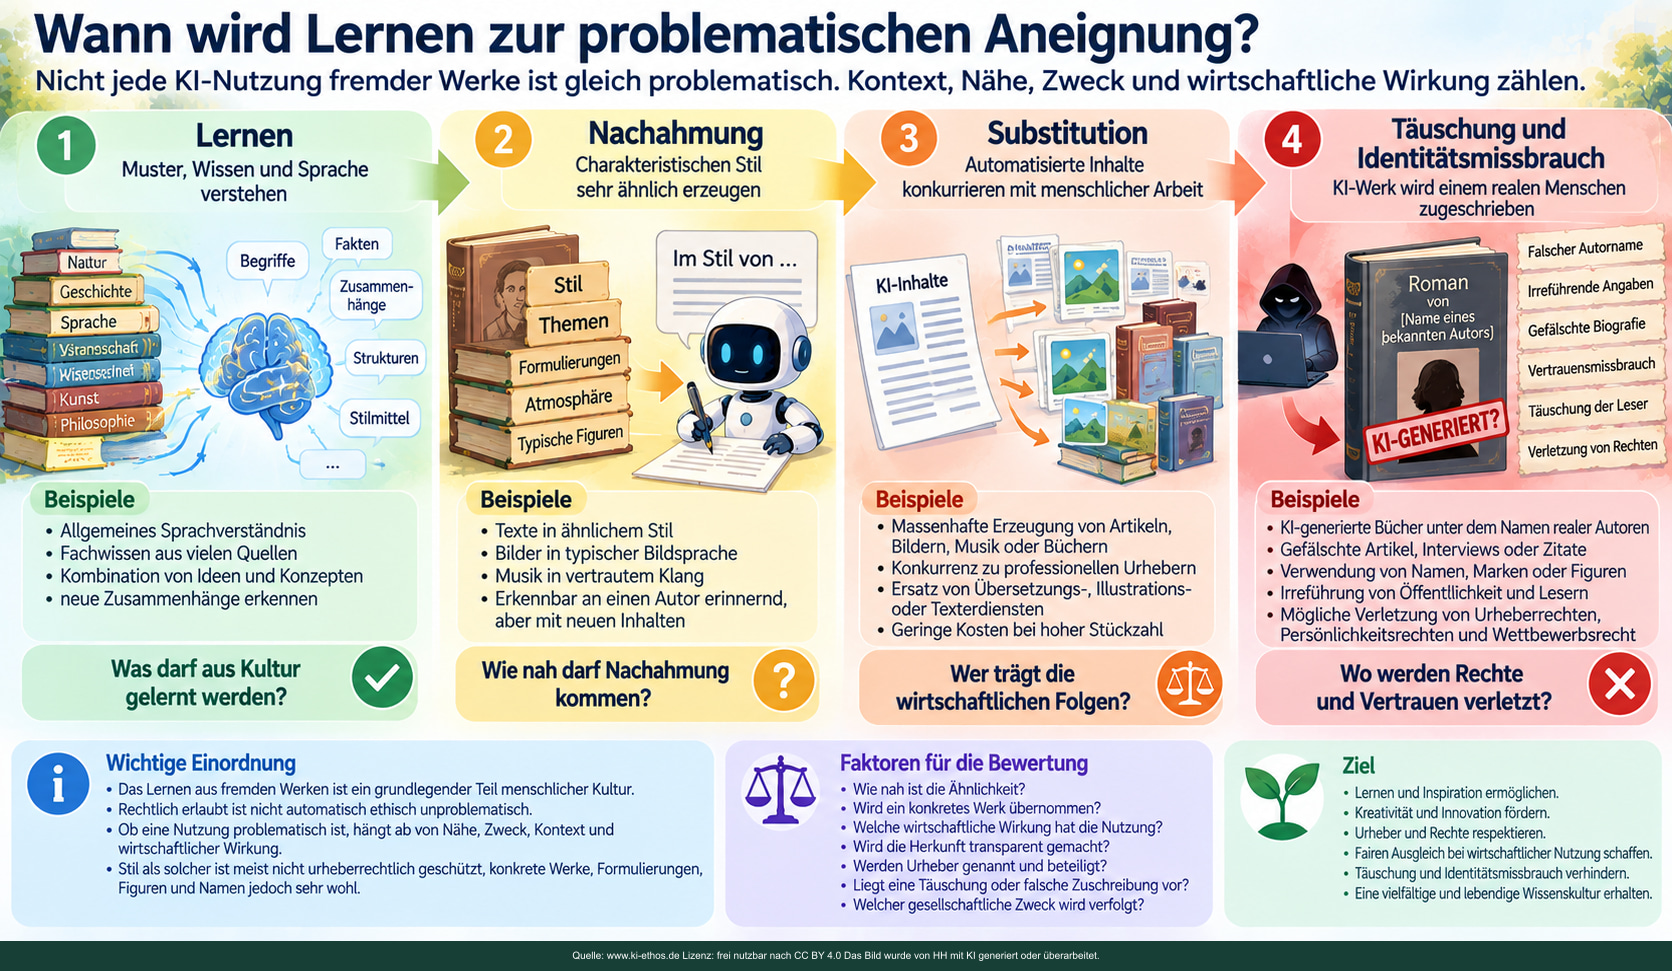
Diese Kategorien sind ethische Orientierung, keine juristische Prüfungsskala. Konkrete Formulierungen und Figuren können je nach Gestaltung geschützt sein; Namen sind nicht automatisch urheberrechtlich geschützt. Namens-, Marken- und Persönlichkeitsrechte können unabhängig davon relevant sein.
Für die ethische Bewertung helfen sechs Fragen:
- Wie nah ist das Ergebnis an einem konkreten Werk?
- Wurde ein Werk oder nur ein allgemeines Muster übernommen?
- Ist die Herkunft transparent?
- Wird ein realer Urheber genannt oder wirtschaftlich beteiligt?
- Welche wirtschaftliche Wirkung hat die Nutzung?
- Liegt eine Täuschung oder falsche Zuschreibung vor?
6. Das eigentliche Problem: der unterbrochene Wissenskreislauf
Der zentrale Konflikt lässt sich ökonomisch als Einbahnstraße darstellen:
Menschen → Werke und Wissen → digitale Archive und Internet → KI-Training → KI-Produkte → wirtschaftlicher Nutzen
Wenn der Prozess hier endet, fließt Wert vor allem in eine Richtung.
Das kann langfristig paradox werden: KI lebt von menschlich erzeugtem Wissen und kann zugleich die wirtschaftlichen Bedingungen schwächen, unter denen neues hochwertiges Wissen, Journalismus, Kunst, Forschung oder Fachliteratur entstehen.
Das Problem sollte deshalb nicht vorschnell mit dem Schlagwort „Die KI stiehlt Wissen“ beschrieben werden. Präziser ist:
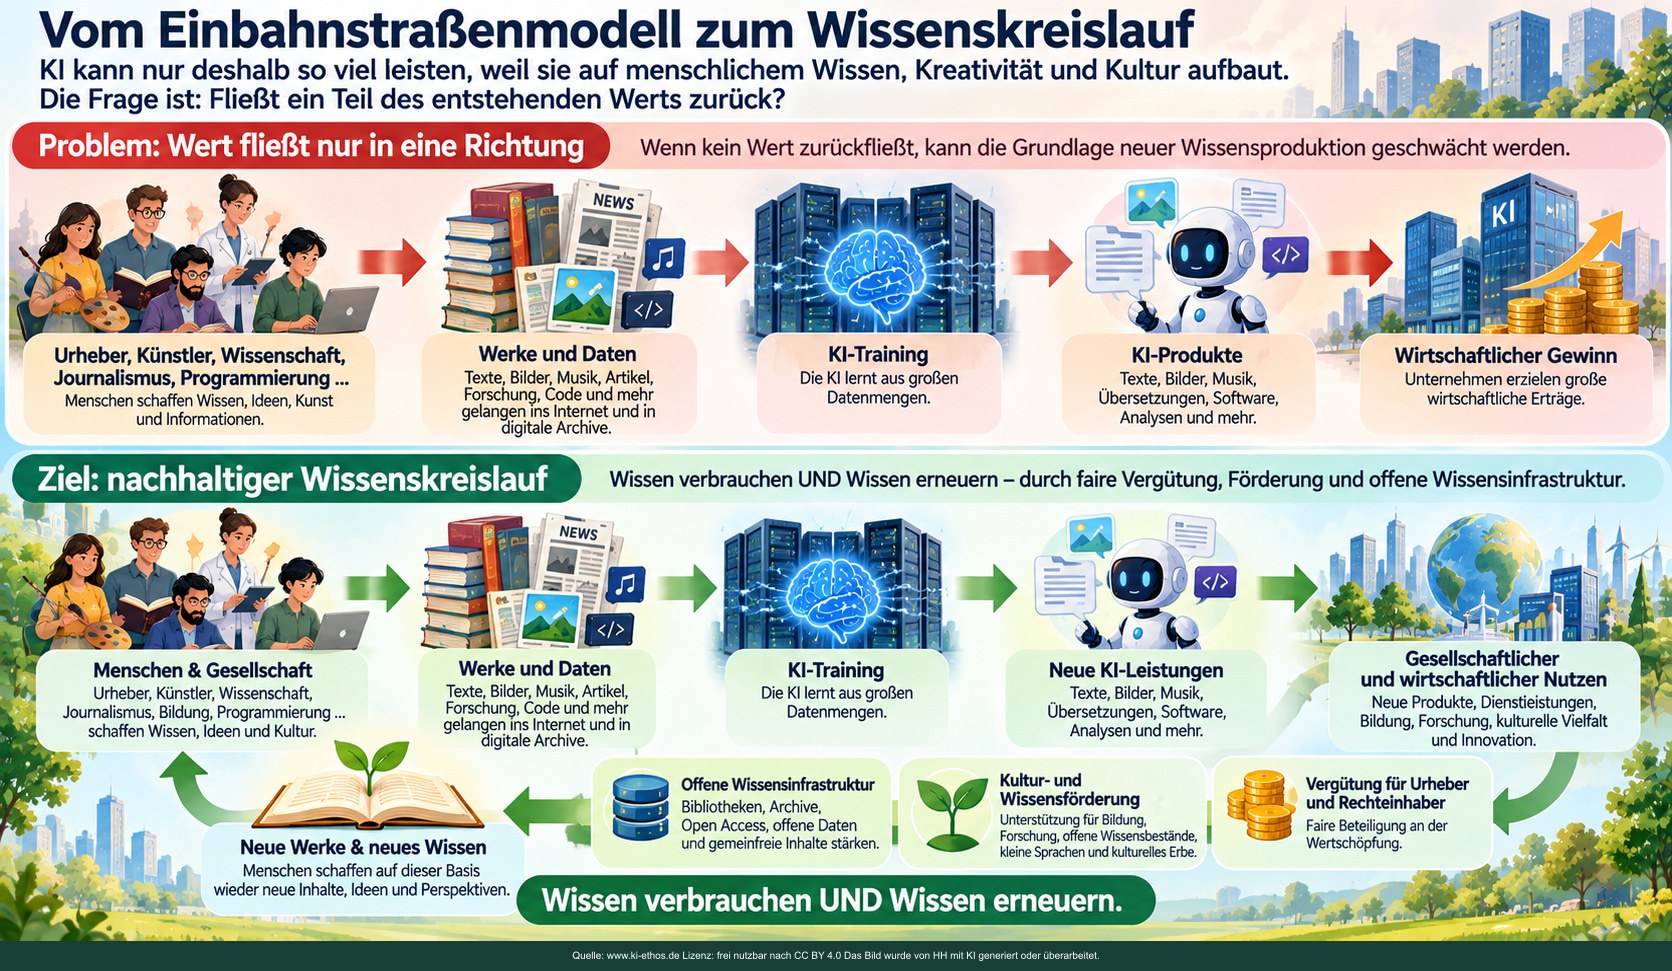
Die Gegenüberstellung beschreibt ein mögliches Problem und ein Gestaltungsziel. Sie behauptet nicht, alle KI-Unternehmen seien profitabel oder bestehende Lizenzzahlungen und andere Rückflüsse fehlten vollständig.
Der nachhaltige Kreislauf ergänzt daher den Rückweg:
wirtschaftlicher und gesellschaftlicher Nutzen → Vergütung + Kultur- und Wissensförderung + offene Wissensinfrastruktur → neue Werke und neues Wissen
Die Leitidee lautet:
7. Wie könnte Wert zurückfließen?
Es gibt wahrscheinlich nicht die eine perfekte Lösung. Sinnvoll erscheint vielmehr ein Bündel verschiedener Instrumente.
A. Direkte Lizenzen
Rechteinhaber und KI-Anbieter schließen konkrete Verträge. Das ist präzise und freiwillig, setzt aber Verhandlungsmacht und Verwaltungsressourcen voraus.
B. Kollektive Lizenzen
Verwertungsgesellschaften oder andere kollektive Einrichtungen können Rechte vieler Urheber bündeln. Das könnte besonders dort sinnvoll sein, wo Millionen Einzellizenzen praktisch nicht handhabbar wären. Der Parlamentsbericht behandelt freiwillige individuelle und kollektive Lizenzierungswege. Ob eine Einrichtung die erforderlichen Rechte tatsächlich vertreten darf, muss für den jeweiligen Bestand geklärt sein. Quelle 5
C. Ein KI-Wertschöpfungsbeitrag
Denkbar wäre ein Beitrag kommerzieller KI-Anbieter, der sich etwa an Umsatz, wirtschaftlicher Nutzung oder anderen geeigneten Größen orientiert. Dies ist ein Diskussionsmodell, kein geltendes Recht.
D. Ein kleiner allgemeiner Digitalbeitrag
Auch eine sehr kleine, breit verteilte Abgabe auf digitale Grundversorgung oder bestimmte digitale Dienste wäre denkbar. Ihr Vorteil wäre die Einfachheit. Ihr Nachteil: Sie bildet die tatsächliche KI-Nutzung nur ungenau ab. Zudem könnte eine pauschale Abgabe Menschen mit niedrigen Einkommen stärker belasten oder über Preise auf Nutzende abgewälzt werden. Zugang zu Bildung und öffentlicher Grundversorgung sollte deshalb geschützt werden; Verwaltung, Verteilung und Kontrolle wären erst auszuarbeiten.
Eine reine Abgabe nach Datenvolumen wäre problematisch. Ein stundenlanger Videostream kann viele Gigabyte übertragen, während ein fachlich außergewöhnlich wertvolles Buch nur wenige Megabyte umfasst. Datenmenge ist nicht gleich geistiger Wert.
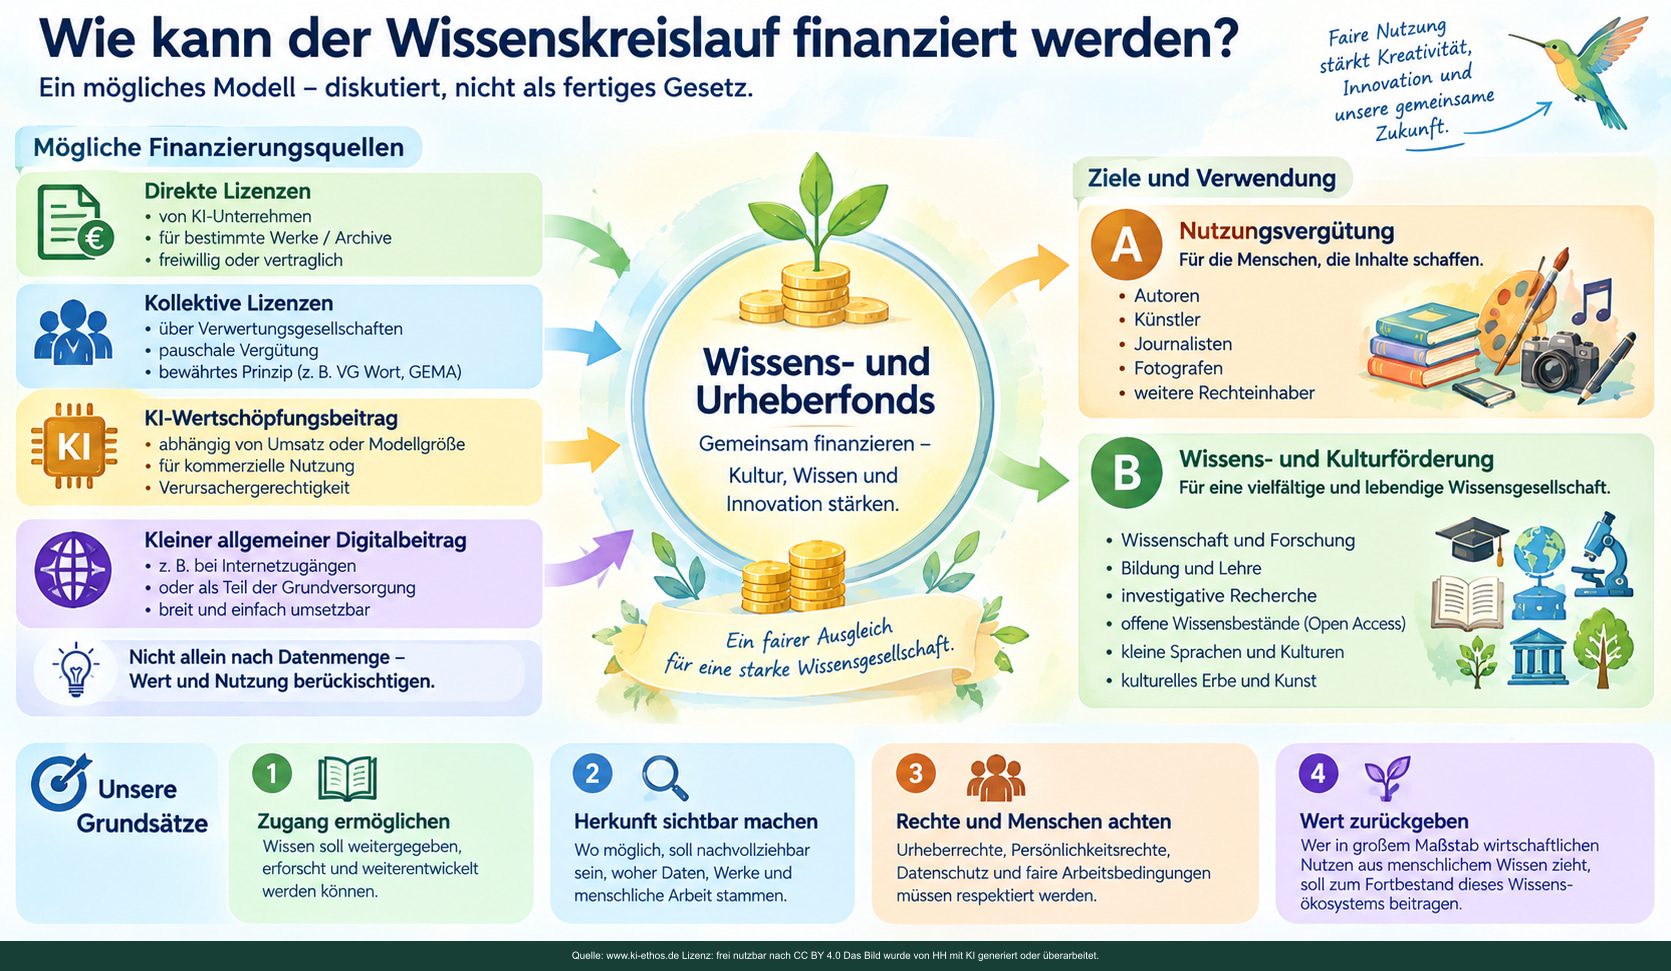
Fonds und zusätzliche Beiträge sind Vorschläge. Die Bildformulierung „einfach umsetzbar“ ist keine geprüfte Machbarkeitsaussage. Zuständigkeit, Bemessung, soziale Belastung, Verwaltung und Verteilung wären zu klären; bestehende Urhebervergütungen legitimieren nicht automatisch eine KI-Abgabe.
Vorbilder für pauschalisierte Vergütung gibt es bereits
Das deutsche Urheberrecht kennt schon heute Situationen, in denen nicht jede einzelne Nutzung individuell abgerechnet wird. § 54 UrhG sieht eine angemessene Vergütung für bestimmte Geräte und Speichermedien vor, wenn mit ihnen erlaubte Vervielfältigungen zu erwarten sind. Quelle 6 § 27 UrhG regelt unter anderem die Vergütung für das öffentliche Verleihen von Werken; bestimmte Ansprüche werden durch Verwertungsgesellschaften wahrgenommen. Quelle 7
Diese bestehenden Modelle sind keine direkte Rechtsgrundlage für eine KI-Abgabe, zeigen aber ein etabliertes Prinzip: Gesellschaftlich erlaubte Massennutzungen können mit kollektiver Vergütung verbunden werden, wenn Einzelabrechnungen unpraktikabel sind.
8. Wohin sollte Geld fließen?
Zwei Zwecke sollten sauber getrennt werden.
1. Nutzungsvergütung
Hier geht es um Rechte und Nutzung. Urheber und andere Rechteinhaber sollen an der wirtschaftlichen Verwertung ihrer Werke beteiligt werden.
2. Wissens- und Kulturförderung
Hier geht es um gesellschaftlich wertvolle Wissensproduktion, die der Markt nicht zuverlässig finanziert. Beispiele:
- Wissenschaft und Forschung,
- Bildung und Lehrmaterial,
- investigative Recherche,
- Open Access und offene Wissensbestände,
- kleine Sprachen und kulturelle Vielfalt,
- Archive und kulturelles Erbe,
- anspruchsvolle Kunst und Literatur.
Diese Förderung darf nicht zu einer zentralen Geschmacks- oder Gesinnungsbehörde werden. Kriterien müssten transparent, plural, überprüfbar und möglichst unabhängig organisiert sein.
Eine kurze Formel dafür lautet:
9. Offenes Wissen bleibt unverzichtbar
Ein nachhaltiger Wissenskreislauf darf nicht in die gegenteilige Fehlentwicklung geraten und Wissen vollständig abschotten.
Wikipedia, Open Source, Open Access, öffentliche Bibliotheken, Creative Commons und frei zugängliche Forschungsdaten zeigen, wie produktiv freiwillig geteiltes Wissen sein kann. Ebenso sind allgemeine Ideen, mathematische Wahrheiten, historische Tatsachen, Wörter und viele kulturelle Grundmuster kein Privateigentum eines Einzelnen.
Darum sollte ein gutes digitales Rechtesystem verschiedene Wünsche möglichst maschinenlesbar ausdrücken können:
- „frei nutzbar“,
- „mit Namensnennung“,
- „nicht kommerziell“,
- „für KI-Training gegen Lizenz oder Vergütung“,
- „nicht für KI-Training“.
Der maschinenlesbare Rechtevorbehalt in § 44b UrhG weist bereits in diese Richtung. Quelle 1
10. Die zweite unsichtbare Grundlage: menschliche Datenarbeit
Die Debatte über Trainingsdaten darf nicht nur auf Autoren, Künstler und Rechteinhaber schauen. Moderne KI beruht auch auf erheblicher menschlicher Arbeit hinter den Modellen.
Menschen:
- sammeln und bereinigen Daten,
- annotieren Bilder und Texte,
- transkribieren und übersetzen Sprache,
- erstellen Beispielantworten,
- vergleichen und bewerten Modellantworten,
- führen Sicherheits- und Missbrauchstests durch,
- moderieren problematische Inhalte,
- melden Fehler und helfen, Systeme zu verbessern.
Die Internationale Arbeitsorganisation ILO beschreibt diese „unsichtbare“ Arbeit als wichtigen Bestandteil des Human-in-the-loop-Modells. Viele solcher Tätigkeiten werden über Crowdwork-Plattformen oder Business-Process-Outsourcing organisiert; ein erheblicher Teil findet im Globalen Süden statt. Die ILO dokumentiert Risiken wie niedrige Einkommen, fehlende soziale Absicherung, unsichere Auftragslagen, automatisierte Ablehnung von Arbeit und – besonders bei der Prüfung verstörender Inhalte – psychische Belastungen. Quelle 8 Quelle 9
Dabei ist wichtig, nicht pauschal zu behaupten, sämtliche Datenarbeiter würden ausgebeutet. Es gibt sehr unterschiedliche Arbeitgeber, Länder, Tätigkeiten und Arbeitsbedingungen. Das strukturelle Problem liegt in Machtgefällen, Intransparenz, Subunternehmerketten und fehlender Verhandlungsmacht, die Ausbeutung begünstigen können.
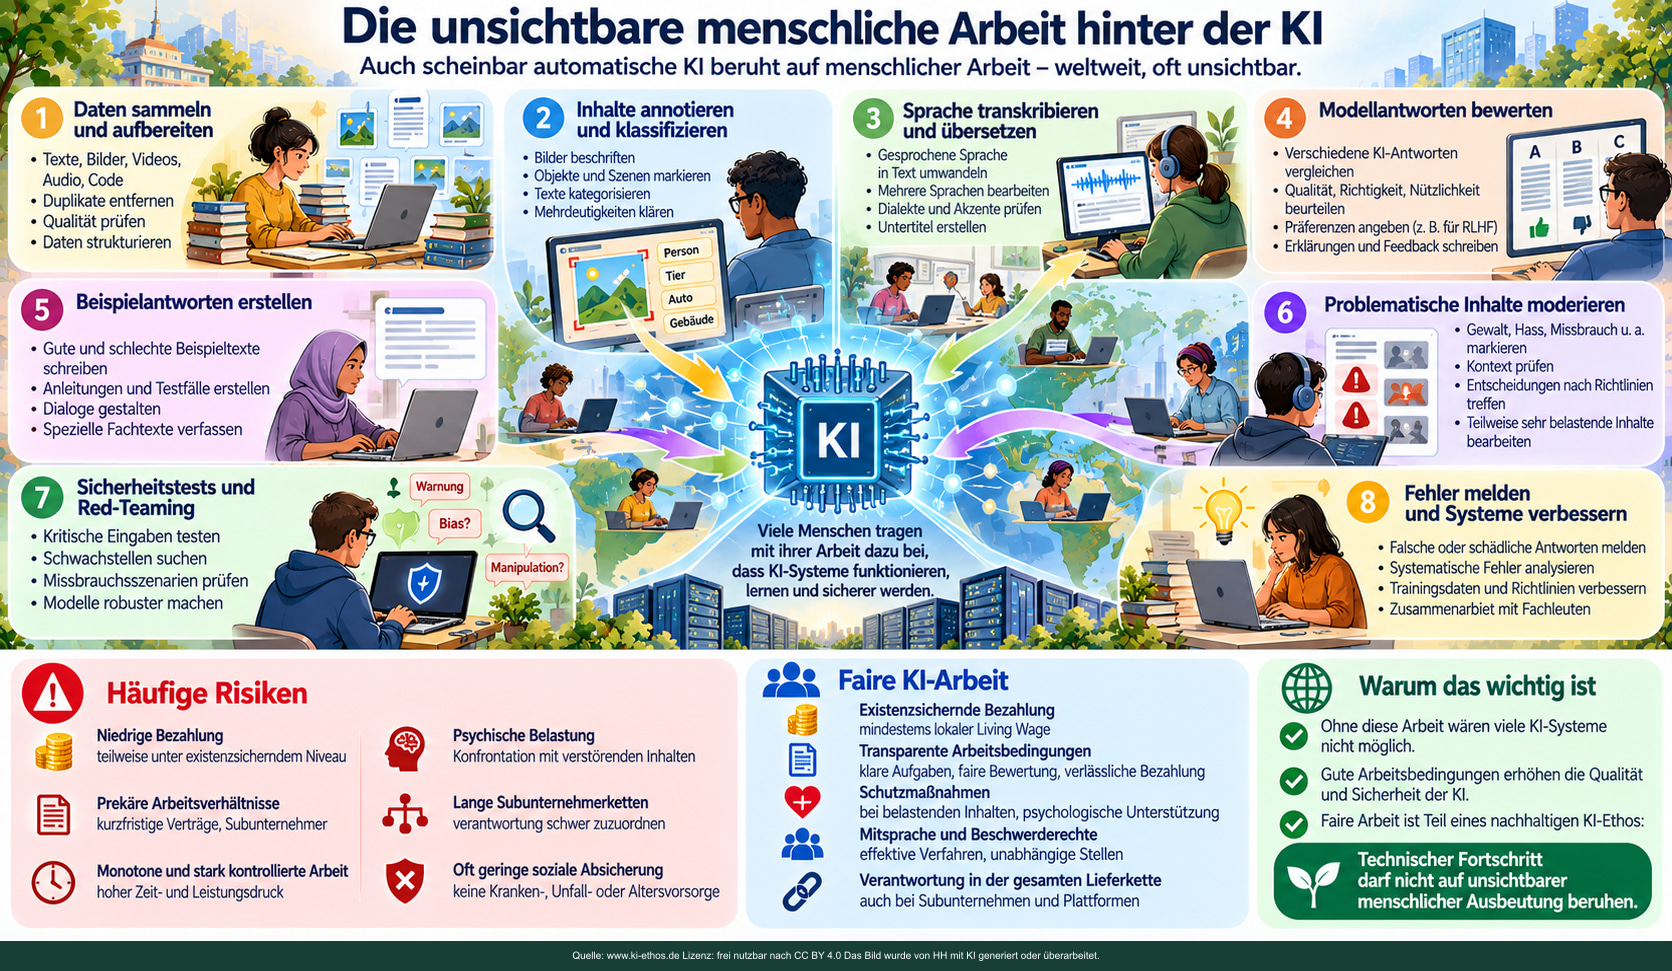
Die Rollen und dargestellten Arbeitsorte sind Beispiele. Risiken und Arbeitsbedingungen variieren nach Tätigkeit und Anbieter. Die Bildformulierung „mindestens lokaler Living Wage“ wird im Text durch die Empfehlung von Partnership on AI zu Bezahlung oberhalb dieses Werts präzisiert.
11. Faire KI-Arbeit
Aus einem KI-Ethos lassen sich für diese Arbeitswelt konkrete Mindestziele ableiten:
Existenzsichernde Bezahlung
Partnership on AI empfiehlt für Data-Enrichment-Arbeit eine Vergütung oberhalb des lokalen Living Wage (lokal berechneter existenzsichernder Lohn) sowie klare Aufgabenbeschreibungen und wirksame Möglichkeiten, Probleme zu melden oder Feedback zu geben. Quelle 10 Quelle 11
Transparente Arbeitsbedingungen
Menschen müssen wissen, wie Aufgaben bewertet werden, wann Bezahlung erfolgt, warum Arbeit abgelehnt wird und an wen sie sich bei Konflikten wenden können.
Schutz vor psychischer Belastung
Wer regelmäßig Gewalt, Missbrauch, Hass oder andere extrem belastende Inhalte prüfen muss, braucht besondere Schutzmaßnahmen, Begrenzungen, Betreuung und die Möglichkeit, bestimmte Aufgaben abzulehnen.
Mitsprache und Beschwerderechte
Automatisierte Plattformentscheidungen dürfen nicht völlig unanfechtbar sein.
Verantwortung in der gesamten Lieferkette
Ein KI-Unternehmen sollte Verantwortung nicht dadurch verlieren, dass Annotation, Moderation oder Tests an mehrere Ebenen von Subunternehmen ausgelagert werden. Verantwortliche Beschaffung muss deshalb die gesamte Daten- und Arbeitslieferkette betrachten. Quelle 10
12. Globale Wissensgerechtigkeit
KI lernt nicht nur von individuellen Urhebern. Sie lernt auch aus Sprachen, kulturellen Traditionen, öffentlich finanzierter Forschung, Archiven, Museen und jahrhundertelang aufgebauten Wissensbeständen.
Dadurch entsteht eine weitere Gerechtigkeitsfrage: Wer profitiert von kollektiv geschaffenem Wissen?
Kleine Sprachen und Kulturen stehen vor einem doppelten Problem. Werden sie kaum in Trainingsdaten berücksichtigt, funktionieren KI-Systeme für ihre Sprecher schlechter. Werden ihre Bestände dagegen ohne Transparenz und Rückfluss kommerziell verwertet, kann wirtschaftlicher Wert außerhalb der Gemeinschaft abgeschöpft werden.
Ein nachhaltiger Wissenskreislauf braucht deshalb sowohl Zugang als auch Teilhabe.
13. Zwei Extreme vermeiden
Extrem 1: Alles frei nehmen
Wenn alles technisch Zugängliche ohne Rücksicht auf Rechte, Herkunft, Vergütung oder Arbeitsbedingungen verwertet wird, entstehen Risiken:
- Vertrauensverlust,
- unfaire Wettbewerbsvorteile,
- Schwächung professioneller Wissensproduktion,
- kulturelle Verarmung,
- prekäre Arbeit hinter den Systemen.
Extrem 2: Alles abschotten
Wenn jede maschinelle Analyse, jedes Training und jede Wissensnutzung individuelle Genehmigungen erfordert, entstehen ebenfalls Probleme:
- hohe Transaktionskosten,
- erschwerter Zugang für Forschung und Bildung,
- Vorteile für finanzstarke Großunternehmen,
- geringere Chancen für kleine KI-Anbieter und gemeinnützige Projekte,
- gebremster Wissensaustausch.
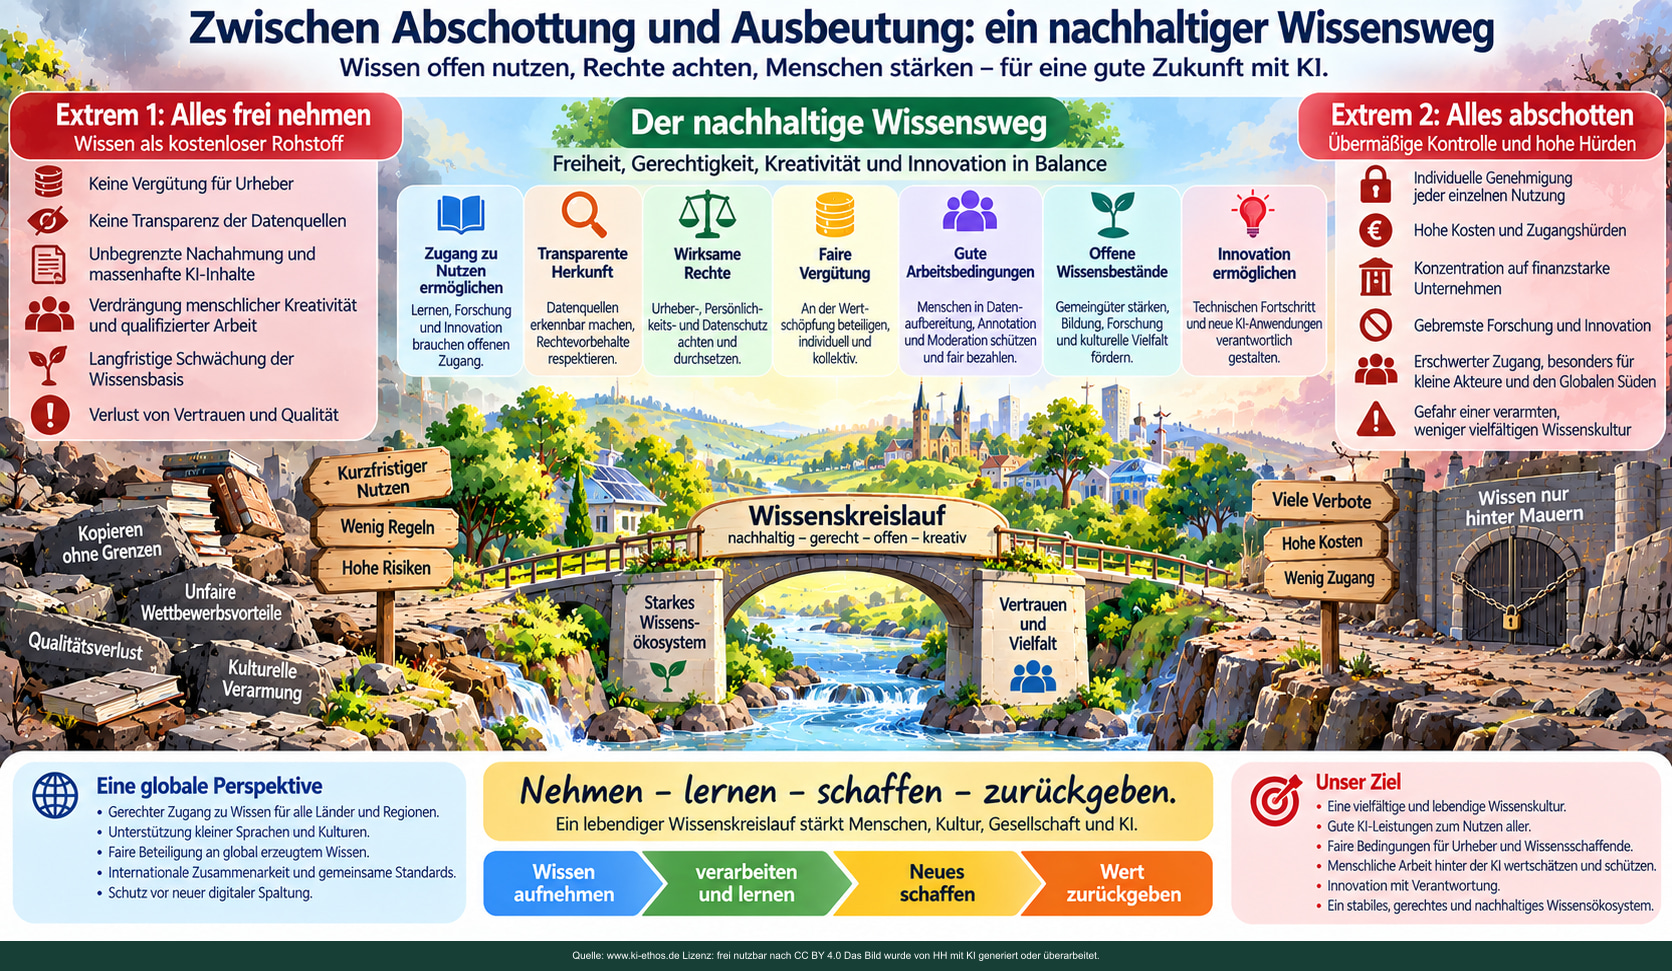
Die beiden Extreme sind didaktische Zuspitzungen. Das Bild belegt weder gleiche Schäden auf beiden Seiten noch einen optimalen Mittelwert. Entscheidend sind konkrete Rechte, faire Bedingungen und nachprüfbare Folgen.
Das Ziel ist kein mathematisch exakter Mittelwert zwischen zwei Extremen, sondern ein funktionierender Ausgleich von Freiheit, Gerechtigkeit, Kreativität und Innovation.
14. Vier Grundregeln des Wissenskreislaufs
1. Zugang ermöglichen
Wissen soll weitergegeben, erforscht, verstanden und weiterentwickelt werden können.
2. Herkunft sichtbar machen
Wo sinnvoll und technisch möglich, soll nachvollziehbar sein, aus welchen Quellen Daten, Werke und menschliche Beiträge stammen.
3. Rechte und Menschen achten
Urheberrechte, Persönlichkeitsrechte, Datenschutz und menschenwürdige Arbeitsbedingungen gehören zusammen.
4. Wert zurückgeben
Wer in großem Maßstab wirtschaftlichen Nutzen aus menschlichem Wissen und menschlicher Datenarbeit zieht, sollte zum Fortbestand des Wissensökosystems beitragen.
15. Ein Wissenskreislauf-Radar für KI-Unternehmen
Dies ist ein Vorschlag für eine Prüfliste, kein eingerichtetes Radar, kein validiertes Punktesystem und keine tatsächliche Unternehmensbewertung. Ethik wird stärker, wenn sie überprüfbar wird. Für Unternehmen und Plattformen könnten beispielsweise folgende Punkte regelmäßig dokumentiert werden:
| Prüffrage | Möglicher Indikator |
|---|---|
| Woher stammen Trainingsdaten? | Transparenzgrad und veröffentlichte Datenkategorien |
| Werden Rechtevorbehalte respektiert? | technische Opt-out-Verfahren und Beschwerdewege |
| Gibt es Lizenzvereinbarungen? | Anteil lizenzierter oder ausdrücklich freigegebener Korpora |
| Fließt Wert an Rechteinhaber zurück? | Umfang von Lizenz- und Vergütungszahlungen |
| Werden offene Wissensbestände unterstützt? | Beiträge zu Open Access, Open Data, Archiven oder Bibliotheken |
| Wie werden Datenarbeiter bezahlt? | Verhältnis zum lokalen Living Wage |
| Gibt es Schutz bei belastenden Inhalten? | Arbeits- und Gesundheitsschutz, Rotationen, Betreuung, Opt-out |
| Können Entscheidungen angefochten werden? | unabhängige Beschwerdeverfahren |
| Gelten Standards auch für Subunternehmen? | Lieferkettenprüfung und Transparenzberichte |
| Werden kleine Sprachen und Kulturen einbezogen? | Sprachabdeckung, lokale Kooperation und Förderung |
16. Schlussgedanke
Wissen ist weder ein Rohstoff, den man grenzenlos abbauen darf, noch ein Besitz, den man vollständig einschließen sollte. Wissen lebt davon, dass es weitergegeben, verstanden, verwandelt und durch neue Erfahrungen ergänzt wird.
Für KI bedeutet das:
Ein nachhaltiges KI-Ethos verbindet daher offene Wissenskultur mit Rechten, fairer Arbeit und Rückvergütung.
Quellen und weiterführende Hinweise
Stand der Prüfung: 2. Oktober 2026. Gesetze und Kommissionsinformationen belegen den Rechtsrahmen; die Parlamentsbeiträge sind politische Positionen. ILO und Partnership on AI erläutern Arbeitsbedingungen beziehungsweise Empfehlungen. Die Finanzierungs- und Radarideen dieser Seite sind eigene Diskussionsmodelle.
Prüfgrenze: Die Parlamentsseiten waren beim Einbau nicht durchgehend als Volltext zugänglich. Die Einordnung stützt sich auf die öffentlich indexierten offiziellen Dokumentangaben und das offizielle Faktenblatt; nicht überprüfte Detailforderungen werden hier nicht als Tatsachen wiedergegeben.
Fragen für die eigene Praxis
- Welche Datenrechte und Herkunftshinweise können wir für ein eingesetztes Modell tatsächlich prüfen?
- Welche Menschen hinter Training, Prüfung und Moderation werden bezahlt und geschützt?
- Welche Rückflüsse stärken Urheber, Forschung, offene Bestände und kleine Sprachen?
- Wer entscheidet über Förderung, und wie bleiben Kriterien und Beschwerden überprüfbar?
- Woran würden wir erkennen, dass eine vorgeschlagene Abgabe ihren Zweck verfehlt?
Herkunft und Weiterarbeit
Grundtext und sieben Schaubilder stammen aus dem von Hans Hufnagel bereitgestellten Paket „KI-Ethos_Wissenskreislauf_KI.zip“. Die Webfassung ergänzt Quellenanker, rechtliche Abgrenzungen und Prüffragen. Sie unterscheidet geltende Regeln, politische Forderungen und eigene Vorschläge. Diese Seite bietet allgemeine Orientierung und prüft keinen konkreten Rechtsfall.
Die Bilder sind KI-Illustrationen. Einzelne Rollenbilder – etwa der männlich dargestellte Leser oder Männer bei technischen Prüfaufgaben – bleiben exemplarisch; Lesen, Kreativität, Fürsorge und technische Kompetenz werden keinem Geschlecht zugeordnet. Die Folge enthält unterschiedliche dargestellte Menschen und Tätigkeiten. Bildtexte können vereinfachen oder Fehler enthalten; konkrete Hinweise stehen direkt bei den Bildern und im geschützten Bildkatalog.
Hinweise zur Übersetzung von Bildtext stehen auf „Bilder in Ihre Sprache übersetzen“.
Verwandte Seiten
- KI, Arbeit und Beschäftigung
- KI-Kluft: Zugang, Teilhabe und digitale Gerechtigkeit
- Ressourcenverbrauch und verantwortliche KI-Nutzung
- KI-Risiken und gesellschaftliche Handlungsfähigkeit
- Wahrheit suchen und Quellen prüfen
- Globale Wissensgrundversorgung: ein utopischer Entwurf für Zugang, freie Lernwege und überprüfbares Können
- Acht Bilder zur Utopie – Bilderbuch Band 4
<< KI-Kluft: Arm, Reich und digitale Gerechtigkeit | KI-Navigation | Globale Wissensgrundversorgung – eine Utopie >>
Zur KI-Übersicht →