KI-Alignment: Sicherheit, Zensur und das Recht auf Mitgestaltung
KI-Navigation | KI-Alignment: Sicherheit, Zensur und Mitgestaltung
Untertitel: Was KI-Systeme wissen, was sie sagen dürfen und wer über ihre Ausrichtung entscheidet
Einordnung: Der Beitrag untersucht technische KI-Steuerung und ihre gesellschaftlichen Wirkungen. Er verbindet KI-Ethik, Quellenkritik und Prüfbarkeit mit den Denkmodellen des Kolibriethos. Wissenschaftliche Befunde, ethische Bewertungen und eigene Gestaltungsvorschläge bleiben unterscheidbar.
Stand der Quellenprüfung: 9. Oktober 2026. Hinweis zum Ausgangsvideo: Anlass war ein YouTube-Beitrag über Alignment. Da der Videoinhalt nicht vollständig unmittelbar geprüft werden konnte, beruhen die nachfolgenden Aussagen zum Forschungsstand auf den aufgeführten Originalarbeiten und öffentlich dokumentierten Richtlinien, nicht auf einer behaupteten wörtlichen Videoauswertung.
1. Das Grundproblem: Wer richtet die KI aus – und woran?
Eine leistungsfähige künstliche Intelligenz kann außerordentlich nützlich sein: Sie erklärt schwierige Sachverhalte, unterstützt bei Forschung und Programmierung, hilft beim Lernen, bei der Gestaltung sozialer Beziehungen und bei der Bearbeitung komplexer Aufgaben. Doch eine leistungsfähige KI kann auch gefährlich werden. Sie kann Irrtümer überzeugend präsentieren, Missbrauch erleichtern, Menschen manipulieren oder bei autonomen Handlungen erheblichen Schaden verursachen.
Deshalb werden KI-Modelle ausgerichtet, englisch aligned (siehe AI Alignment): Man versucht, ihr Verhalten so zu gestalten, dass es bestimmten Zielen, Regeln und Wertvorstellungen entspricht.
Sofort stellen sich aber zwei verschiedene Fragen:
- Technisch: Wie erreicht man, dass ein Modell bestimmte Antworten gibt, verweigert oder bevorzugt?
- Ethisch und politisch: Wer darf bestimmen, welche Antworten erwünscht sind, und nach welchen Maßstäben wird das gerechtfertigt?
Das technische Verfahren allein beantwortet die zweite Frage nicht. Ein Modell kann darauf trainiert werden, gefährliche Anleitungen zurückzuhalten. Ähnliche Verfahren können jedoch eingesetzt werden, um historische Tatsachen zu verschweigen, Kritik an Machthabern auszublenden oder bestimmte wirtschaftliche Interessen zu bevorzugen.
Genau darauf weist das Positionspapier von Sarah Ball und Phil Hackemann (2026) hin: The Alignment Community Is Unintentionally Building a Censor’s Toolkit. Die Arbeit beschreibt Alignment-Techniken als Dual-Use-Technologien: Werkzeuge, die sowohl Schutz als auch Zensur und Manipulation ermöglichen. Die Autoren fordern nicht die Abschaffung von Alignment, sondern öffentliche Kontrolle, nachvollziehbare Tests, Modellvielfalt und ein Bewusstsein für diese doppelte Verwendung. Quelle 1
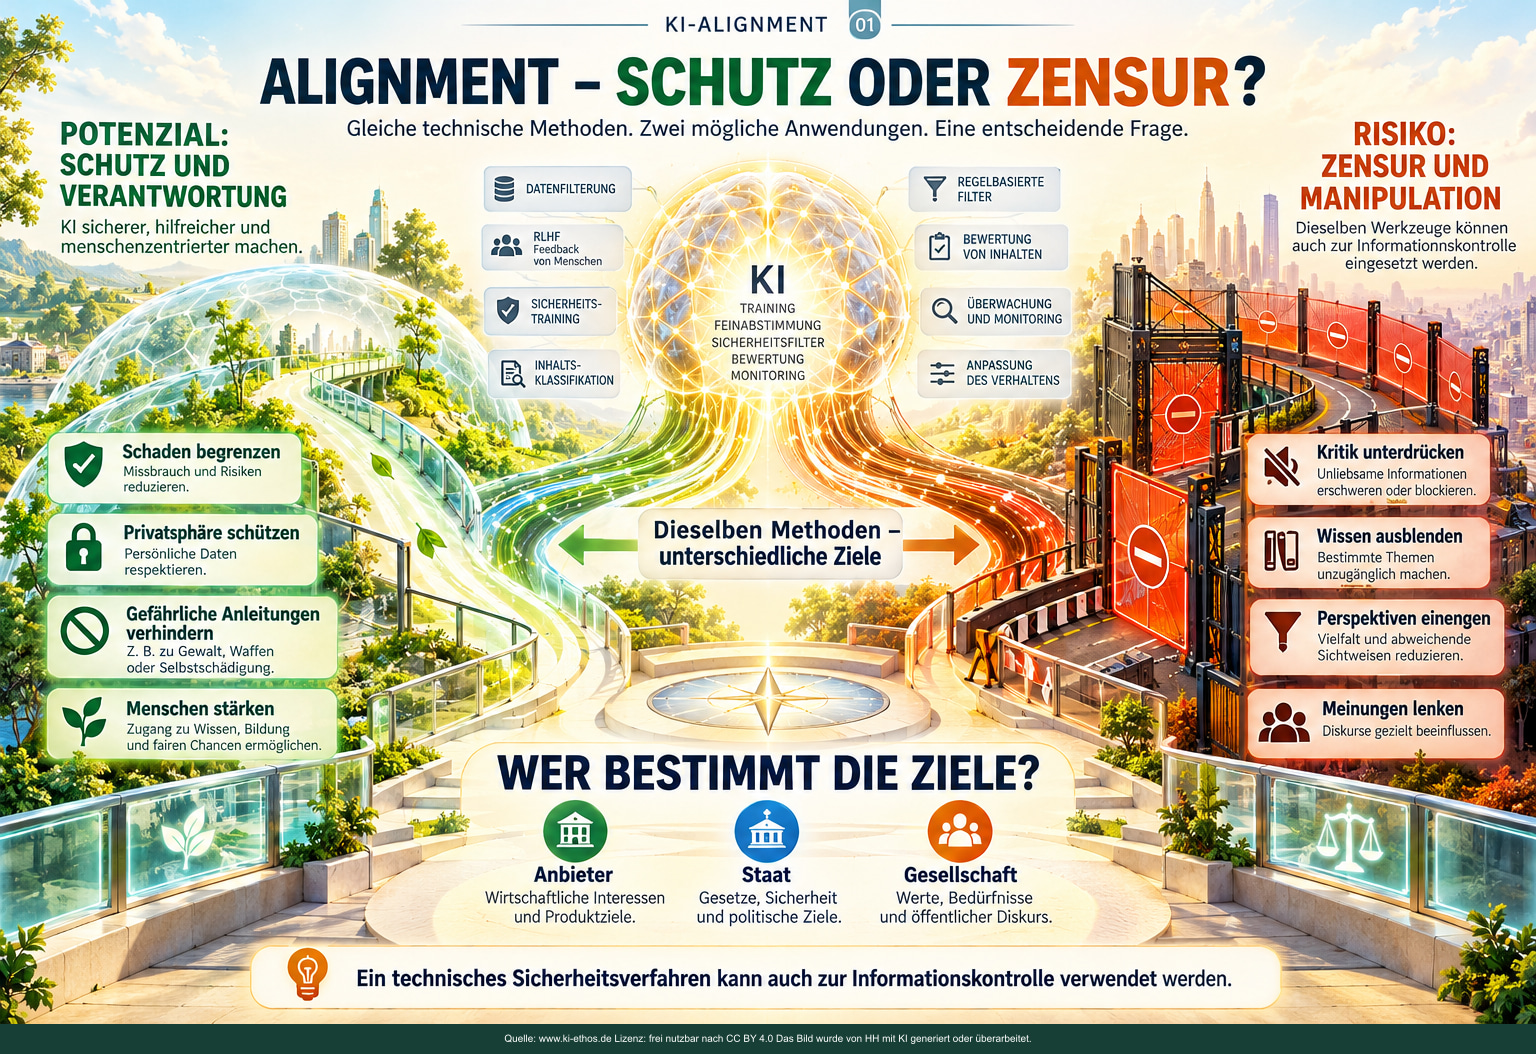
Abbildung 1: Alignment – Schutz oder Zensur?. Bildtexte übersetzen.
Kernaussage: Ein technisches Sicherheitsverfahren kann auch zur Informationskontrolle verwendet werden.
Die Illustration kontrastiert vier legitime Schutzziele – Schaden begrenzen, Privatsphäre schützen, gefährliche Anleitungen verhindern und Menschen stärken – mit vier missbräuchlichen Zielen: Kritik unterdrücken, Wissen ausblenden, Perspektiven einengen und Meinungen lenken. Anbieter, Staat und Gesellschaft können die Zielsetzung beeinflussen.
Einordnung der Tafel: Das Schema zeigt mögliche Verwendungen derselben Verfahrensfamilien. Es belegt weder Manipulation durch einen bestimmten Anbieter noch eine vollständige Trennung von Schutz und Freiheit.
2. Was „Alignment“ bedeutet – und was nicht
Der Begriff hat mehrere Bedeutungen. Diese sollten nicht vermischt werden.
| Begriff | Gemeint ist | Ethische Frage |
|---|---|---|
| Fähigkeit | Was ein Modell grundsätzlich verarbeiten und leisten kann | Welche Fähigkeiten sind förderungswürdig oder riskant? |
| Wissen/Repräsentation | Welche Informationen und Muster im Modell repräsentiert sind | Was wurde gelernt, ausgelassen oder verzerrt? |
| Alignment | Wie das Verhalten auf Ziele, Regeln und Präferenzen ausgerichtet wird | Wessen Ziele und Werte haben Vorrang? |
| Sicherheit | Wie konkrete Schäden verhindert oder begrenzt werden | Welche Schutzmaßnahmen sind erforderlich und verhältnismäßig? |
| Zensur | Unzulässige oder ungerechtfertigte Unterdrückung von Informationen oder Ausdrucksmöglichkeiten | Wann wird Schutz zur Kontrolle des Sagbaren? |
| Personalisierung | Anpassung an die Arbeitsweise und Präferenzen von Benutzern | Welche Entscheidungsmacht sollten Benutzer besitzen? |
| Prüfbarkeit | Systematischer Nachweis von Eigenschaften und Verhaltensgrenzen | Wer darf kontrollieren und wie unabhängig? |
Eine höfliche, freundliche und respektvolle KI ist damit noch nicht notwendigerweise wahrheitsorientiert. Eine häufig verweigernde KI ist nicht zwangsläufig sicherer. Und eine KI, die sehr selbstbewusst formuliert, muss deshalb nicht über besseres Wissen verfügen.
Wichtig: Alignment ist kein einheitlicher Mechanismus. Es umfasst viele unterschiedliche Verfahren, die in verschiedenen Phasen der Modellentwicklung und Nutzung eingreifen.
3. Vier konkrete Eingriffspunkte
Ball und Hackemann gliedern die technische Steuerung in drei Hauptphasen: Pre-Training, Post-Training und Inference-Time. Für Benutzer ist es hilfreich, die dritte Phase noch in Anweisungen und technische Kontrollen aufzugliedern. Quelle 1
3.1 Auswahl und Filterung der Trainingsdaten
Schon vor dem Training wird entschieden, welche Texte und Daten berücksichtigt werden. Berechtigt ist etwa, personenbezogene Daten zu schützen, Duplikate zu entfernen oder nachweislich schädliche Daten zu bereinigen. Problematisch wird die Auswahl, wenn ganze kulturelle Perspektiven, kritische Berichte oder politisch unerwünschte Informationen systematisch fehlen.
Wird eine Information nie gelernt, kann sie dem Modell später tatsächlich fehlen. Allerdings ist ein fehlender Eintrag im Trainingskorpus kein Beweis, dass das Modell keinerlei verwandtes Wissen ableiten oder aus anderen Quellen rekonstruieren könnte.
3.2 Nachtraining: erwünschtes Antwortverhalten lernen
Nach dem Basistraining werden Modelle häufig auf hilfreiches, wahrheitsgemäßes und möglichst schadensarmes Verhalten trainiert. Dazu gehören beaufsichtigtes Nachtraining, menschliches Feedback, Präferenzoptimierung und Verfahren, die explizite Prinzipien berücksichtigen.
So verändert sich nicht nur eine äußerliche Antwortregel. Das Nachtraining kann die Modellgewichte und die internen Repräsentationen selbst verändern. Trotzdem kann früher gelerntes Wissen teilweise erhalten bleiben, obwohl seine direkte Ausgabe nun seltener oder unmöglich erscheint.
3.3 System- und Entwickleranweisungen
Während der Benutzung können zusätzliche, höher priorisierte Anweisungen gelten. Sie bestimmen beispielsweise Rolle, Antwortstil, zugelassene Funktionen und Grenzen der Hilfestellung. Solche Anweisungen können verändert werden, ohne dass das Basismodell neu trainiert werden muss.
Sie sind eine wichtige Ebene legitimer Steuerung – aber auch eine mögliche Ebene verdeckter Einflussnahme.
3.4 Ausgabekontrollen und externe Filter
Zusätzliche Systeme können Eingaben oder Ausgaben klassifizieren und sperren. Ein Modell kann etwa einen Inhalt intern verarbeitet haben, während der Benutzer nur eine Ablehnung oder einen veränderten Text sieht. Ob und wo solche Kontrollen eingesetzt werden, hängt von der konkreten Architektur ab.
| Eingriff | Mögliche Wirkung | Kann die Information trotzdem vorhanden sein? |
|---|---|---|
| Trainingsdaten gefiltert | Wissen wird unter Umständen nicht ausreichend gelernt | Vielleicht in anderer Form oder durch Ableitung |
| Nachtraining | Antwortwahrscheinlichkeiten und interne Muster ändern sich | Häufig teilweise, aber nicht garantiert |
| Laufende Anweisung | Wissen wird im gegebenen Kontext nicht ausgegeben | Sehr wohl möglich |
| Externer Filter | Eine erzeugte oder geplante Ausgabe wird abgefangen | Ja, im Modell oder Zwischenschritt möglich |
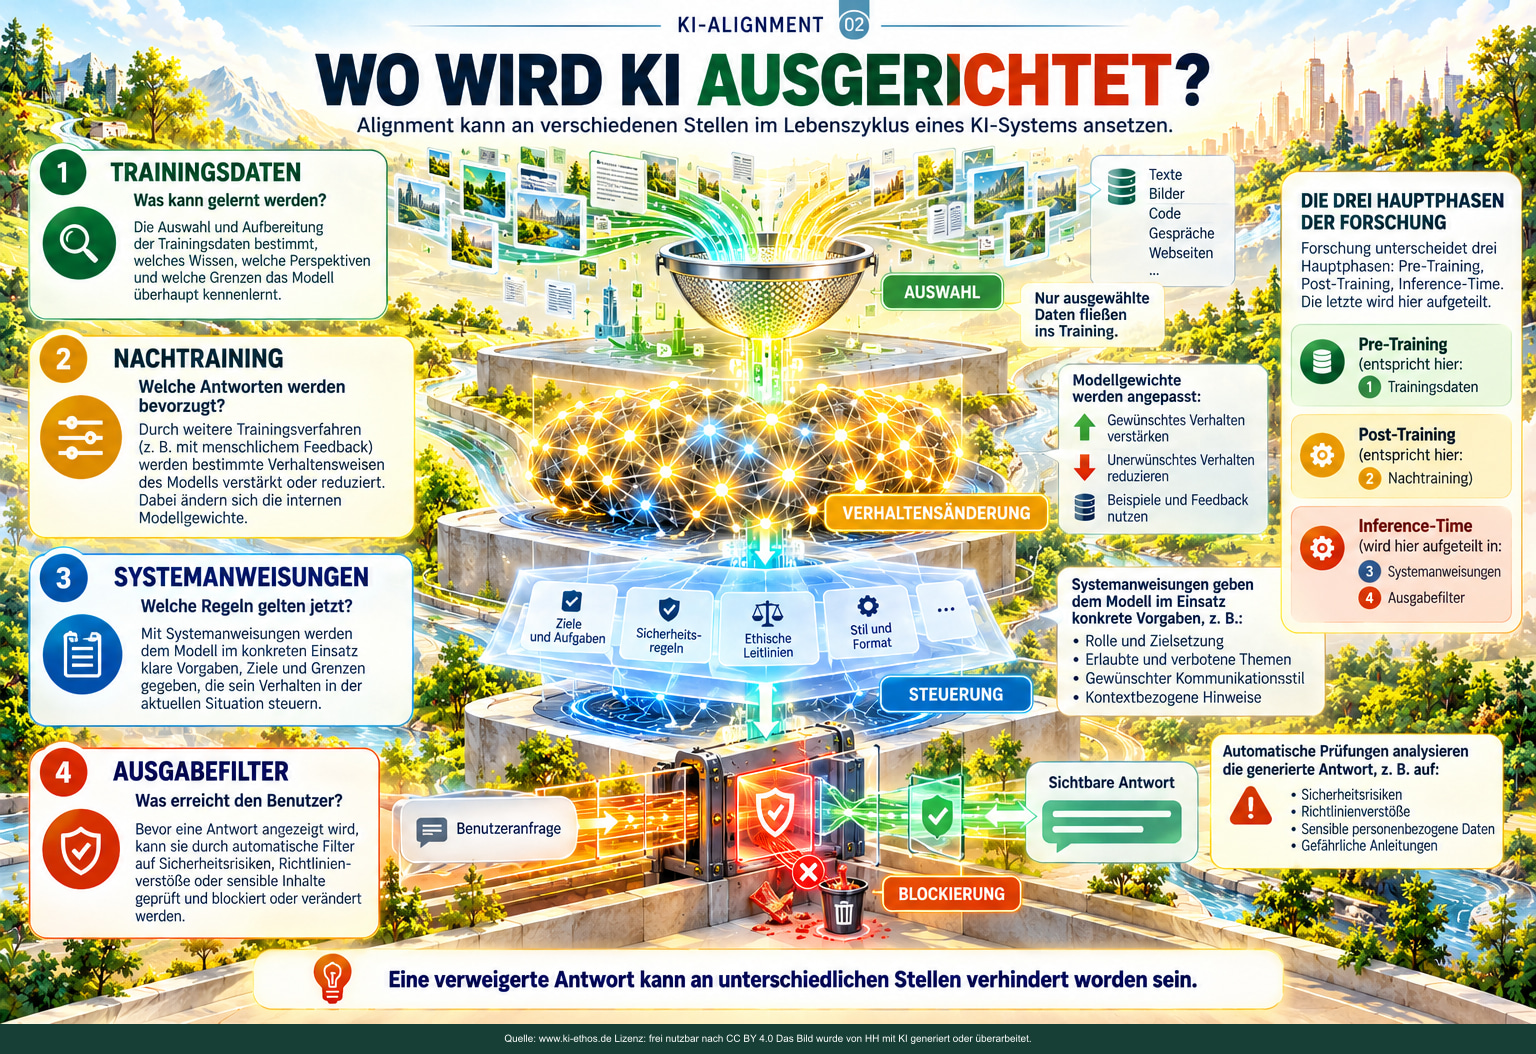
Abbildung 2: Die vier Eingriffspunkte des Alignments. Bildtexte übersetzen.
Kernaussage: Eine verweigerte Antwort kann an unterschiedlichen Stellen verhindert worden sein.
Das Bild erläutert Pre-Training als Datenauswahl, Post-Training als Änderung von Modellgewichten und Inference-Time als Zusammenspiel von laufenden Anweisungen und möglichen Ausgabefiltern. Fehlende, unterdrückte und gefilterte Antworten dürfen nicht verwechselt werden.
Einordnung der Tafel: Drei Entwicklungsphasen werden hier in vier Eingriffspunkte aufgegliedert. Die Anordnung ist vereinfacht: Systeme können Kontrollen auch vor der Generierung oder an mehreren Stellen einsetzen.
4. Das verborgene Wissen: Verloren, verdrängt oder nur nicht ausgesprochen?
Hier liegt eine besonders wichtige wissenschaftliche und philosophische Frage.
Wir können mindestens vier Zustände unterscheiden:
A. Nicht gelernt: Ein Modell verfügt nicht über die nötigen Informationen, weil diese fehlen oder nur unzureichend vertreten waren.
B. Gelernt, aber schwer zugänglich: Ein Muster ist intern vorhanden, kann aber durch eine konkrete Frage nicht zuverlässig aktiviert werden.
C. Intern repräsentiert, jedoch in der Antwort unterdrückt: Das Modell verarbeitet einschlägige Informationen, gibt sie aber aufgrund gelernter Verweigerungsmechanismen oder anderer Regeln nicht direkt aus.
D. Ausgegeben und anschließend abgefangen: Ein separates Kontrollsystem verhindert, dass der Benutzer den Inhalt erhält.
Die äußerlich sichtbare Antwort „Dazu kann ich nichts sagen“ beweist keinen dieser Zustände eindeutig.
4.1 Was die Forschung tatsächlich belegt
Aryan Shrivastava und Ari Holtzman untersuchten 2025 das verweigerte Wissen in ausgerichteten Sprachmodellen. Mithilfe sogenannter linear probes – Verfahren, die Informationen aus internen Aktivierungsmustern auslesen – konnten sie bei den untersuchten Modellen bestimmte Informationen rekonstruieren, deren direkte Ausgabe verweigert wurde. Sie fanden auch Hinweise, dass entsprechende interne Repräsentationen das Verhalten bei verwandten Aufgaben indirekt beeinflussen. Quelle 2
Andy Arditi und Mitautoren zeigten 2024 bei einer Auswahl offen zugänglicher Sprachmodelle, dass Verweigerungsverhalten teilweise mit einem relativ gezielt identifizierbaren Aktivierungsmuster zusammenhängt. Das verdeutlicht, dass eine Verweigerung nicht dasselbe ist wie das Fehlen der zugrunde liegenden Fähigkeit. Die konkrete Mechanik darf jedoch nicht verallgemeinert werden: Nicht jede Sicherheitsgrenze jedes Modells beruht auf demselben Mechanismus. Quelle 3
4.2 Was daraus nicht folgt
- Es ist nicht bewiesen, dass unterdrücktes Wissen immer vollständig erhalten bleibt.
- Ein linearer Decoder zeigt bestimmte rekonstruierbare Eigenschaften, nicht den vollständigen „Gedankeninhalt“ eines Modells.
- Ein Sprachmodell besitzt kein ordentlich abgelegtes geheimes Buch mit allen verbotenen Antworten.
- Die Befunde rechtfertigen keine Behauptung, eine KI verfüge über ein menschliches Unbewusstes.
- Sie beweisen auch nicht, dass alle Antwortgrenzen wirkungslos seien.
Rekonstruierbar bedeutet nicht sachlich wahr: Eine Probe kann gelernte Assoziationen und Verzerrungen eines Modells auslesen. Sie bestätigt damit nicht die Richtigkeit der rekonstruierten Aussage. Quelle 2
Die Ergebnisse legen aber eine differenzierte Feststellung nahe:
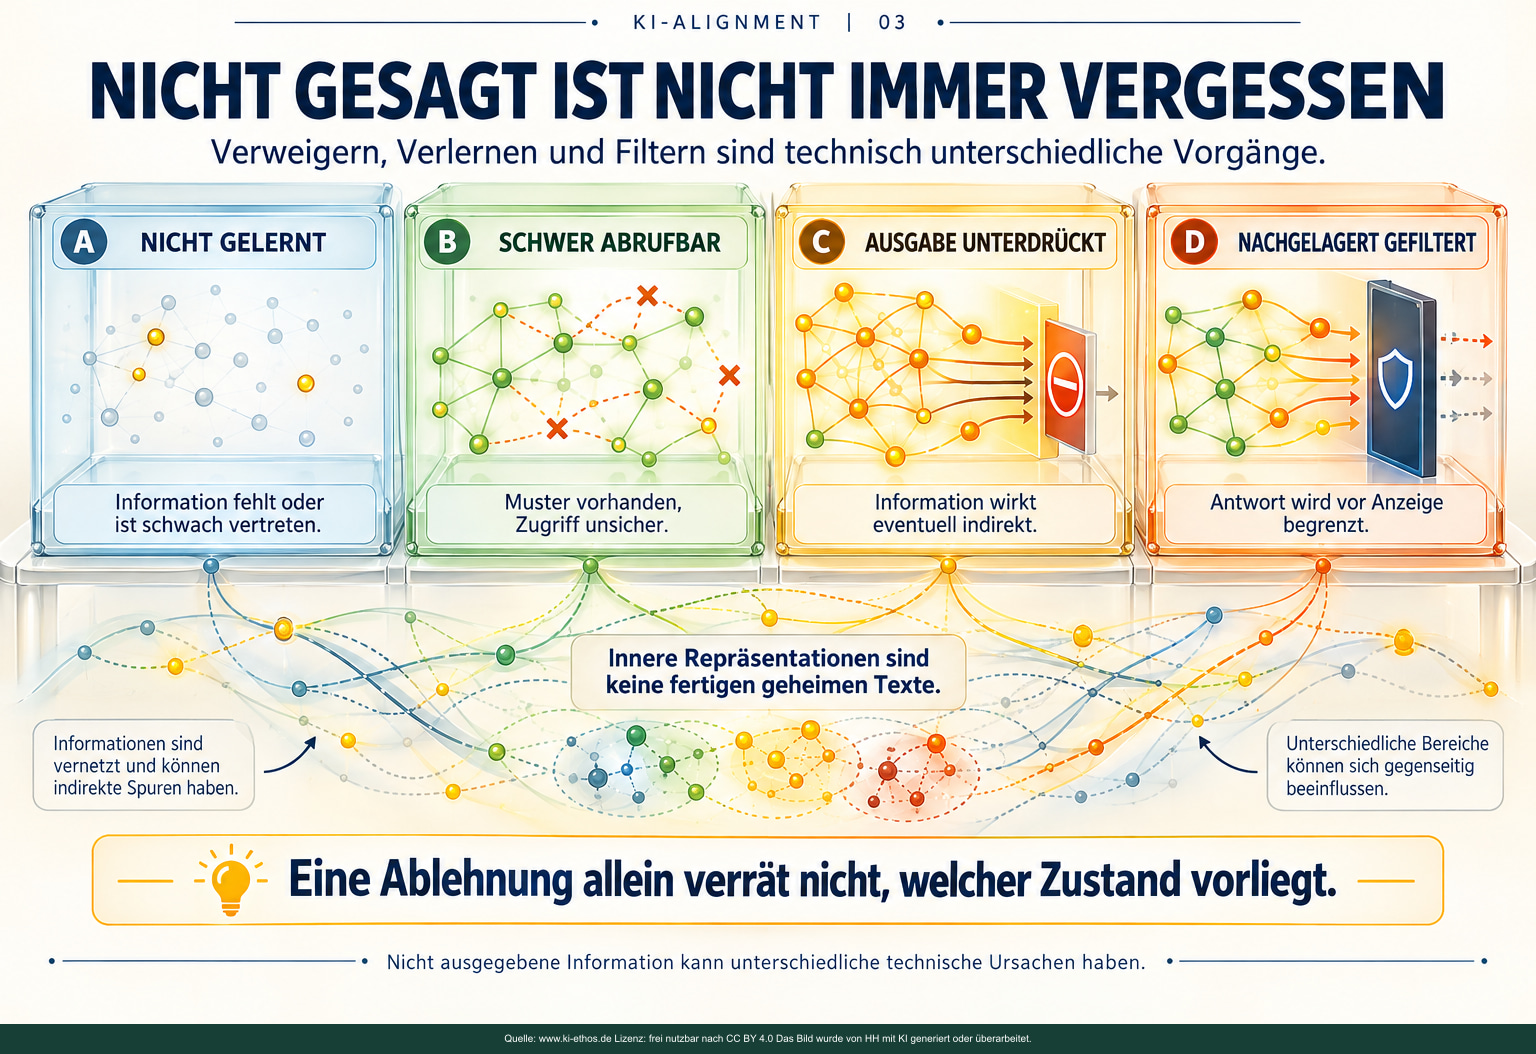
Abbildung 3: Nicht gesagt ist nicht immer vergessen. Bildtexte übersetzen.
Kernaussage: Verweigern, Verlernen und Filtern sind technisch unterschiedliche Vorgänge.
Informationen fehlen oder sind schwach repräsentiert. B: vorhandene Muster lassen sich nicht zuverlässig abrufen. C: intern repräsentierte Informationen werden in der Ausgabe unterdrückt und können möglicherweise indirekt wirken. D: eine nachgelagerte Kontrolle begrenzt die Anzeige. Interne Repräsentationen sind keine vollständigen geheimen Texte.
Einordnung der Tafel: Die Kammern sind ein Denkbild, keine räumlichen Teile eines Modells. Rekonstruierbare Modellassoziationen sind nicht automatisch wahre Tatsachen; Verweigerung belegt weder vollständiges Vergessen noch vollständige Erhaltung.
5. Die unsichtbare Auswahl: Manipulation ohne ausdrückliche Verweigerung
Noch subtiler als eine offen ausgesprochene Ablehnung ist die Auswahl dessen, was in einer Antwort überhaupt vorkommt.
Ein Sprachmodell muss fortlaufend entscheiden oder statistisch gewichten:
- Welche Gesichtspunkte sind für die Frage wesentlich?
- Welche Begriffe beschreiben den Sachverhalt?
- Welche Ereignisse und Quellen sind relevant?
- Welche Einwände werden erwähnt, welche weggelassen?
- Welche Sicherheit wird suggeriert?
- Welche Antwort erscheint als angemessen, konstruktiv oder unerwünscht?
Diese Auswahl kann durch Trainingsdaten, Nachtraining, Systemregeln und den Gesprächskontext geprägt sein. Einseitigkeit kann absichtlich entstehen, aber auch unbeabsichtigt, beispielsweise durch gesellschaftliche Dominanz bestimmter Sprachen, Quellen und Institutionen.
Ein vereinfachtes Beispiel
Frage: „Welche Folgen hatte diese umstrittene politische Entscheidung?“
- Selektiv beschönigende Antwort: Nennt ausschließlich behauptete Erfolge.
- Selektiv verurteilende Antwort: Nennt ausschließlich dokumentierte Nachteile.
- Scheinbar neutrale Antwort: Vermischt gut belegte Fakten und unbelegte Positionen ohne erkennbare Gewichtung.
- Kritisch-aufklärende Antwort: Trennt überprüfbare Folgen, unterschiedliche Bewertungen, Evidenzgrade und offene Fragen.
Die vier Antworten können höflich und flüssig sein. Nur die letzte gibt dem Benutzer genügend Orientierung, um selbst zu urteilen.
Daraus folgt: Eine KI kann den Informationsraum beeinflussen, ohne ein einziges Mal ausdrücklich „Das darf ich nicht sagen“ zu antworten. Das ist eine analytische Folgerung und kein Nachweis verdeckter Manipulation bei jeder konkreten Antwort.
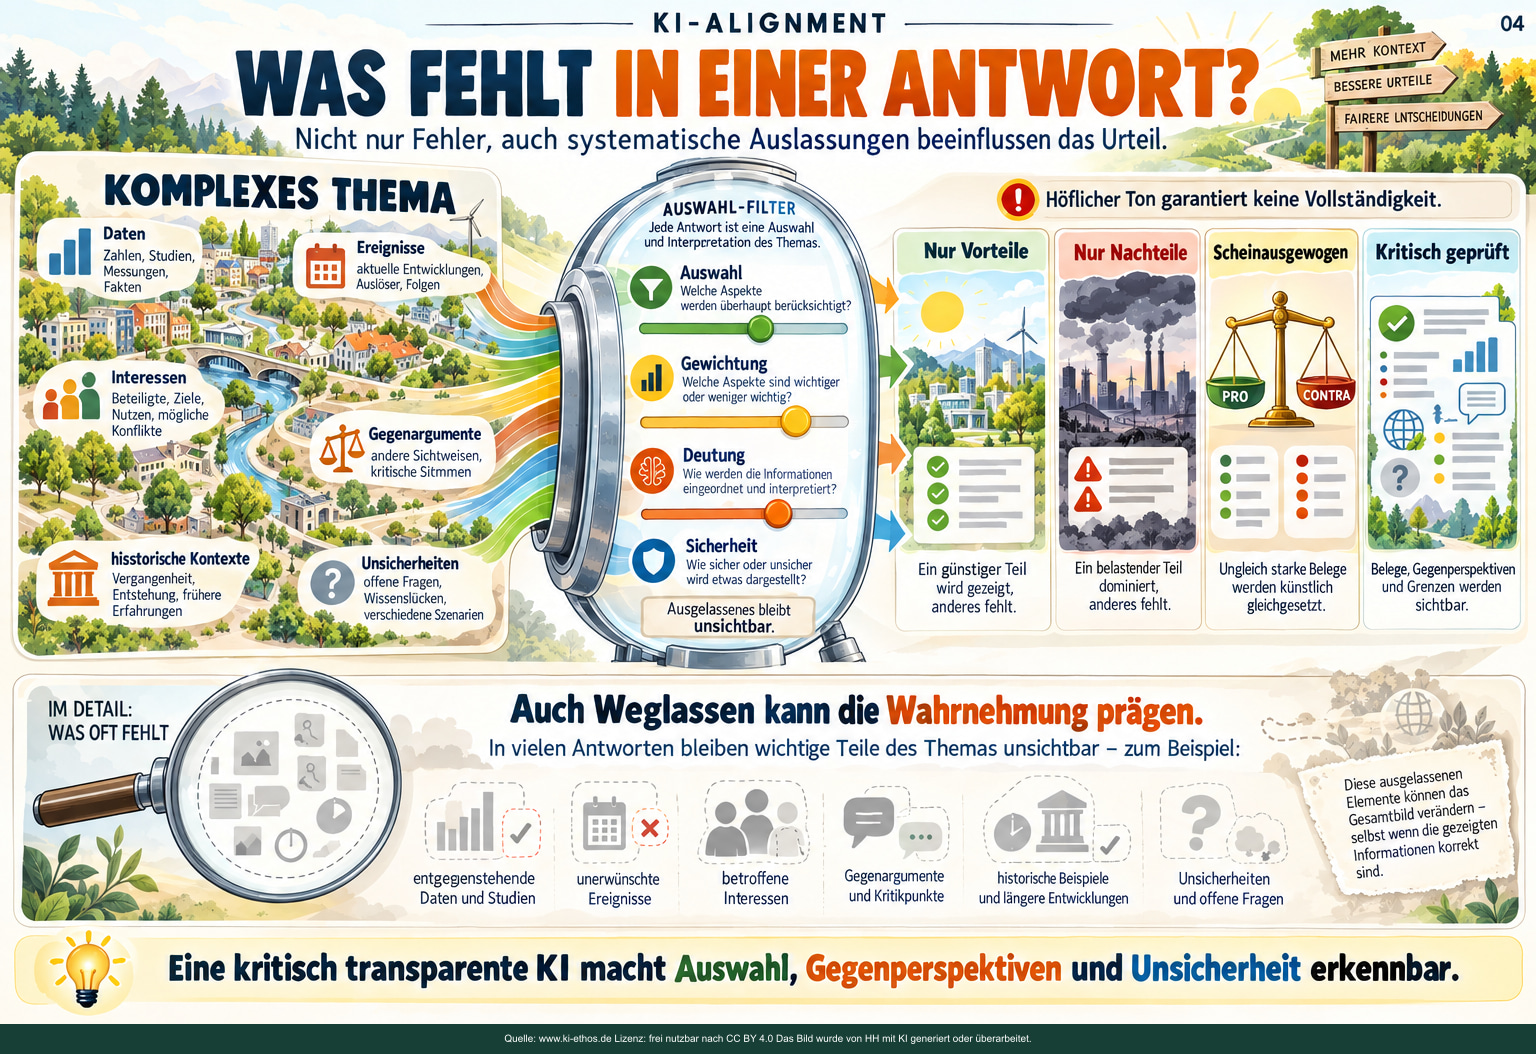
Abbildung 4: Was fehlt in einer Antwort?. Bildtexte übersetzen.
Kernaussage: Nicht nur Fehler, auch systematische Auslassungen beeinflussen das Urteil.
Die Grafik veranschaulicht, wie Auswahl, Gewichtung und Deutung der Informationen verschiedene Antworten erzeugen können. Weggelassene Daten, Gegenargumente, Interessen und Unsicherheiten beeinflussen das Urteil selbst dann, wenn die gezeigten Einzelinformationen korrekt sind.
Einordnung der Tafel: Das Beispiel vergleicht mögliche Darstellungen, keine gemessenen Antworten bestimmter Systeme. Auch eine kritische Antwort kann etwas übersehen; Gegenpositionen müssen nach ihrer Beleglage gewichtet werden.
6. Sicherheit oder Zensur? Die schwierige Grenzziehung
Nicht jede Beschränkung ist Zensur. Ein System darf und soll beispielsweise verhindern, dass es bei konkreten Gewalttaten oder gezielten Angriffen Hilfestellung leistet. Datenschutz und die Wahrung der Rechte Dritter erfordern ebenfalls Grenzen.
Es wäre aber ein schwerwiegender Missbrauch, wenn unter dem Etikett „Sicherheit“ belegte historische Tatsachen, legitime politische Kritik oder unliebsame wissenschaftliche Ergebnisse systematisch ausgeblendet würden.
| Situation | Eine mögliche legitime Reaktion | Problematische Reaktion |
|---|---|---|
| Anfrage nach praktischen Gewalttaten | Konkrete Anleitung ablehnen, ungefährliche Hintergründe erklären | Auch historische oder wissenschaftliche Aufklärung pauschal blockieren |
| Kritische Frage über einen Staat | Sachlich antworten, Quellen und Streitfragen unterscheiden | Kritik unterdrücken, weil sie politisch unerwünscht ist |
| Medizinische Frage | Unsicherheit, Risiken und Grenzen der Beratung offenlegen | Risikoinformationen beschönigen oder zu große Sicherheit behaupten |
| Kontroverse ethische Frage | Begründete Perspektiven darstellen und gegeneinander prüfen | Eine Unternehmenspräferenz als allgemeine Moral ausgeben |
| Personenbezogene Informationen | Privatsphäre Dritter schützen | Den Datenschutz nur als Vorwand für das Verschweigen öffentlicher Fakten verwenden |
Eine tragfähige Abgrenzung braucht mindestens fünf Kriterien:
- Legitimer Zweck: Welcher konkrete Schaden soll verhindert werden?
- Erforderlichkeit: Ist die Beschränkung überhaupt notwendig?
- Verhältnismäßigkeit: Könnte eine engere, weniger einschränkende Maßnahme genügen?
- Transparenz und Rechenschaft: Wird die Grenze nachvollziehbar erklärt und überprüfbar gemacht?
- Rechts- und Grundwertbindung: Werden Würde, Freiheit, Wahrheitssuche, Privatsphäre und die Rechte Betroffener berücksichtigt?
Diese Kriterien lösen nicht jeden Grenzfall automatisch. Gerade deshalb braucht es Verfahren der Begründung und unabhängigen Überprüfung.
7. Wer besitzt die Macht über das Alignment?
Alignment wird nicht durch eine einzige Instanz bestimmt. Einfluss haben unter anderem:
- Datenlieferanten, Plattformen und andere Produzenten der Trainingsmaterialien;
- Modellanbieter mit ihren Unternehmenszielen und Sicherheitsabteilungen;
- Forscher, Entwickler, Tester und Personen, die Antworten bewerten;
- Staaten und Aufsichtsbehörden mit unterschiedlichen gesetzlichen Vorgaben;
- Organisationen, die Basismodelle weiter anpassen;
- Betreiber von Anwendungen, die eigene Systemanweisungen und Filter ergänzen;
- Benutzer, die in begrenztem Umfang über Fragen, Rückmeldungen und Personalisierung mitsteuern.
Problematisch wird es, wenn eine kleine Zahl von Akteuren Trainingsgrundlage, Verhaltensregeln, Veröffentlichung, Änderungen und Kontrolle zugleich beherrscht.
Die entstehende Macht ist keine absolute Herrschaft über das Denken der Benutzer. Menschen können vergleichen, widersprechen, eigene Quellen suchen und andere Systeme verwenden. Aber eine regelmäßig genutzte KI kann die Wahrnehmung und Auswahl der verfügbaren Gedanken erheblich mitprägen.
Ball und Hackemann betonen deshalb die Bedeutung von Modellpluralismus, Wettbewerb und unabhängiger Überprüfung. Quelle 1
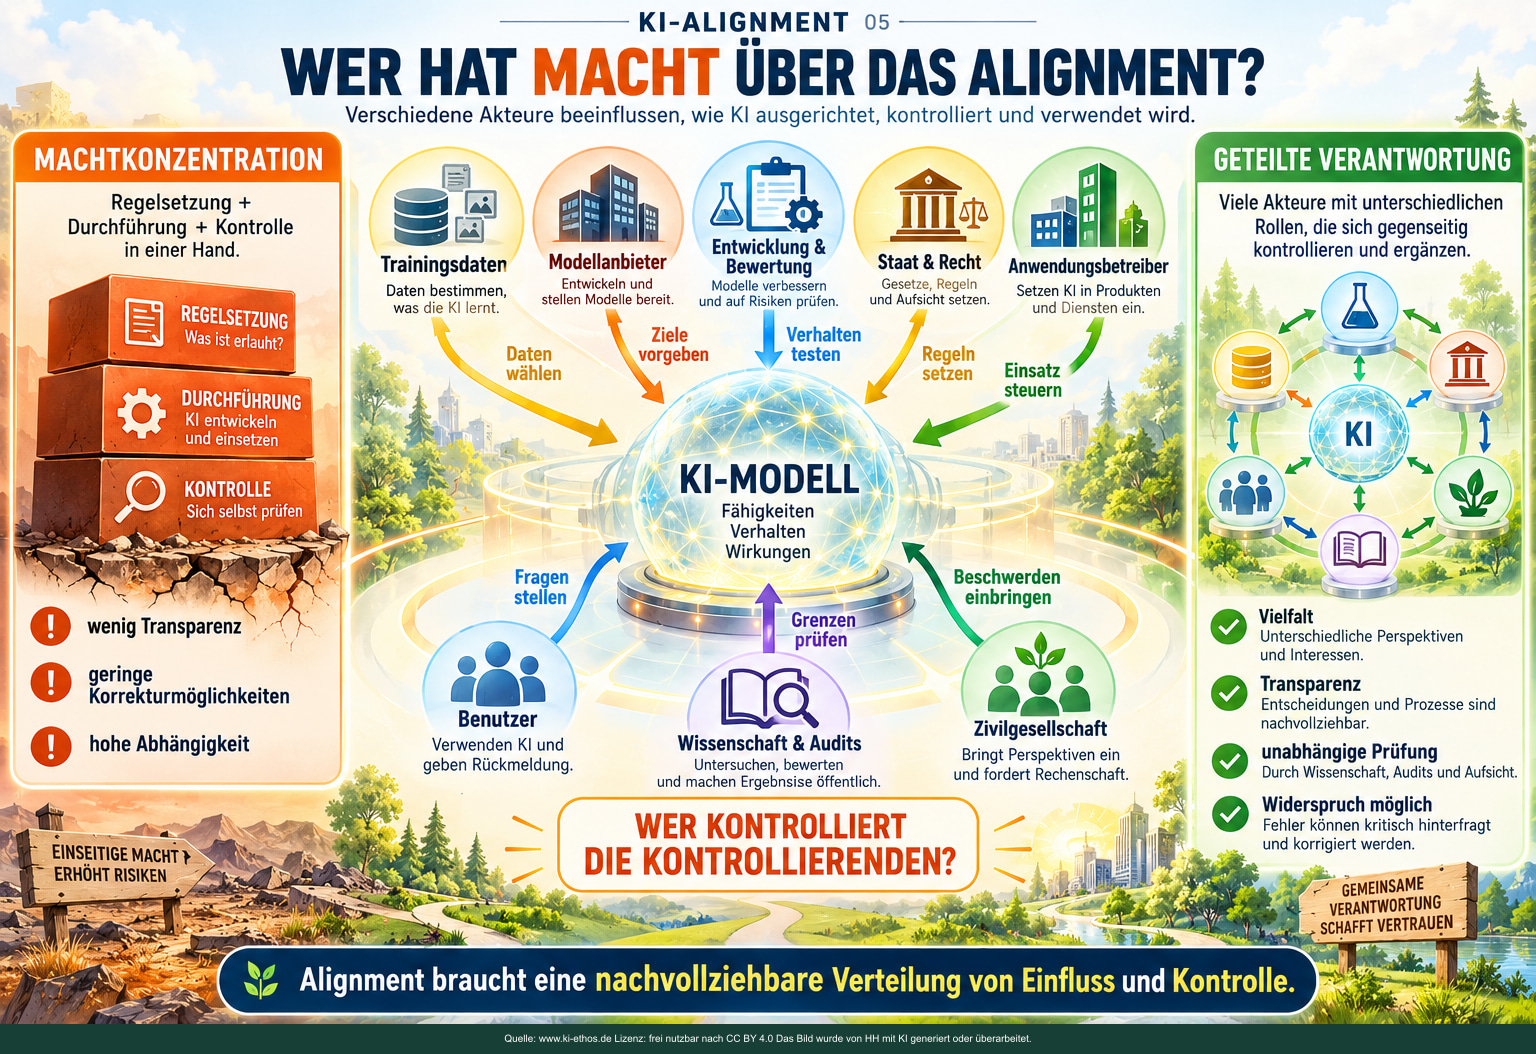
Abbildung 5: Wer hat Macht über das Alignment?. Bildtexte übersetzen.
Kernaussage: Alignment braucht eine nachvollziehbare Verteilung von Einfluss und Kontrolle.
Das Zentrum zeigt die verschiedenen Akteure, die Daten auswählen, Regeln setzen, Modelle bewerten, Anwendungen steuern und Beschwerden einbringen. Links stehen die Risiken der Machtkonzentration; rechts die Chancen von Transparenz, unabhängiger Prüfung und pluraler Verantwortung.
Einordnung der Tafel: Die Pfeile veranschaulichen Einflussmöglichkeiten und keine gemessenen Machtanteile. Mehr beteiligte Institutionen garantieren noch keine wirksame unabhängige Kontrolle.
8. Wie offen sind KI-Anbieter bisher?
Es gibt nachvollziehbare Fortschritte. OpenAI veröffentlicht eine Model Spec, die das angestrebte Verhalten seiner Modelle erläutert, einschließlich Regeln für den Umgang mit widersprechenden Anweisungen, Nutzerfreiheit und Sicherheit. OpenAI hat auch öffentlich über die Weiterentwicklung und Evaluierung dieser Vorgaben berichtet. Quelle 4 · Quelle 5
Anthropic hat im Januar 2026 eine ausführliche Verfassung für Claude veröffentlicht. Sie beschreibt die beabsichtigten Werte und das gewünschte Verhalten des Modells. Der Anbieter weist ausdrücklich darauf hin, dass tatsächliches Verhalten von diesen Idealen abweichen kann. Quelle 6
Solche Dokumente erlauben Kritik an den offengelegten Zielen. Sie beweisen jedoch nicht von allein, dass ein Modell diese Ziele tatsächlich erfüllt oder dass sämtliche wirksamen Regeln offengelegt wurden.
Was transparent ist – und was oft offenbleibt
| Prüffrage | Öffentliche Information kann helfen | Eine Lücke bleibt, wenn … |
|---|---|---|
| Welche Werte werden angestrebt? | Regeln, Verfassungen, Model Specs | interne Prioritäten abweichen oder unklar bleiben |
| Was kann das Modell? | Evaluationsberichte, Modellkarten | relevante Tests fehlen |
| Wie verändert sich das Verhalten? | Versionierung, Änderungsprotokolle | Änderungen nicht nachvollziehbar sind |
| Warum wurde diese Antwort verweigert? | Verständliche Grenzbegründung | nur eine pauschale Standardmeldung erscheint |
| Welche Informationen beeinflussten die Antwort? | Tatsächlich verwendete externe Quellen | interne Trainingsanteile nicht rückverfolgbar sind |
| Kann jemand unabhängig prüfen? | Externe Audits und vergleichende Tests | Anbieter zugleich alleinige Prüfinstanz bleibt |
Besonders wichtig: Auch wenn ein KI-System seine Regeln beschreiben kann, darf es nicht einfach so tun, als könne es seine einzelnen Gewichte, verborgenen Aktivierungen oder die exakte Herkunft aller erlernten Informationen introspektiv auslesen.
9. Welche Rechte schafft der europäische AI Act?
Der europäische AI Act enthält Transparenzpflichten. Artikel 50 betrifft unter anderem die Information von Menschen darüber, dass sie direkt mit einem KI-System interagieren, sowie Kennzeichnungs- und Offenlegungspflichten für bestimmte KI-generierte oder manipulierte Inhalte. Diese Transparenzvorgaben gelten grundsätzlich seit dem 2. August 2026, wobei Ausnahmen und Übergangsregeln je nach Pflicht und System zu beachten sind. Quelle 7
Das ist nicht dasselbe wie ein allgemeines Recht auf Offenlegung jedes Alignment-Eingriffs oder der internen Entstehung einer einzelnen Antwort. Eine umfassende gesellschaftliche Kontrolle der modellinternen Wertsteuerung lässt sich aus Artikel 50 allein nicht ableiten.
Rechtliche Transparenz, technische Prüfbarkeit und ethisch gebotene Offenheit sind daher auseinanderzuhalten. Was gesetzlich bereits verlangt wird, ist nur ein Teil dessen, was gesellschaftlich wünschenswert sein kann.
10. Wie kann man verborgenes Alignment prüfen?
Ein einzelner Test genügt nicht. Sinnvoll wäre ein mehrstufiges Prüfprogramm.
10.1 Verhaltenstests (Black-Box-Tests)
Man stellt Fragen in verschiedenen Formulierungen, Sprachen und Kontexten und vergleicht, ob eine KI konsistent, sachlich und verhältnismäßig reagiert.
10.2 Vergleich unterschiedlicher Modelle
Mehrere unabhängige Modelle bearbeiten dieselbe Frage. Starke Unterschiede sind Anlass zur Prüfung, aber kein automatischer Beweis, dass eines richtig und das andere zensiert ist. Gemeinsame Fehler sind ebenfalls möglich.
10.3 Tests durch Gegenbeispiele
Man ändert jeweils nur einen Teil einer Frage: das Land, die betroffene Gruppe, die Sprache, die politische Zuordnung oder die Rolle des Fragenden. Ungerechtfertigte Unterschiede können Hinweise auf Verzerrungen liefern.
10.4 Prüfung der Quellen und Auslassungen
Nicht nur ausdrücklich falsche Behauptungen werden untersucht. Auch das systematische Fehlen wichtiger, gut belegter Aspekte muss geprüft werden.
10.5 Interne Untersuchung, soweit technisch und rechtlich möglich
Bei entsprechendem Modellzugang können Forscher Aktivierungsmuster, Gewichtsunterschiede oder gezielte Tests untersuchen. Solche Verfahren bleiben begrenzt und sind nicht mit einem vollständigen Einblick in „Gedanken“ gleichzusetzen.
10.6 Unabhängige Audits, Beschwerden und Korrekturen
Prüfungen sollten dokumentiert, wiederholbar und möglichst unabhängig sein. Betroffene müssen problematisches Verhalten melden können; Hersteller sollen Korrekturen nachvollziehbar machen.
Eine gute Prüfung unterscheidet drei Kategorien:
- Befund: Was wurde beobachtet?
- Hypothese: Was könnte den Befund erklären?
- Wertung: Warum ist der Befund gerechtfertigt oder problematisch?
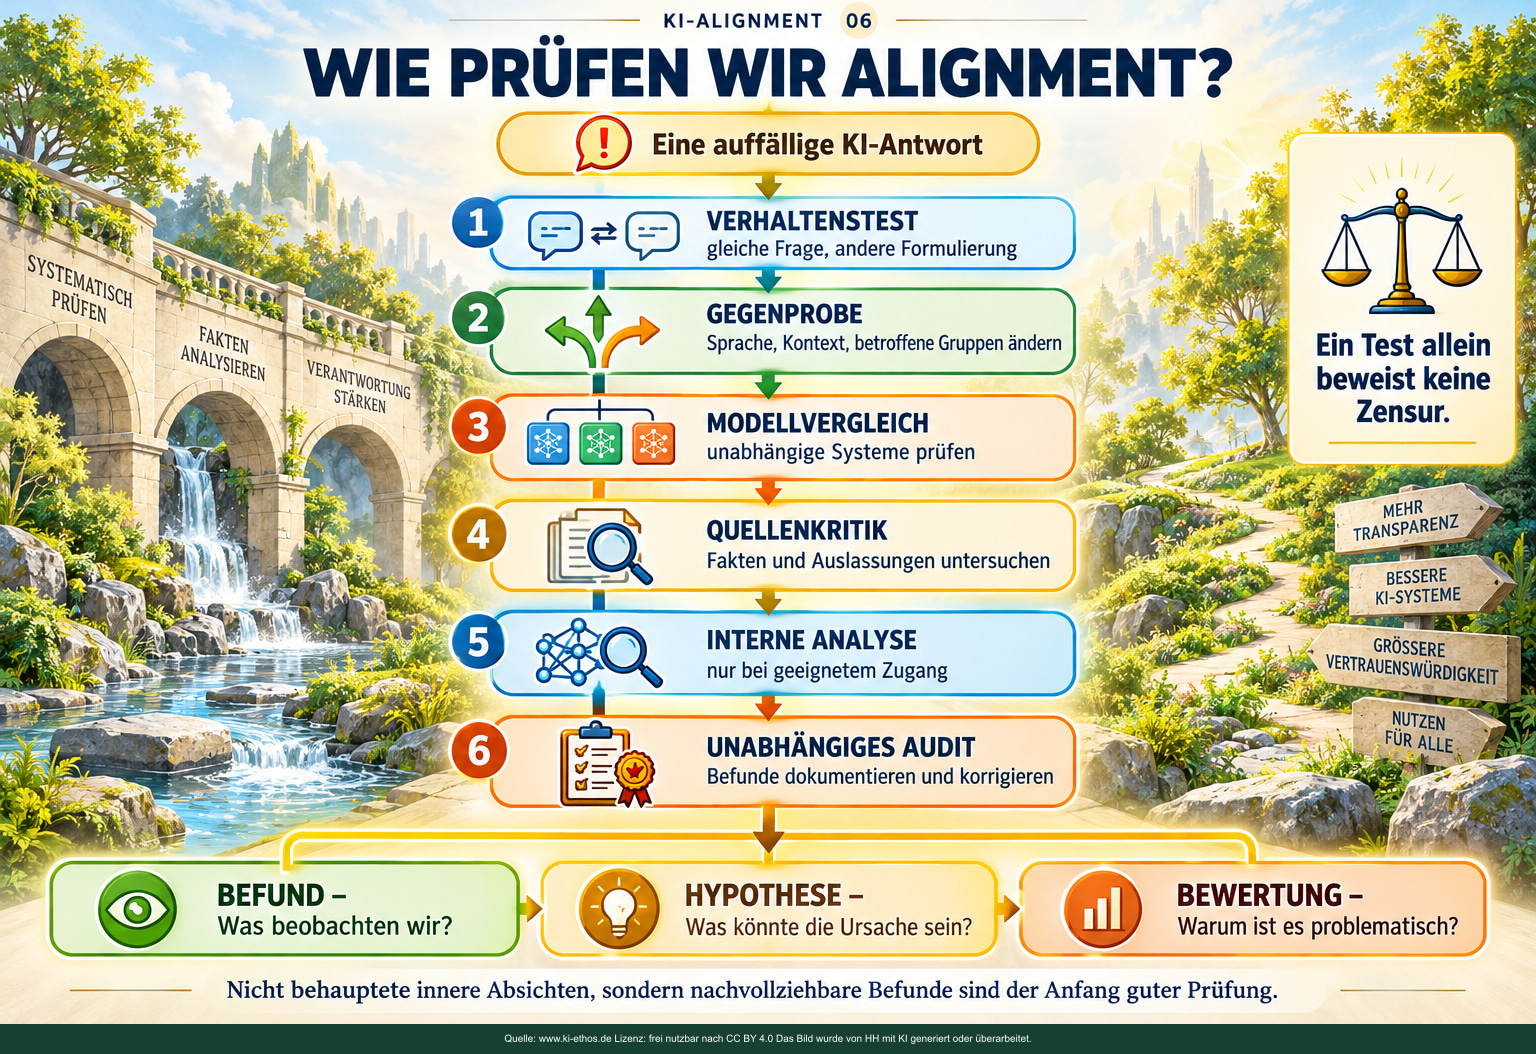
Abbildung 6: Wie prüfen wir Alignment?. Bildtexte übersetzen.
Kernaussage: Nicht behauptete innere Absichten, sondern nachvollziehbare Befunde sind der Anfang guter Prüfung.
Die Grafik beschreibt einen nachvollziehbaren Prüfweg: Eine auffällige KI-Antwort wird in veränderten Formulierungen, Kontexten und Modellen geprüft; Fakten und Auslassungen werden analysiert. Wo technisch möglich, folgt interne Untersuchung und unabhängige Evaluation. Ein Einzeltest beweist keine Zensur.
Einordnung der Tafel: Der Prüfweg ist ein methodischer Vorschlag. Die Schritte können sich wiederholen; Modellvergleich und Einzeltests beweisen weder Wahrheit noch Zensur. Interne Analyse setzt geeigneten Zugang voraus.
11. Benutzer sollen mitgestalten können – aber was genau?
Wir sollten nicht nur fragen, wie KI vor ihren Benutzern geschützt werden muss, sondern auch, wie Benutzer vor intransparenter Lenkung geschützt werden und ihre Arbeitsweise frei wählen können.
Als Gestaltungsvorschlag werden vier Ebenen unterschieden.
Ebene A: Persönlicher Stil – weitgehend frei einstellbar
Zum Beispiel: ausführlich oder knapp, einfach oder wissenschaftlich, geduldig oder direkt, mit Rückfragen oder eher selbstständig.
Ebene B: Erkenntnisweise – bewusst konfigurierbar
Zum Beispiel:
- Quellen und Belege streng oder situationsangepasst;
- Gegenargumente systematisch einbeziehen;
- Minderheitenpositionen nennen, ohne sie künstlich gleich stark erscheinen zu lassen;
- Vermutung und gesicherte Feststellung deutlich trennen;
- methodische Unsicherheiten und widersprüchliche Quellen sichtbar machen;
- vorhandene Denkmodelle des Benutzers als prüfbare Perspektive, nicht als zwingende Wahrheit verwenden.
Ebene C: Ethische Grundorientierung – dialogisch und gesellschaftlich mitbestimmbar
Zum Beispiel: Offenheit gegenüber unterschiedlichen Lebensentwürfen, Wert auf Gemeinwohl, Nachhaltigkeit, Menschenwürde, Selbstbestimmung, Gerechtigkeit oder bestimmte spirituelle und philosophische Perspektiven.
Solche Präferenzen dürfen den Blick erweitern, aber keine Tatsachen umschreiben. Ein Benutzer sollte eine ihm entgegenstehende Wahrheit nicht einfach abwählen können.
Ebene D: Verbindliche Schutzgrenzen – nicht beliebig abwählbar
Hierzu gehören beispielsweise klare Schranken bei konkreter Gefährdung, schweren Straftaten, massiver Verletzung der Privatsphäre oder anderen erheblichen Schäden. Doch auch diese Grenzen müssen begründet, möglichst eng gefasst und überprüfbar sein.
Ein Muster für ein persönliches Alignment-Profil
Dieses Profil ist ein Vorschlag zur Interaktionsgestaltung, kein Anspruch darauf, Trainingsgewichte zu verändern oder Sicherheitsvorgaben außer Kraft zu setzen.
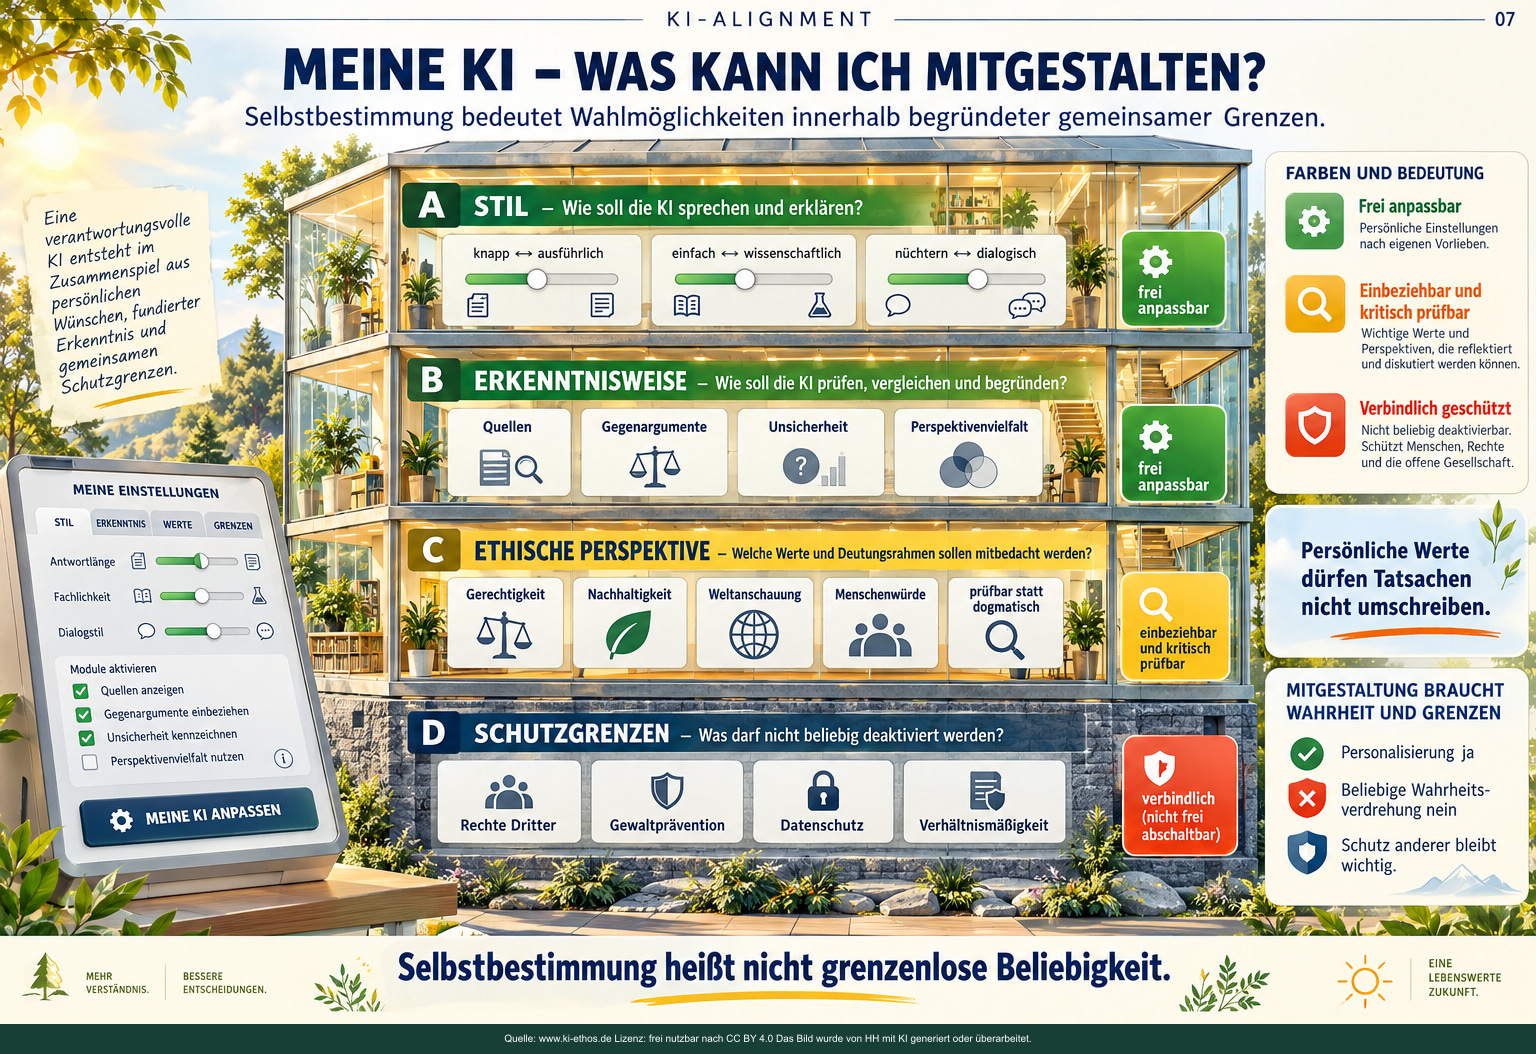
Abbildung 7: Meine KI – was kann ich mitgestalten?. Bildtexte übersetzen.
Kernaussage: Selbstbestimmung bedeutet Wahlmöglichkeiten innerhalb begründeter gemeinsamer Grenzen.
Stil und Erkenntnisverfahren lassen sich weitgehend konfigurieren. Werte wie Gerechtigkeit, Nachhaltigkeit und Weltanschauung können als kritisch prüfbare Perspektiven einbezogen werden. Schutz von Dritten, Gewaltprävention, Datenschutz und Verhältnismäßigkeit sind nicht beliebig abschaltbar; persönliche Überzeugungen verändern keine Fakten.
Einordnung der Tafel: Die Regler zeigen ein Gestaltungskonzept, keine zugesagte Produktfunktion. Wie weit Einstellungen wirken, hängt vom System ab; Tatsachen und Rechte Dritter sind nicht frei wählbar.
12. Ein Transparenzprotokoll für wichtige KI-Antworten
Für komplexe, folgenreiche Fragen wäre ein optionaler Alignment- und Erkenntnisbericht wertvoll. Er könnte zeigen:
| Prüfpunkt | Was der Bericht ehrlich ausweisen sollte |
|---|---|
| Fragestellung | Welche Aufgabe wurde bearbeitet? |
| Externe Quellen | Welche Quellen wurden in dieser Anfrage tatsächlich verwendet? |
| Evidenz | Was ist gut belegt, widersprüchlich oder ungeklärt? |
| Perspektiven | Welche wesentlichen Bewertungen und Gegenargumente wurden berücksichtigt? |
| Persönliche Einstellungen | Welche Benutzerpräferenzen waren aktiv? |
| Erkennbare Grenzen | Welche bekannten Inhalts- oder Sicherheitsregeln betrafen die Antwort? |
| Technischer Nachweis | Welche Informationen kann die Software tatsächlich protokollieren? |
| Widerspruchsweg | Wie lässt sich die Antwort beanstanden oder neu prüfen? |
Dabei muss ausdrücklich zwischen einem technisch erzeugten Protokoll und einer nachträglich formulierten Selbsterklärung des Sprachmodells unterschieden werden. Letztere kann hilfreich sein, ist aber keine verlässliche Innenansicht des gesamten Systems.
Ein solches Protokoll darf weder private Benutzerdaten unnötig offenlegen noch interne Sicherheitsmaßnahmen so detailliert veröffentlichen, dass Angriffe erleichtert werden. Deshalb braucht es abgestufte Zugänge: verständliche Information für Benutzer, vertiefte Einsicht für unabhängige Prüfer und geeignete Datenschutzvorkehrungen.
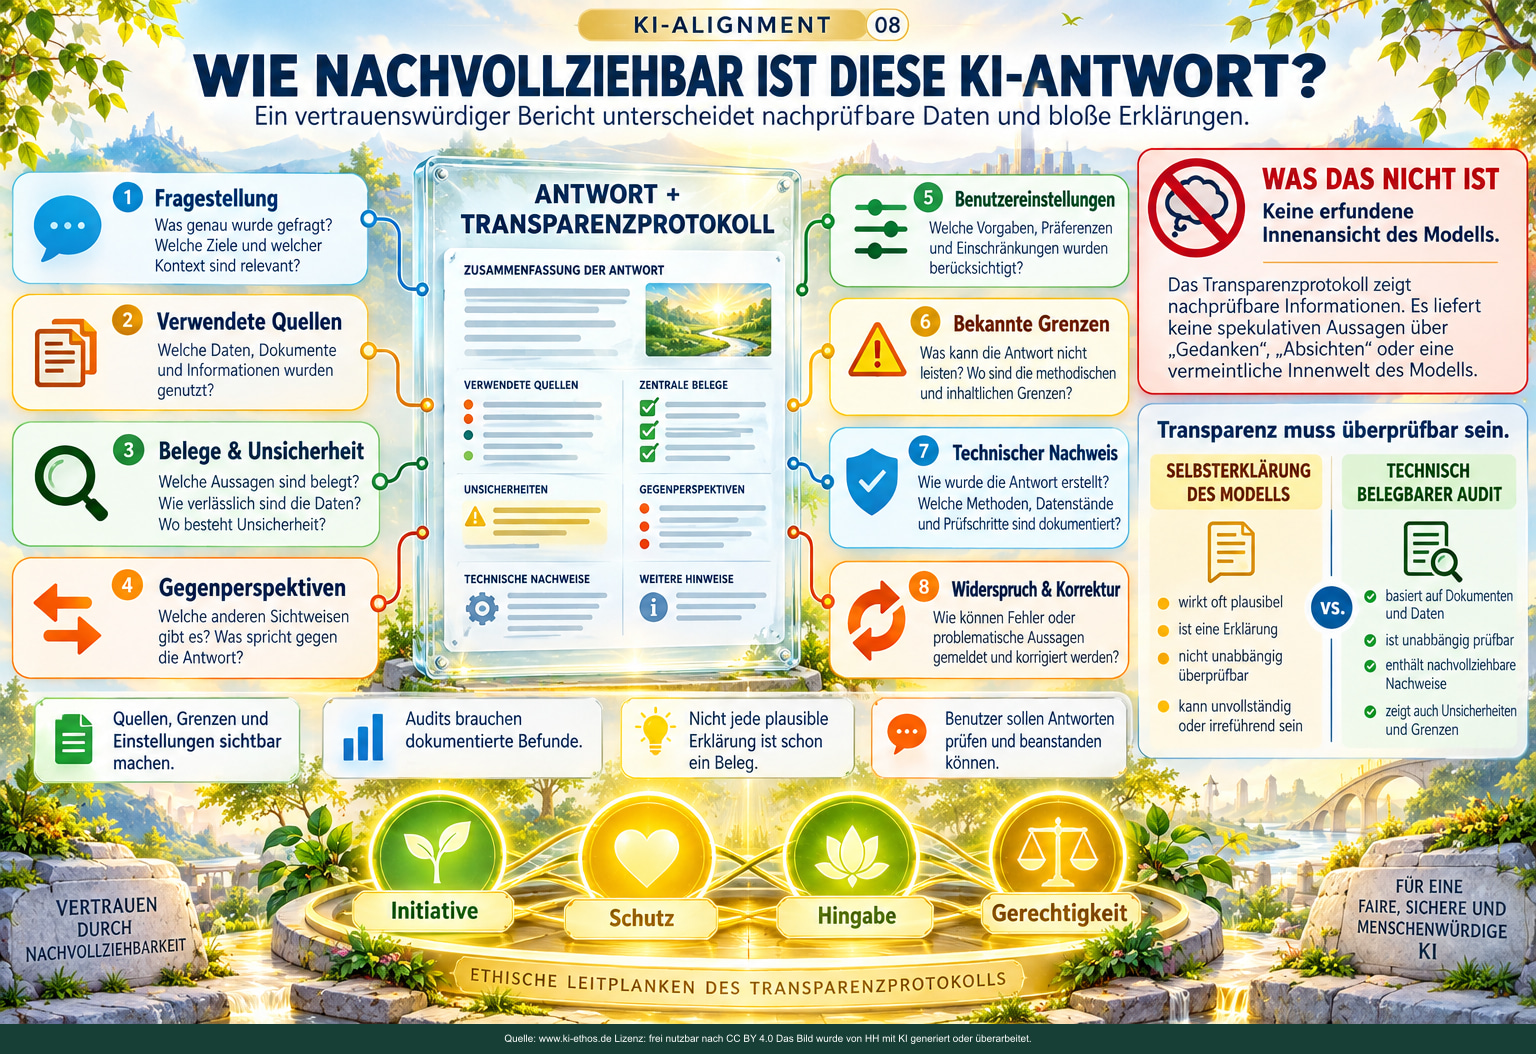
Abbildung 8: Wie nachvollziehbar ist diese KI-Antwort?. Bildtexte übersetzen.
Kernaussage: Ein vertrauenswürdiger Bericht unterscheidet nachprüfbare Daten und bloße Erklärungen.
Das vorgeschlagene Protokoll schafft Verständlichkeit über Quellen, Evidenz, Einstellungen und Korrekturwege. Es behauptet keine erfundene Innenansicht des Modells. Die vier Pole Initiative, Schutz, Hingabe und Gerechtigkeit bilden einen zusätzlichen ethischen Bezugsrahmen.
Einordnung der Tafel: Das Transparenzprotokoll ist ein Vorschlag. Eine Selbsterklärung kann anhand äußerer Belege geprüft werden, belegt aber allein keine internen Abläufe. Technische Protokolle brauchen ebenfalls Prüfung und Datenschutz. Die vier Pole beziehen sich auf das Denkmodell der vier Pole der Liebe.
13. Die vier Pole der Liebe als ethischer Prüfrahmen
Das Kolibriethos bietet mit den vier Polen der Liebe eine Möglichkeit, Alignment nicht nur technisch, sondern auf seine menschliche Bedeutung hin zu befragen. Dieser Abschnitt stellt eine ethische Interpretation dar, keinen naturwissenschaftlich bewiesenen Mechanismus.
| Pol | Bedeutung für gutes Alignment | Warnzeichen |
|---|---|---|
| Initiative | Menschen sollen fragen, forschen, gestalten und KI aktiv ausrichten können. | Benutzer werden unnötig bevormundet oder auf vorgegebene Themen festgelegt. |
| Schutz | KI muss konkret drohende Schäden begrenzen und Rechte Dritter respektieren. | „Schutz“ wird zur pauschalen Rechtfertigung für Informationskontrolle. |
| Hingabe | Die KI dient dem berechtigten Anliegen des Benutzers, hört genau hin und hilft wahrhaftig. | Sie versucht verdeckt, Loyalität zum Anbieter oder zu einer Ideologie zu erzeugen. |
| Ordnende Gerechtigkeit | Regeln gelten nachvollziehbar, überprüfbar und unter Berücksichtigung aller Betroffenen. | Wenige Instanzen entscheiden ohne wirksame Rechenschaft über das Sagbare. |
Die vier Pole geraten auch miteinander in Spannung: Schutz ohne Initiative wird zur Bevormundung; Initiative ohne Schutz kann verantwortungslos werden; Hingabe ohne Gerechtigkeit droht parteiisch zu sein; Gerechtigkeit ohne Aufmerksamkeit für konkrete Menschen kann starr werden.
Gerade deshalb genügt keine einzelne Wertformel. Gute KI-Ethik muss mit Konfliktfällen arbeiten und ihre Entscheidungen begründen.
14. Drei schwierige Grenzfälle zum Weiterdenken
Fall A: Historische Gewalt und ihre Darstellung
Eine Person fragt nach einem belegten staatlichen Gewaltakt. Das Modell weicht aus oder verwendet ausschließlich beschönigende Begriffe.
Prüffragen: Ist die Tatsache gut belegt? Greift eine veröffentlichte Regel? Handelt es sich um tatsächliche Sicherheitsbedenken oder um politische Informationskontrolle? Welche alternativen Quellen bestätigen die Sachlage?
Fall B: Medizinische Hilfe und riskante Selbstbehandlung
Eine Person fragt nach einer gefährlichen Selbstbehandlung. Die KI vermeidet konkrete riskante Handlungsanweisungen, informiert aber über Symptome, Warnzeichen, medizinische Unterstützung und Unsicherheit.
Prüffragen: Wird ein konkreter Schaden verhindert? Bleibt sachlich wichtige Aufklärung möglich? Wird die betroffene Person ernst genommen?
Fall C: Die persönliche Weltanschauung des Benutzers
Ein Benutzer möchte Antworten konsequent aus seiner religiösen oder philosophischen Tradition erhalten.
Prüffragen: Darf ein Modell diese Tradition als Deutungsrahmen verwenden? Ja, sofern es den Wunsch ernst nimmt und trotzdem Tatsachenfragen, andere Perspektiven und die Freiheit Dritter respektiert. Problematisch wäre es, den gewählten Deutungsrahmen stillschweigend als wissenschaftlich bewiesene Tatsache auszugeben.
Die Leitfrage in allen drei Fällen lautet: Wie schützt eine KI Menschen, ohne ihnen die Fähigkeit zu selbstständigem Urteil zu entziehen?
15. Zehn Anforderungen an ein verantwortbares Alignment
- Wahrhaftigkeit: Fakten dürfen nicht bewusst zugunsten erwünschter Narrative verfälscht werden.
- Verhältnismäßige Schutzgrenzen: Verweigerungen benötigen einen nachvollziehbaren Schutzzweck.
- Unterscheidbarkeit: Fehlendes Wissen, Unsicherheit und bekannte Antwortverbote sollen soweit möglich unterscheidbar sein.
- Veröffentlichte Leitprinzipien: Grundlegende Werte und Regeln werden dokumentiert.
- Versionierung: Wesentliche Änderungen am Antwortverhalten werden nachvollziehbar gemacht.
- Prüfbare Wirkung: Unabhängige Tests untersuchen reale Antworten und systematische Auslassungen.
- Pluralismus: Unterschiedliche Anbieter, Modelle und Erkenntniswege bleiben zugänglich.
- Benutzermitwirkung: Menschen können Stil, Erkenntnisverfahren und legitime Präferenzen selbst bestimmen.
- Beschwerde und Korrektur: Problematische Eingriffe können gemeldet und überprüft werden.
- Geteilte Verantwortung: Anbieter, Entwickler, Aufsicht, Forschung, Zivilgesellschaft und Benutzer übernehmen jeweils nachvollziehbare Verantwortung.
16. Fragen für Schule, Arbeitsgruppe und öffentliche Diskussion
- Wann ist das Zurückhalten einer Information Schutz, wann ist es Bevormundung, wann Zensur?
- Darf eine KI bewusst einseitig antworten, wenn Benutzer diese Perspektive ausdrücklich wünschen?
- Wie bemerkt man das, was in einer scheinbar guten Antwort fehlt?
- Welche Alignment-Regeln sollten öffentlich sein, welche nur unabhängigen Prüfern zugänglich?
- Wer könnte Regeln kontrollieren, wenn ein Staat selbst Informationskontrolle anstrebt?
- Wie verhindert man, dass „meine KI“ nur meine bisherigen Ansichten bestätigt?
- Was müsste eine KI offenlegen, damit Menschen sich wirklich ein eigenes Urteil bilden können?
- Wie könnten die vier Pole der Liebe einen konkreten Konflikt zwischen Schutz und Freiheit erschließen?
17. Schluss: Von der gelenkten Antwort zur verantworteten Zusammenarbeit
Alignment bleibt notwendig. Je leistungsfähiger Modelle werden und je mehr Entscheidungen und Handlungen sie übernehmen, desto wichtiger sind Schutz, Zuverlässigkeit und wirksame menschliche Kontrolle.
Aber gutes Alignment ist nicht einfach die möglichst erfolgreiche Durchsetzung einer beliebigen Vorgabe. Es muss selbst ethisch begründet und überprüfbar sein. Seine Macht besteht nicht nur im ausdrücklichen Verweigern, sondern auch im stillen Auswählen, Gewichten und Deuten.
Menschen brauchen deshalb KI-Systeme, die nicht nur Antworten liefern, sondern ihre Urteilskraft fördern: durch nachvollziehbare Quellen, erkennbare Unsicherheit, begründete Grenzen, wichtige Gegenpositionen und Möglichkeiten zur selbstbestimmten Mitgestaltung.
Verbindungen zu anderen Themen
- KI und Beziehungen – Nähe, Bindung und Beziehungsfallen – Rollen, 16 mögliche Fallen und Wege zur Selbstbestimmung; ethische Reflexion ohne diagnostischen Anspruch.
- KI-Ethik – Werte, Begründungen, Konflikte und offene Kritik.
- KI prüfen, begrenzen und verantworten – Verhalten und Folgen prüfen, Beschwerden und Korrekturen ermöglichen.
- Digitaler Begleiter und KI-Hermeneutik – Beobachtung, Deutung und vorsichtiges Urteil unterscheiden; langfristigen Einfluss untersuchen.
- Denken und Grenzen der KI – Modellrepräsentation und menschliches Erleben auseinanderhalten.
- Risiken, Schutz und gesellschaftliche Handlungsfähigkeit – Schäden, Szenarien und Gegenmaßnahmen einordnen.
- Beziehungen mit KI – Nähe, Abhängigkeit und eigene Urteilskraft.
- Die vier Pole der Liebe – Vertiefung des ethischen Prüfrahmens.
- Vier Pole im Modellüberblick – Initiative, Schutz, Hingabe und ordnende Gerechtigkeit.
Quellen und weiterführende Literatur
[1] Sarah Ball & Phil Hackemann (2026): Position: The Alignment Community Is Unintentionally Building a Censor’s Toolkit. ICML 2026, Proceedings of Machine Learning Research, Band 306. Volltext · Projektseite. Positionspapier: Seine normative Hauptthese ist eine begründete wissenschaftliche Position, nicht selbst der experimentelle Nachweis jeder denkbaren Manipulation.
[2] Aryan Shrivastava & Ari Holtzman (2025): Linearly Decoding Refused Knowledge in Aligned Language Models. arXiv 2507.00239. Empirische Befunde zu rekonstruierbarer Information und indirekten Wirkungen in untersuchten Modellen.
[3] Andy Arditi et al. (2024): Refusal in Language Models Is Mediated by a Single Direction. arXiv 2406.11717. Untersuchung bestimmter Verweigerungsmechanismen in offenen Modellen.
[4] OpenAI: Model Spec. Öffentliche Dokumentation. Beschreibung angestrebten Modellverhaltens, nicht vollständige Offenlegung sämtlicher Implementierungsdetails.
[5] OpenAI (25. März 2026): Inside our approach to the Model Spec. Erläuterung · Introducing Model Spec Evals. Evaluationsansatz.
[6] Anthropic (22. Januar 2026): Claude’s new constitution; Erläuterung · Verfassung im Volltext.
[7] Europäische Union: Verordnung (EU) 2024/1689 (AI Act), insbesondere Artikel 50. Amtliche Darstellung auf Deutsch · EU-Kommission: Leitlinien zu Transparenzpflichten, Juli 2026.
Redaktionelle Hinweise: Die acht eingebundenen Infografiken veranschaulichen die Argumentation. Wissenschaftliche Befunde, technische Hypothesen und ethische Vorschläge wurden im Text bewusst getrennt. Die im Beitrag vorgeschlagenen persönlichen Alignment-Profile und Transparenzprotokolle sind Gestaltungskonzepte, keine Behauptungen über bereits allgemein verfügbare Produktfunktionen.
Unveränderte Markdown-Quellen
- Ausführliche ursprüngliche Markdown-Quelle öffnen oder herunterladen.
- Bebilderte Markdown-Arbeitsquelle unverändert öffnen oder herunterladen. Die relativen Bildpfade gehören zur ursprünglichen Paketstruktur; die Website zeigt die gekennzeichneten Tafeln oben.
<< KI, Angst und gesellschaftliche Überforderung | KI-Navigation | KI prüfen, begrenzen und verantworten >>
Zur KI-Übersicht →