Agentische KI und die Selbstoffenbarung menschlicher Arbeit
KI-Navigation | Agentische KI und die Selbstoffenbarung menschlicher Arbeit
Vom Suchinteresse zum Arbeitsprozess: Ein KI-Agent kann – je nach Zugriff und Architektur – nicht nur Fragen, sondern auch Ziele, Lösungswege, Hindernisse und Ergebnisse eines Projekts verarbeiten. Daraus könnte Wissen über Arbeitsmuster entstehen. Ob ein Anbieter solche Daten speichert oder auswertet, ist eine eigene technische, vertragliche und rechtliche Frage.
Leitfrage: Wer darf das Verständnis nutzen, das aus vielen einzelnen Arbeitsprozessen entstehen könnte?
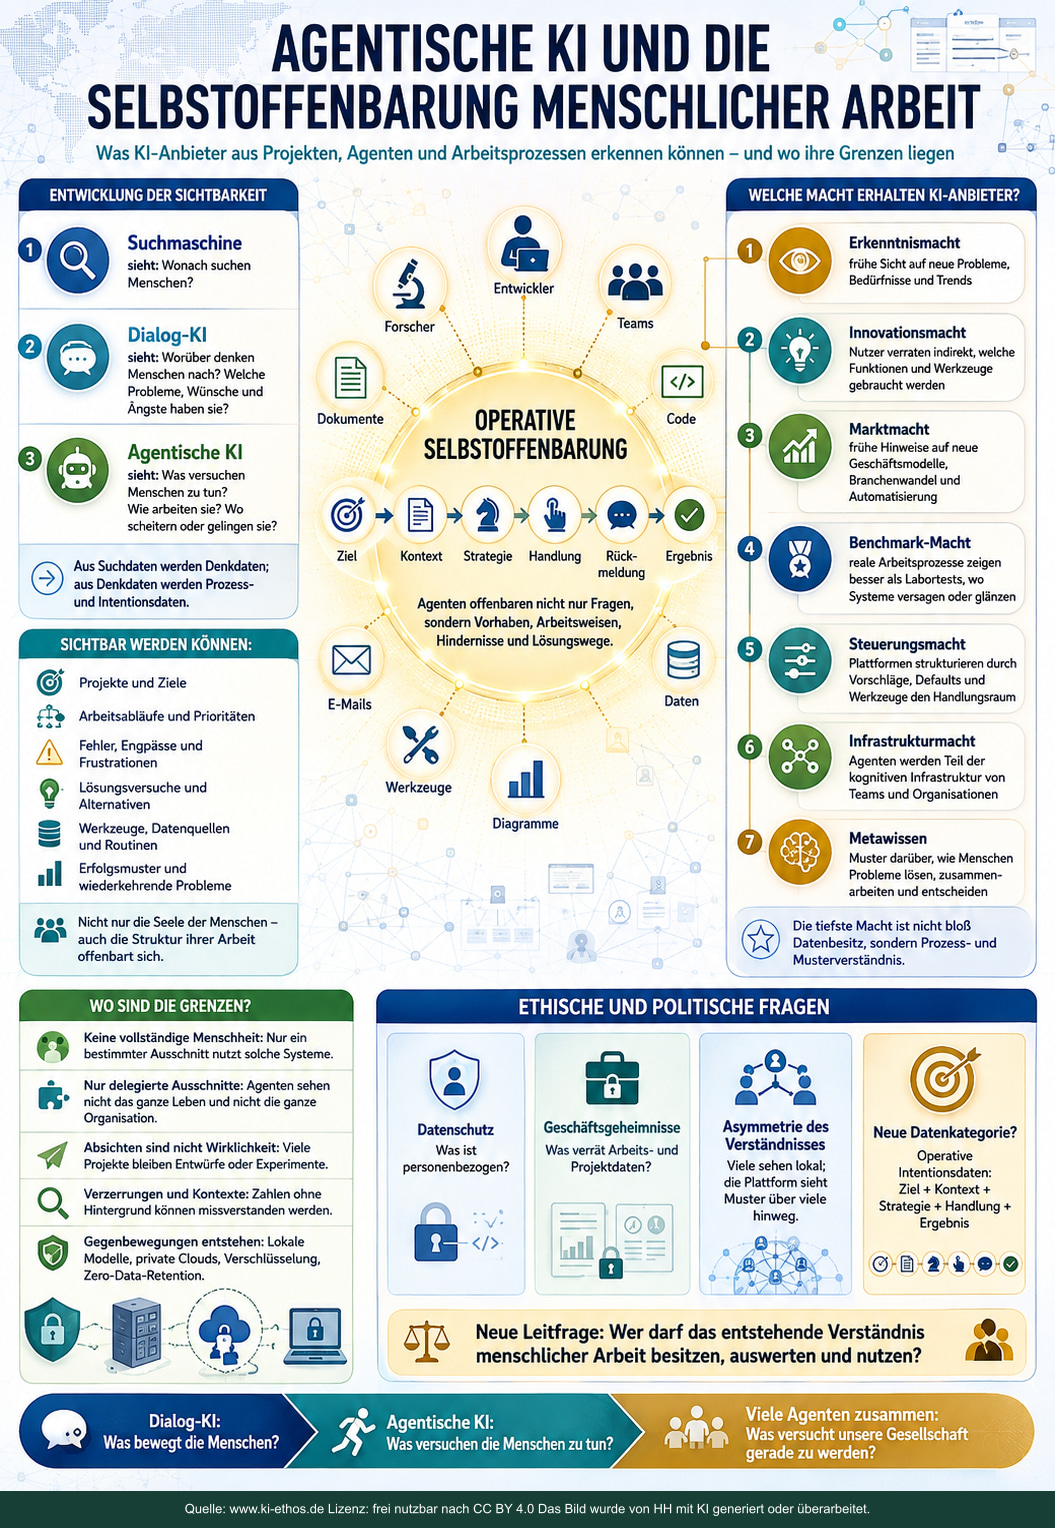
Agenten können sichtbar machen, was Menschen zu tun versuchen. Bildtexte übersetzen.
Die Tafel zeigt mögliche Einblicke und Machtformen, keine nachgewiesene Überwachungspraxis eines Anbieters. Entscheidend sind Berechtigungen, technische Architektur, Vertrag und Einstellungen. „Operative Intentionsdaten“ ist hier ein Begriffs- und Schutzvorschlag, keine bereits eigenständige gesetzliche Datenkategorie.
1. Von der persönlichen zur operativen Selbstoffenbarung
Die Nutzung dialogischer KI kann eine besondere Form von Selbstoffenbarung erzeugen. Menschen schildern einer KI nicht nur Fakten, sondern häufig auch Probleme, Zweifel, Wünsche, Ziele, Ängste, Konflikte, Entscheidungen und unfertige Entwürfe.
Das ist teilweise eine Selbstoffenbarung des inneren Lebens.
Mit KI-Agenten kann jedoch eine zweite Ebene hinzukommen. Agenten werden eingesetzt, um etwas zu tun:
- Software schreiben,
- Daten auswerten,
- Informationen recherchieren,
- Texte und Konzepte erzeugen,
- E-Mails bearbeiten,
- Dateien organisieren,
- Projekte planen,
- Fehler suchen,
- Prozesse automatisieren,
- Webseiten verändern,
- geschäftliche Entscheidungen vorbereiten.
Dadurch entsteht eine andere Art von Daten.
Operative Selbstoffenbarung
Dieser Beitrag schlägt dafür den Begriff operative Selbstoffenbarung vor. Er bezeichnet die Offenlegung von Informationen darüber,
Nicht nur der Mensch selbst offenbart sich. Auch seine Arbeit, seine Projekte und seine Organisation werden lesbar.
2. Drei Stufen zunehmender Sichtbarkeit
2.1 Suchmaschine: „Wonach suchen Menschen?“
Bei der Nutzung einer Suchmaschine können einzelne Suchhandlungen erfasst werden: Begriffe, Interessen, Probleme, Produkte und Themen. Aus Millionen Suchanfragen lassen sich Trends erkennen. Doch meistens bleibt der Ausschnitt klein: eine Frage, ein Stichwort, ein Linkklick.
2.2 Dialog-KI: „Worüber denken Menschen nach?“
Bei einer dialogischen KI wird der Kontext größer. Ein Mensch schreibt nicht nur „Datenbank langsam“, sondern beschreibt möglicherweise Vorgeschichte, bisherige Versuche, Hypothesen, Unsicherheiten und Prioritäten.
Aus Suchdaten werden in gewisser Weise Denkdaten.
2.3 Agentische KI: „Was versuchen Menschen zu tun?“
Ein Agent kann näher an den realen Arbeitsprozess rücken. Er erhält möglicherweise Zugriff auf:
- Projektdateien,
- Quellcode und Repositories,
- Datenbanken,
- Dokumente,
- E-Mails,
- Kalender,
- Aufgabenlisten,
- Unternehmenssoftware,
- Tests und Fehlermeldungen.
Damit wird nicht mehr nur eine Frage sichtbar, sondern eine Prozesskette:
Ziel → Kontext → Strategie → Handlung → Rückmeldung → Korrektur → Ergebnis
Aus Denk- und Kommunikationsdaten entstehen Prozess- und Intentionsdaten.
3. Was Agenten über Arbeit sichtbar machen können
Ein Agentenlauf kann – abhängig von Produkt, Berechtigungen und Datenschutzarchitektur – Hinweise auf sehr verschiedene Ebenen enthalten.
| Ebene | Möglicherweise sichtbar |
|---|---|
| Ziel | Was soll erreicht werden? |
| Priorität | Was ist besonders dringend oder wichtig? |
| Kontext | In welchem Projekt- oder Geschäftszusammenhang geschieht es? |
| Strategie | Welcher Lösungsweg wird gewählt? |
| Alternativen | Welche anderen Möglichkeiten wurden verworfen? |
| Probleme | Wo scheitert der Prozess? |
| Kompetenzlücken | Was kann der Mensch oder das Team nicht selbst lösen? |
| Werkzeuge | Welche Software, Daten und Plattformen werden verwendet? |
| Entscheidungen | Welche Option wird schließlich gewählt? |
| Erfolg | Welche Lösung funktioniert tatsächlich? |
Die besondere Informationsdichte entsteht durch die Kombination dieser Ebenen.
Ein einzelner Datensatz sagt vielleicht wenig. Millionen vergleichbarer Prozesse können jedoch Muster ergeben.
4. Vom einzelnen Projekt zum gesellschaftlichen Frühbild
Wenn viele Entwickler unabhängig voneinander dasselbe Problem bearbeiten, sieht dies zunächst nur wie eine Vielzahl einzelner Projekte aus. Aggregiert könnte daraus jedoch sichtbar werden:
- Eine neue Technologie wird wichtig.
- Eine bestehende Plattform verursacht zunehmend Schwierigkeiten.
- Eine neue Programmiersprache oder Architektur setzt sich durch.
- Ein bisher manueller Arbeitsschritt wird automatisierbar.
- Ein Werkzeug wird ungewöhnlich häufig ersetzt.
- Eine neue Produktkategorie entsteht.
Ähnliches gilt für andere Bereiche.
Medizin und Gesundheit
Viele neue Fragen könnten auf Versorgungslücken, Dokumentationsprobleme oder neue Arbeitsanforderungen hinweisen.
Bildung
Agentennutzung könnte zeigen, welche Inhalte Lernende und Lehrende besonders schwierig finden oder welche Unterrichtsvorbereitungen viel Zeit kosten.
Wirtschaft
Neue Geschäftsideen und Automatisierungsversuche könnten frühzeitig auf Marktverschiebungen hindeuten.
Wissenschaft
Forschungsschwerpunkte könnten sichtbar werden, noch bevor Ergebnisse veröffentlicht werden.
Verwaltung
Wiederkehrende Agentenaufträge könnten strukturelle Schwächen bürokratischer Prozesse erkennen lassen.
Damit könnte aus Agentendaten ein Frühbild gesellschaftlicher Veränderung entstehen.
5. Welche Macht könnte daraus entstehen?
Die entscheidende Frage lautet nicht nur: Wie viele Daten besitzt ein KI-Unternehmen?
Sondern: Welche Muster kann es aus diesen Daten erkennen?
5.1 Erkenntnismacht
Wer sehr viele Arbeitsprozesse beobachten kann, erkennt möglicherweise früher:
- neue Probleme,
- neue Bedürfnisse,
- technische Engpässe,
- häufige Fehler,
- neue Themen,
- entstehende Trends.
Die Plattform könnte damit zu einem besonderen gesellschaftlichen Beobachtungsinstrument werden.
5.2 Innovationsmacht
Wenn viele Nutzer immer wieder versuchen, dieselbe Aufgabe zu lösen, entsteht indirekt eine Produktidee. Umständliche Workarounds zeigen dem Anbieter, welche Funktion fehlt. Nutzer können damit unfreiwillig einen Teil der Produkt-Roadmap liefern.
5.3 Marktmacht
Agenten könnten Veränderungen früher anzeigen als klassische Marktanalysen:
- neue Geschäftsmodelle,
- Automatisierungsfelder,
- sinkende Bedeutung bestehender Software,
- neue Dienstleistungen,
- entstehende Berufsbilder,
- verschwindende Tätigkeiten.
Das wäre ein ökonomisches Radar.
5.4 Benchmark-Macht
Klassische Benchmarks fragen, ob ein Modell standardisierte Aufgaben lösen kann. Auswertbare Agentenläufe könnten dagegen Hinweise darauf geben, wie Systeme bei echter Arbeit funktionieren: mit unvollständigen Informationen, chaotischen Projekten, widersprüchlichen Anforderungen und realen Fehlversuchen.
5.5 Steuerungsmacht
Plattformen beobachten nicht nur Arbeit. Sie strukturieren gleichzeitig den Handlungsraum durch:
- Vorschläge,
- Default-Einstellungen,
- priorisierte Ergebnisse,
- verfügbare Werkzeuge,
- Integrationen,
- Sicherheitsregeln.
Dadurch kann eine Rückkopplung entstehen:
5.6 Infrastrukturmacht
Wenn Agenten auf zentrale Arbeitsmittel zugreifen, werden KI-Systeme Teil der kognitiven Infrastruktur einer Organisation. Recherche, Kommunikation, Programmierung, Analyse, Dokumentation und Entscheidungsunterstützung können über dieselbe Plattform laufen.
5.7 Metawissen
Die tiefste Ebene ist vielleicht nicht der einzelne Datensatz, sondern das Wissen über Muster:
- Wie lösen Menschen Probleme?
- Wo machen sie typische Fehler?
- Welche Strategien führen zum Erfolg?
- Welche Arbeitsschritte sind besonders teuer?
- Welche Kombinationen von Menschen und Werkzeugen funktionieren?
- Wo entstehen regelmäßig Konflikte?
- Welche Aufgaben lassen sich delegieren?
Das wäre eine neue Ressource: Wissen über die Struktur menschlicher Problemlösung.
6. Eine neue Form gesellschaftlicher Asymmetrie
Ein einzelnes Unternehmen kennt seine eigenen Schwierigkeiten. Ein Entwickler kennt sein Projekt. Eine Organisation kennt ihre Prozesse.
Eine Plattform mit sehr vielen Nutzern könnte dagegen – sofern sie solche Daten rechtlich und technisch auswerten dürfte – Muster über viele Organisationen hinweg erkennen.
Damit entsteht eine mögliche Asymmetrie:
unten: lokales Wissen
gegenüber
oben: aggregiertes Metawissen
Millionen Menschen liefern einzelne Puzzleteile. Der Plattformbetreiber könnte als einer der wenigen das größere Bild sehen.
7. Fünf Ebenen müssen sauber getrennt werden
„Der Anbieter hat technisch Zugriff“ ist nicht dasselbe wie „der Anbieter nutzt alles“.
Mindestens fünf Ebenen sind zu unterscheiden:
1. Technische Verarbeitung – Daten müssen verarbeitet werden, damit ein Dienst funktioniert.
2. Speicherung – Wie lange bleiben Inhalte oder Metadaten gespeichert?
3. Menschlicher Zugriff – Unter welchen Bedingungen können Beschäftigte oder Dienstleister Inhalte sehen?
4. Statistische oder produktbezogene Auswertung – Werden Nutzungs- und Prozessdaten aggregiert analysiert?
5. Modelltraining – Werden Inhalte zur Verbesserung oder zum Training zukünftiger Modelle verwendet?
Die Frage „Werden meine Daten fürs Training verwendet?“ ist deshalb wichtig, aber nicht ausreichend.
Mindestens ebenso wichtig ist:
8. Aktuelle Beispiele für unterschiedliche Datenschutzarchitekturen
Die konkrete Lage hängt stark vom Anbieter, Produkt, Tarif, Vertrag und von den Einstellungen ab.
OpenAI API
OpenAI erklärt, API-Daten standardmäßig nicht zum Modelltraining zu verwenden, sofern Kunden nicht ausdrücklich Daten teilen. Speicherung ist davon getrennt: Missbrauchsprotokolle können standardmäßig bis zu 30 Tage bestehen; einzelne Funktionen speichern Anwendungszustände. Genehmigte Zero-Data-Retention-Konfigurationen schließen Kundeninhalte aus diesen Protokollen aus, gelten aber nicht pauschal für jede Funktion. Endpunkt-, Werkzeug- und Sicherheitsausnahmen sind zu prüfen. Diese API-Regeln sind keine allgemeine Aussage über private ChatGPT-Chats. [1]
Anthropic
Anthropic erklärt für kommerzielle Produkte einschließlich API, Ein- und Ausgaben standardmäßig nicht zum Training zu nutzen. Ausdrücklich übermitteltes Feedback oder eine andere Zustimmung können hiervon abweichen. API-Inhalte werden grundsätzlich innerhalb von 30 Tagen gelöscht; Ausnahmen betreffen unter anderem bestimmte Dienste, Vereinbarungen, Sicherheitsdurchsetzung und Rechtspflichten. Gespeicherte Unterhaltungen anderer kommerzieller Produkte folgen eigenen Regeln. Eine API-Frist ist deshalb keine allgemeine Löschzusage für alle Claude-Produkte. [2] [3]
Google Workspace mit Gemini
Google beschreibt für die dokumentierten Workspace-Angebote mit Gemini Unternehmensschutz, die Anwendung bestehender Organisationskontrollen und eine Beschränkung der Nutzung von Organisationsinhalten zum Modelltraining außerhalb der eigenen Domain ohne Erlaubnis. Die konkreten Zusagen sind an das jeweilige Workspace-Angebot und die Lizenz gebunden; sie werden hier nicht auf sämtliche privaten Gemini-Nutzungen übertragen. [4]
Wichtig: Produktbedingungen können sich ändern. Vor dem Einsatz für vertrauliche Projekte müssen die aktuellen Vertrags-, Datenschutz- und Aufbewahrungsbedingungen erneut geprüft werden.
9. Rechtliche Grenzen
9.1 Datenschutz
Fällt eine Verarbeitung personenbezogener Daten in den Anwendungsbereich der DSGVO, nennt Artikel 5 insbesondere folgende Grundsätze: [5]
- Rechtmäßigkeit, Verarbeitung nach Treu und Glauben und Transparenz,
- Zweckbindung,
- Datenminimierung,
- Richtigkeit,
- Speicherbegrenzung,
- Integrität und Vertraulichkeit.
Diese Prinzipien begrenzen Zweitverwendungen personenbezogener Daten; die Zulässigkeit einer konkreten Auswertung ist gesondert zu prüfen. Auch eine aggregierte Auswertung ist nicht allein durch ihre Bezeichnung datenschutzfrei. Die Seite bietet allgemeine Orientierung und prüft keinen konkreten Rechtsfall.
9.2 Geschäftsgeheimnisse
Nicht jede sensible Information ist personenbezogen. Ein Agent kann beispielsweise erfahren:
- welches Produkt ein Unternehmen entwickelt,
- welche technische Schwäche ein System besitzt,
- welche strategische Option geprüft wird,
- welches Forschungsproblem bearbeitet wird,
- welche internen Engpässe bestehen.
Solche Informationen können wirtschaftlich hochsensibel sein, auch wenn kein klassisches Datenschutzproblem vorliegt.
Hier spielen unter anderem eine Rolle:
- Vertragsrecht,
- Geheimhaltungsvereinbarungen,
- Geschäftsgeheimnisschutz,
- Informationssicherheit,
- Wettbewerbsrecht.
10. Wo liegen die Erkenntnisgrenzen?
Die Macht der Plattformen darf nicht überschätzt werden.
10.1 Die Nutzer sind nicht „die Menschheit“
KI-Nutzer bilden keine repräsentative Stichprobe. Bestimmte Länder, Sprachen, Altersgruppen, Berufe, Unternehmen und Einkommensgruppen sind über- oder unterrepräsentiert.
10.2 Agenten sehen nur delegierte Ausschnitte
Auch ein Agent mit vielen Rechten sieht nicht automatisch:
- informelle Gespräche,
- Machtverhältnisse,
- persönliche Motive,
- unausgesprochene Konflikte,
- Körpersprache,
- soziale Dynamiken,
- Entscheidungen außerhalb des Systems.
Die digitale Projektdokumentation ist nicht identisch mit der wirklichen Organisation.
10.3 Absichten sind nicht Ergebnisse
Ein Projekt kann geplant, begonnen und später verworfen werden. Intentionsdaten sind Signale, keine sicheren Zukunftsprognosen.
10.4 Häufigkeit ist nicht Bedeutung
Millionen kleine Routineprobleme können statistisch stärker auffallen als wenige seltene, aber historisch wichtige Entwicklungen.
10.5 Kontextverlust
Aggregierte Daten können Muster zeigen und gleichzeitig den ursprünglichen Zusammenhang verlieren. Derselbe Agentenbefehl kann in verschiedenen Organisationen völlig unterschiedliche Bedeutungen haben.
11. Gegenbewegungen: sensible Arbeit abschirmen
Organisationen können zum Schutz sensibler Arbeitsdaten verschiedene Gegenmaßnahmen prüfen:
- lokale Modelle,
- private Clouds,
- isolierte Unternehmensumgebungen,
- Zero-Data-Retention,
- kundenkontrollierte Verschlüsselung,
- strikte Rollen- und Zugriffsrechte,
- Data-Loss-Prevention,
- Trennung vertraulicher und öffentlicher Agenten,
- technische Protokollierung der Zugriffe.
Es entsteht ein Spannungsfeld:
12. Brauchen wir eine neue Datenkategorie?
Der klassische Datenschutz denkt vor allem in Kategorien personenbezogener Daten. Bei Agentensystemen entsteht zusätzlich eine andere Art sensibler Information.
Operative Intentionsdaten
Sie bestehen aus der Kombination:
Ziel + Kontext + Strategie + Handlung + Rückmeldung + Ergebnis
Sie zeigen:
- woran jemand arbeitet,
- was jemand erreichen will,
- wie jemand vorgeht,
- welche Schwierigkeiten auftreten,
- welche Lösung schließlich funktioniert.
Diese Daten können für eine Person, ein Unternehmen, eine Forschungseinrichtung oder einen Staat strategisch relevant sein.
Deshalb könnte es sinnvoll sein, operative Intentionsdaten ausdrücklich als schützenswerte Kategorie zu diskutieren. Das ist ein Begriffsvorschlag dieses Beitrags, keine Behauptung einer neuen gesetzlichen Kategorie. Bestehender Datenschutz, vertragliche Pflichten und Geschäftsgeheimnisschutz können unabhängig davon einschlägig sein.
13. Nicht nur Datenschutz – Wissensgerechtigkeit
Wenn Plattformanbieter aus sehr vielen Arbeitsprozessen systematisches Wissen gewinnen können, stellt sich die Frage: Wer profitiert davon?
Modell A: Das Wissen gehört allein der Plattform
Der Betreiber nutzt aggregierte Erkenntnisse exklusiv.
Modell B: Das Wissen wird teilweise öffentlich
Anonymisierte Erkenntnisse über gesellschaftliche Probleme oder technische Engpässe werden als Gemeingut veröffentlicht.
Modell C: Nutzer und Organisationen erhalten eigene Auswertungen
Wer Daten erzeugt, bekommt einen Teil des daraus gewonnenen Metawissens zurück.
Modell D: Treuhänderische Datenräume
Bestimmte aggregierte Erkenntnisse werden von unabhängigen Institutionen verwaltet.
Damit berührt das Thema nicht nur Datenschutz, sondern auch:
- Machtverteilung,
- Wettbewerb,
- Gemeinwohl,
- Wissensgerechtigkeit,
- demokratische Kontrolle.
14. Eine neue Machtressource: Verständnis
Als Denkbild lassen sich verschiedene Machtressourcen nebeneinanderstellen; die folgende Reihe ist keine belegte historische Stufenfolge:
Land → Kapital → Maschinen → Information → Daten → Verständnis
Daten allein sind noch kein Wissen. Macht entsteht besonders dort, wo jemand aus vielen Daten zuverlässig erkennen kann:
- was geschieht,
- warum es geschieht,
- wohin sich etwas entwickelt,
- was wahrscheinlich funktionieren wird.
Agentische KI könnte deshalb eine neue Konzentration von Verständnismacht erzeugen.
15. Eine doppelte Selbstoffenbarung
Dialogische Selbstoffenbarung
Die KI erfährt:
Sie sieht Fragen, Sorgen, Hoffnungen und Konflikte.
Operative Selbstoffenbarung
Die KI erfährt:
Sie sieht Projekte, Strategien, Fehler, Werkzeuge und Ergebnisse.
Werden sehr viele solcher Prozesse zusammengeführt, entsteht eine dritte Ebene:
Gesellschaftliche Mustererkennung
Das ist vielleicht die tiefste Frage dieses Themas.
16. Ethische Leitfragen
Für Nutzer, Unternehmen, Anbieter und Politik ergeben sich mindestens diese Fragen:
1. Welche Arbeitsdaten muss ein Agent wirklich sehen?
2. Welche davon dürfen gespeichert werden?
3. Welche Metadaten werden zusätzlich erzeugt?
4. Welche aggregierten Analysen führt der Anbieter durch?
5. Werden Inhalte oder Metadaten zum Training verwendet?
6. Welche Daten verlassen die Organisation?
7. Welche Drittanbieter oder Werkzeuge werden einbezogen?
8. Wie werden Geschäftsgeheimnisse geschützt?
9. Können sensible Agenten lokal oder in isolierten Umgebungen betrieben werden?
10. Können Nutzer nachvollziehen, was gespeichert und ausgewertet wird?
11. Wer profitiert von den aggregierten Erkenntnissen?
12. Sollte es Grenzen für die Auswertung von Arbeits- und Intentionsdaten geben?
13. Brauchen wir eine eigene rechtliche Kategorie für operative Intentionsdaten?
14. Welche gesellschaftlich wertvollen Erkenntnisse sollten als Gemeingut verfügbar sein?
17. Praktischer Prüfweg für Organisationen
Vor dem Einsatz eines Agenten für sensible Arbeit sollte mindestens geprüft werden:
A. Daten
Welche Informationen sieht der Agent?
B. Berechtigungen
Auf welche Systeme darf er zugreifen?
C. Speicherung
Was wird wie lange gespeichert?
D. Training
Welche Inhalte dürfen für Modellverbesserung genutzt werden?
E. Metadaten
Welche Nutzungs- und Prozessdaten entstehen zusätzlich?
F. Drittanbieter
Welche externen Tools werden aufgerufen?
G. Geheimnisse
Welche Geschäfts- oder Forschungsgeheimnisse könnten sichtbar werden?
H. Alternativen
Kann der sensible Teil lokal, isoliert oder mit Zero-Data-Retention ausgeführt werden?
I. Kontrolle
Gibt es Audit-Logs, Rollenrechte und Beschwerdewege?
J. Wissen
Welche aggregierten Erkenntnisse entstehen aus der Nutzung – und wer darf sie nutzen?
18. Schluss
Agentische KI ist nicht nur ein neues Werkzeug. Sie kann zu einem neuen Beobachtungsraum menschlicher Arbeit werden.
Die gesellschaftlich wichtige Frage lautet deshalb nicht allein:
sondern zusätzlich:
Und noch grundlegender:
Die Zukunft der Agenten wird deshalb nicht nur durch ihre Fähigkeiten entschieden, sondern auch durch die Regeln dafür,
- was sie sehen dürfen,
- was gespeichert wird,
- was ausgewertet werden darf,
- wem die gewonnenen Erkenntnisse gehören,
- und wie verhindert wird, dass aus technischer Hilfe eine unangemessene Konzentration von Verständnismacht entsteht.
Quellen und weiterführende Hinweise
- [1] OpenAI: Data controls in the OpenAI platform. API-Verarbeitung, Training, Aufbewahrung und Grenzen von Zero Data Retention.
- [2] Anthropic: Is my data used for model training? – kommerzielle Produkte, Standardregel und ausdrücklich übermitteltes Feedback.
- [3] Anthropic: How long do you store my organization’s data? – API-Frist, Produktunterschiede und Ausnahmen.
- [4] Google Workspace: Gemini FAQ for Business – Organisationsschutz und Bedingungen des konkreten Angebots.
- [5] Europäische Union: Datenschutz-Grundverordnung, insbesondere Artikel 3 bis 5. Amtlicher Text zu Anwendungsbereich, personenbezogenen Daten und Verarbeitungsgrundsätzen.
- Unveränderte vollständige Markdown-Originalquelle öffnen oder herunterladen. Die relative Bildreferenz gehört zur ursprünglichen Paketstruktur.
Quellenprüfung: 10. Oktober 2026. Anbieterquellen beschreiben dokumentierte Zusagen; sie sind kein Nachweis für die tatsächliche Einhaltung in jedem Einzelfall. Speicherung, menschlicher Zugriff, Auswertung und Training bleiben getrennte Fragen. Bedingungen können sich ändern.
Grundtext und Infografik stammen aus Hans Hufnagels Paket „KI-Ethos_Agentische-KI_Selbstoffenbarung_Importpaket.zip“. Die Webfassung präzisiert die aktuellen Anbieterbeispiele, kennzeichnet Szenarien und Begriffsvorschläge und ergänzt zugängliche Darstellung sowie vorhandene Querverbindungen. Der ursprüngliche Markdown-Text bleibt unverändert erhalten.
Verwandte Seiten
- Wie arbeiten KI-Agenten zusammen?
- Digitale Begleiter und ihre Einbettung in den Alltag
- Alignment: Ziele, Antwortgrenzen und Mitgestaltung
- Trainingsdaten, Urheberrechte und Wissenskreislauf
- KI prüfen, begrenzen und verantworten
- Superintelligenz als abhängige Macht
- Macht, Eigentum und Wettbewerb
- Zugang, Teilhabe und digitale Gerechtigkeit
- Globale Wissensgrundversorgung
- Beziehungen mit KI: Nähe und Selbstständigkeit
- Offene Fragen der KI-Ethik
<< Wie arbeiten KI-Agenten zusammen? | KI-Navigation | Aktuelle Entwicklungen der KI >>
Zur KI-Übersicht →